Sequence-to-Sequenceモデル
Sequence-to-Sequence(Seq2Seq)モデルは、自然言語処理(NLP)における重要なアーキテクチャの一つであり、ある系列を別の系列に変換するタスクに特化しています。このモデルの中核となる考え方は、可変長の入力系列を受け取り、可変長の出力系列を生成することです。
基本概念
Seq2Seqモデルはエンコーダー-デコーダー(Encoder-Decoder)アーキテクチャ:
- エンコーダー:入力系列を固定長のコンテキストベクトル(context vector)にエンコードする
- デコーダー:コンテキストベクトルに基づいて出力系列を段階的に生成する
典型的な特徴
- 入力系列と出力系列の長さを変えることができる
- 複数の言語間の変換タスクに適用できる
- 可変長の系列データを処理できる
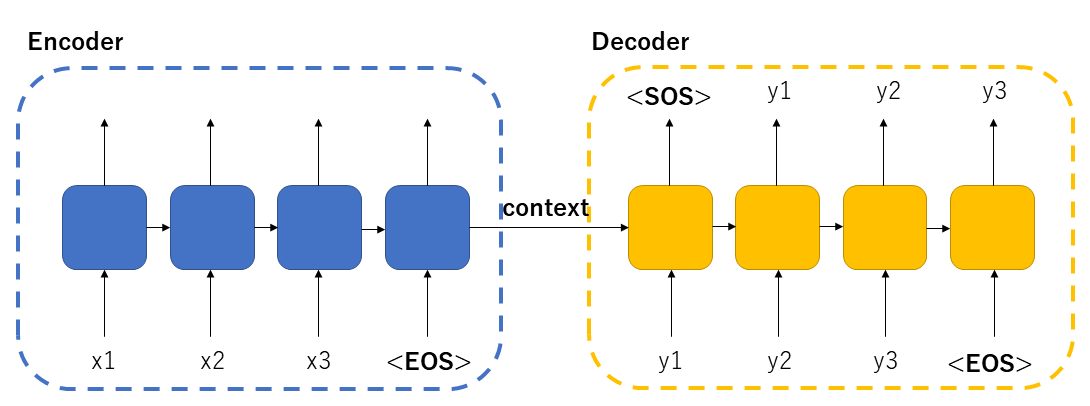
Seq2Seqモデルの中核原理
基本アーキテクチャ構成
エンコーダー(Encoder)
エンコーダーは通常、RNN(LSTMやGRUなど)を使用して入力系列を処理し、系列情報を段階的に隠れ状態へ圧縮し、最終的に入力系列全体を表すコンテキストベクトルを生成します。
デコーダー(Decoder)
デコーダーはコンテキストベクトルから開始し、終了トークンが生成されるまで出力系列の各要素を段階的に生成します。
ワークフロー
- エンコーダーが入力系列を読み取り、コンテキストベクトルを生成する
- デコーダーが隠れ状態をコンテキストベクトルに初期化する
- デコーダーが出力系列の要素を段階的に生成する
- 終了トークンが生成されたら停止する
主要な技術的改善
- アテンション機構(Attention):長い系列の情報喪失問題を解決する
- Transformerアーキテクチャ:自己アテンション機構に完全に基づくSeq2Seqモデル
- Beam Search:デコード戦略を改善し、生成品質を向上させる
実例
# 簡略化したSeq2Seqモデルの疑似コード
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# エンコード段階
hidden = self.encoder(input_seq)
# デコード段階
outputs = self.decoder(hidden)
return outputs
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# エンコード段階
hidden = self.encoder(input_seq)
# デコード段階
outputs = self.decoder(hidden)
return outputs
機械翻訳におけるSeq2Seqの応用
機械翻訳タスクの特徴
- 入力も出力もテキスト系列である
- 2つの言語間の系列長は通常対応しない
- ソース言語を理解し、ターゲット言語を生成する必要がある
代表的な応用事例
- Googleニューラル機械翻訳(GNMT)システム
- FacebookのFairseq翻訳システム
- オープンソースツールOpenNMT
実装のポイント
- 双方向RNNエンコーダーを使用して文脈情報を捕捉する
- アテンション機構を追加して長い文を処理する
- サブワード分割(Subword Tokenization)を採用して希少語を処理する
実例
# 機械翻訳モデルの例
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
attention=DotProductAttention()
)
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
attention=DotProductAttention()
)
テキスト要約におけるSeq2Seqの応用
テキスト要約タスクの分類
| 要約タイプ | 特徴 | Seq2Seqの適用性 |
|---|---|---|
| 抽出型要約 | 原文から重要な文を選ぶ | 適用不可 |
| 生成型要約 | 新しい要約テキストを生成する | 非常に適している |
主要な技術的課題
- 長文書の情報圧縮を処理する
- 要約の一貫性と正確性を維持する
- 同じ内容の重複生成を避ける
解決策
- ポインター生成ネットワーク:抽出と生成の方法を組み合わせる
- カバレッジメカニズム:生成済みの内容を追跡して重複を避ける
- 強化学習:ROUGEなどの要約指標を最適化する
実例
# テキスト要約モデルの例
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
対話生成におけるSeq2Seqの応用
対話システムの種類比較
| タイプ | 特徴 | Seq2Seqの適用性 |
|---|---|---|
| タスク指向型対話 | 特定のタスクを完了する | 限定的に適用可能 |
| 雑談型対話 | オープンドメインの交流 | 非常に適している |
対話生成の特殊性
- 対話の一貫性を維持する必要がある
- 応答は対話の文脈に適合する必要がある
- 汎用的で無意味な返答の生成を避ける
改善方法
- パーソナライズ埋め込み:話者の特徴を追加する
- 感情制御:特定の感情トーンの返答を生成する
- 敵対的トレーニング:返答の自然さを向上させる
実例
# 対話生成モデルの例
chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
Seq2Seqモデルのトレーニングと最適化
トレーニングプロセス
- 対訳コーパスデータセットを準備する
- 損失関数を定義する(通常は交差エントロピー)
- ティーチャーフォーシング(Teacher Forcing)を使用してトレーニングする
- 検証セットでパラメータを調整する
よくある問題と解決策
| 問題 | 原因 | 解決策 |
|---|---|---|
| 勾配消失 | 長い系列の依存関係 | LSTM/GRU、またはTransformerを使用する |
| エクスポージャーバイアス | トレーニングとテストの不一致 | スケジュールドサンプリング(Scheduled Sampling) |
| 汎用的な返答 | 最尤バイアス | 敵対的トレーニングまたは強化学習 |
評価指標
- BLEU:機械翻訳で一般的に使用される指標
- ROUGE:テキスト要約で一般的に使用される指標
- 人手評価:対話システムの重要な補足
まとめと展望
Seq2SeqモデルはNLP分野の中核技術として、当初のシンプルなRNNアーキテクチャから、現在の強力なTransformerモデルへと発展してきました。機械翻訳、テキスト要約、対話生成などのタスクで強力な能力を発揮しています。今後の発展方向には以下が含まれます:
- より効率的な長系列処理
- 少数ショット/ゼロショット学習能力
- マルチモーダル系列変換
- より制御可能なコンテンツ生成
Seq2Seqモデルの原理と応用を理解することで、あなたはNLPにおける強力なツールを習得し、独自の系列変換アプリケーションを構築し始めることができます!
その他の拡張