Sequenz-zu-Sequenz-Modelle
Sequence-to-Sequence-(Seq2Seq)-Modelle sind eine wichtige Architektur in der Verarbeitung natürlicher Sprache (NLP), die speziell für Aufgaben entwickelt wurden, die eine Sequenz in eine andere Sequenz umwandeln. Die Kernidee dieses Modells besteht darin, eine Eingabesequenz variabler Länge zu akzeptieren und eine Ausgabesequenz variabler Länge zu erzeugen.
Grundlegende Konzepte
Seq2Seq-Modelle gehören zurEncoder-Decoder-Architektur:
- Encoder: kodiert die Eingabesequenz in einen Kontextvektor fester Länge
- Decoder: erzeugt die Ausgabesequenz Schritt für Schritt basierend auf dem Kontextvektor
Typische Merkmale
- Die Längen der Eingabe- und Ausgabesequenz können unterschiedlich sein
- Geeignet für Konvertierungsaufgaben zwischen mehreren Sprachen
- Kann Sequenzdaten variabler Länge verarbeiten
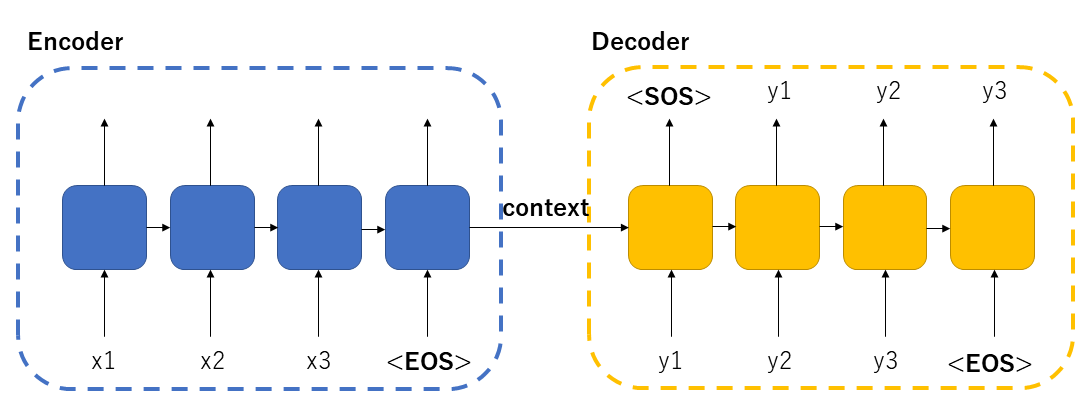
Kernprinzipien von Seq2Seq-Modellen
Grundlegende Architekturkomponenten
Encoder
Der Encoder verwendet typischerweise RNNs (wie LSTM oder GRU), um die Eingabesequenz zu verarbeiten, komprimiert dabei die Sequenzinformationen schrittweise in verborgene Zustände und erzeugt schließlich einen Kontextvektor, der die gesamte Eingabesequenz repräsentiert.
Decoder
Der Decoder startet vom Kontextvektor und generiert jedes Element der Ausgabesequenz Schritt für Schritt, bis er das End-Token erzeugt.
Workflow
- Der Encoder liest die Eingabesequenz und generiert einen Kontextvektor
- Der Decoder initialisiert seinen verborgenen Zustand als den Kontextvektor
- Der Decoder generiert die Elemente der Ausgabesequenz Schritt für Schritt
- Stoppt, wenn das End-Token generiert wird
Wichtige technische Verbesserungen
- Attention-Mechanismus: löst das Problem des Informationsverlusts in langen Sequenzen
- Transformer-Architektur: ein Seq2Seq-Modell, das vollständig auf Self-Attention-Mechanismen basiert
- Beam Search: verbessert Dekodierungsstrategien, um die Generierungsqualität zu erhöhen
Beispiele
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# Kodierungsphase
hidden = self.encoder(input_seq)
# Dekodierungsphase
outputs = self.decoder(hidden)
return outputs
Anwendung von Seq2Seq in der maschinellen Übersetzung
Merkmale von Aufgaben der maschinellen Übersetzung
- Sowohl Eingabe als auch Ausgabe sind Textsequenzen
- Sequenzlängen zwischen zwei Sprachen stimmen normalerweise nicht überein
- Erfordert das Verständnis der Quellsprache und die Generierung der Zielsprache
Typische Anwendungsfälle
- Google-System für neuronale maschinelle Übersetzung (GNMT)
- Facebooks Fairseq-Übersetzungssystem
- Open-Source-Tool OpenNMT
Wichtige Implementierungspunkte
- Bidirektionale RNN-Encoder verwenden, um Kontextinformationen zu erfassen
- Attention-Mechanismen integrieren, um lange Sätze zu verarbeiten
- Subword-Tokenisierung verwenden, um seltene Wörter zu verarbeiten
Beispiele
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
Aufmerksamkeit=DotProductAttention()
)
Anwendung von Seq2Seq bei der Textzusammenfassung
Klassifizierung von Aufgaben der Textzusammenfassung
| Zusammenfassungstyp | Eigenschaften | Seq2Seq-Eignung |
|---|---|---|
| Extraktive Zusammenfassung | Wählt wichtige Sätze aus dem Originaltext aus | Nicht geeignet |
| Abstraktive Zusammenfassung | Erzeugt neuen verdichteten Text | Sehr geeignet |
Zentrale technische Herausforderungen
- Umgang mit der Informationskomprimierung langer Dokumente
- Beibehaltung von Kohärenz und Genauigkeit von Zusammenfassungen
- Vermeidung wiederholter Generierung identischer Inhalte
Lösungen
- Pointer-Generator-Netzwerk: kombiniert extraktive und generative Methoden
- Coverage-Mechanismus: verfolgt generierten Inhalt, um Wiederholungen zu vermeiden
- Bestärkendes Lernen: optimiert Zusammenfassungsmetriken wie ROUGE
Beispiele
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
Anwendung von Seq2Seq in der Dialoggenerierung
Vergleich von Dialogsystemtypen
| Type | Eigenschaften | Seq2Seq-Eignung |
|---|---|---|
| Aufgabenorientierter Dialog | Erfüllt spezifische Aufgaben | Eingeschränkte Eignung |
| Smalltalk-Dialog | Offene-Domänen-Kommunikation | Sehr geeignet |
Spezielle Merkmale der Dialoggenerierung
- Notwendigkeit, die Dialogkohärenz zu wahren
- Antworten sollten zum Dialogkontext passen
- Generische, bedeutungslose Antworten vermeiden
Verbesserungsmethoden
- Personalisiertes Embedding: integriert Sprechermerkmale
- Sentiment-Steuerung: erzeugt Antworten mit bestimmten emotionalen Tonalitäten
- Adversariales Training: verbessert die Natürlichkeit der Antworten
Beispiele
Chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
Training und Optimierung von Seq2Seq-Modellen
Trainingsprozess
- Parallele Korpus-Datensätze vorbereiten
- Verlustfunktion definieren (normalerweise Kreuzentropie)
- Mit Teacher Forcing trainieren
- Hyperparameter mit dem Validierungssatz abstimmen
Häufige Probleme und Lösungen
| Problem | Ursache | Lösung |
|---|---|---|
| Verschwindender Gradient | Lange Sequenzabhängigkeiten | LSTM/GRU oder Transformer verwenden |
| Exposure Bias | Diskrepanz zwischen Training und Test | Scheduled Sampling |
| Generische Antworten | Maximum-Likelihood-Bias | Adversariales Training oder Reinforcement Learning |
Evaluationsmetriken
- BLEU: häufig verwendete Metriken für die maschinelle Übersetzung
- ROUGE: häufig verwendete Metriken für die Textzusammenfassung
- Menschliche Evaluation: eine wichtige Ergänzung für Dialogsysteme
Zusammenfassung und Ausblick
Als Kerntechnologie im NLP-Bereich haben sich Seq2Seq-Modelle von der anfänglichen einfachen RNN-Architektur zu den heutigen leistungsstarken Transformer-Modellen entwickelt. Sie haben starke Fähigkeiten bei Aufgaben wie maschineller Übersetzung, Textzusammenfassung und Dialoggenerierung gezeigt. Zukünftige Entwicklungsrichtungen umfassen:
- Effizientere Verarbeitung langer Sequenzen
- Fähigkeiten zum Few-Shot-/Zero-Shot-Lernen
- Multimodale Sequenzumwandlung
- Kontrollierbarere Inhaltsgenerierung
Durch das Verständnis der Prinzipien und Anwendungen von Seq2Seq-Modellen beherrschen Sie ein leistungsstarkes Werkzeug in der NLP und können mit dem Aufbau eigener Anwendungen zur Sequenzumwandlung beginnen!
Andere Erweiterungen