Modelo Secuencia a Secuencia
El modelo Secuencia a Secuencia (Sequence-to-Sequence, Seq2Seq) es una arquitectura importante en el procesamiento del lenguaje natural (NLP), diseñada específicamente para tareas de conversión de una secuencia a otra. La idea central de este modelo es aceptar una secuencia de entrada de longitud variable y generar una secuencia de salida de longitud variable.
Conceptos básicos
El modelo Seq2Seq pertenece a la arquitecturaCodificador-Decodificador (Encoder-Decoder):
- Codificador: Codifica la secuencia de entrada en un vector de contexto de longitud fija (context vector)
- Decodificador: Genera la secuencia de salida paso a paso basándose en el vector de contexto
Características típicas
- La longitud de las secuencias de entrada y salida puede ser diferente
- Adecuado para tareas de conversión entre múltiples idiomas
- Capaz de procesar datos de secuencias de longitud variable
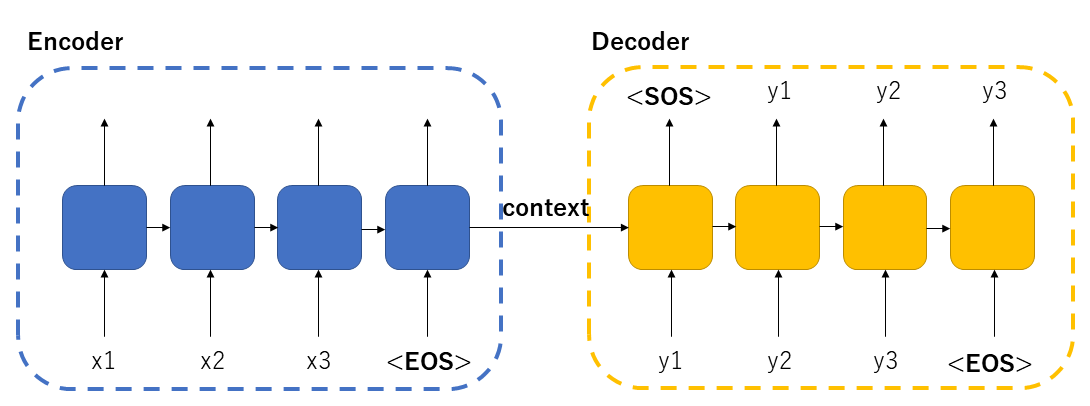
Principios fundamentales del modelo Seq2Seq
Composición de la arquitectura base
Codificador (Encoder)
El codificador generalmente utiliza RNN (como LSTM o GRU) para procesar la secuencia de entrada, comprimiendo gradualmente la información de la secuencia en el estado oculto, y finalmente genera un vector de contexto que representa toda la secuencia de entrada.
Decodificador (Decoder)
El decodificador comienza desde el vector de contexto y genera paso a paso cada elemento de la secuencia de salida, hasta que se produce la marca de fin.
Flujo de trabajo
- El codificador lee la secuencia de entrada y genera el vector de contexto
- El decodificador inicializa el estado oculto como el vector de contexto
- El decodificador genera paso a paso los elementos de la secuencia de salida
- Se detiene cuando se genera la marca de fin
Mejoras técnicas clave
- Mecanismo de atención (Attention): Resuelve el problema de pérdida de información en secuencias largas
- Arquitectura Transformer: Modelo Seq2Seq basado completamente en el mecanismo de autoatención
- Beam Search: Mejora la estrategia de decodificación para aumentar la calidad de generación
Ejemplo
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# Fase de codificación
hidden = self.encoder(input_seq)
# Fase de decodificación
outputs = self.decoder(hidden)
return outputs
Aplicación de Seq2Seq en traducción automática
Características de las tareas de traducción automática
- Tanto la entrada como la salida son secuencias de texto
- La longitud de las secuencias entre dos idiomas generalmente no se corresponde
- Requiere comprender el idioma de origen y generar el idioma de destino
Casos de aplicación típicos
- Sistema de traducción automática neuronal de Google (GNMT)
- Sistema de traducción Fairseq de Facebook
- Herramienta de código abierto OpenNMT
Puntos clave de implementación
- Utilizar codificador RNN bidireccional para capturar información contextual
- Incorporar mecanismo de atención para manejar oraciones largas
- Emplear tokenización por subpalabras (Subword Tokenization) para manejar palabras raras
Ejemplo
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
attention=DotProductAttention()
)
Aplicación de Seq2Seq en resumen de texto
Clasificación de tareas de resumen de texto
| Tipo de resumen | Características | Aplicabilidad de Seq2Seq |
|---|---|---|
| Resumen extractivo | Selecciona oraciones importantes del texto original | No aplicable |
| Resumen generativo | Genera nuevo texto resumido | Muy adecuado |
Desafíos técnicos clave
- Compresión de información de documentos largos
- Mantener la coherencia y precisión del resumen
- Evitar generar repetidamente el mismo contenido
Soluciones
- Red de generación con punteros (Pointer-Generator Network): Combina métodos de extracción y generación
- Mecanismo de cobertura: Realiza seguimiento del contenido generado para evitar repeticiones
- Aprendizaje por refuerzo: Optimiza métricas de resumen como ROUGE
Ejemplo
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
Aplicación de Seq2Seq en generación de diálogos
Comparación de tipos de sistemas de diálogo
| Tipo | Características | Aplicabilidad de Seq2Seq |
|---|---|---|
| Diálogo orientado a tareas | Completar tareas específicas | Aplicabilidad limitada |
| Diálogo informal (charla) | Conversación de dominio abierto | Muy adecuado |
Particularidades de la generación de diálogos
- Necesita mantener la coherencia del diálogo
- Las respuestas deben ser apropiadas al contexto del diálogo
- Evitar generar respuestas genéricas sin significado
Métodos de mejora
- Incrustación de personalización: Añade características del hablante
- Control de emociones: Genera respuestas con un matiz emocional específico
- Entrenamiento adversarial: Mejora la naturalidad de las respuestas
Ejemplo
chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
Entrenamiento y optimización del modelo Seq2Seq
Proceso de entrenamiento
- Preparar el conjunto de datos de corpus paralelo
- Definir la función de pérdida (generalmente entropía cruzada)
- Entrenar utilizando Teacher Forcing
- Ajustar parámetros con el conjunto de validación
Problemas comunes y soluciones
| Problema | Causa | Solución |
|---|---|---|
| Desaparición del gradiente | Dependencia de secuencias largas | Usar LSTM/GRU, o Transformer |
| Sesgo de exposición | Inconsistencia entre entrenamiento y prueba | Muestreo programado (Scheduled Sampling) |
| Respuestas genéricas | Sesgo de máxima verosimilitud | Entrenamiento adversarial o aprendizaje por refuerzo |
Métricas de evaluación
- BLEU: Métrica común para traducción automática
- ROUGE: Métrica común para resumen de texto
- Evaluación humana: Complemento importante para sistemas de diálogo
Resumen y perspectivas
El modelo Seq2Seq, como tecnología central en el campo del NLP, ha evolucionado desde la arquitectura RNN simple original hasta el poderoso modelo Transformer actual. Ha demostrado una gran capacidad en tareas como traducción automática, resumen de texto y generación de diálogos. Las direcciones de desarrollo futuro incluyen:
- Procesamiento más eficiente de secuencias largas
- Capacidad de aprendizaje con pocos ejemplos / cero ejemplos (few-shot / zero-shot)
- Conversión de secuencias multimodales
- Generación de contenido más controlable
Al comprender los principios y aplicaciones del modelo Seq2Seq, ya has dominado una poderosa herramienta en NLP y ¡puedes comenzar a construir tus propias aplicaciones de conversión de secuencias!
Otras extensiones