Python NLPエコシステム
自然言語処理(Natural Language Processing, NLP)は人工知能分野における重要な一分野であり、Pythonはその豊富なツールライブラリによりNLP開発の第一選択言語となっています。
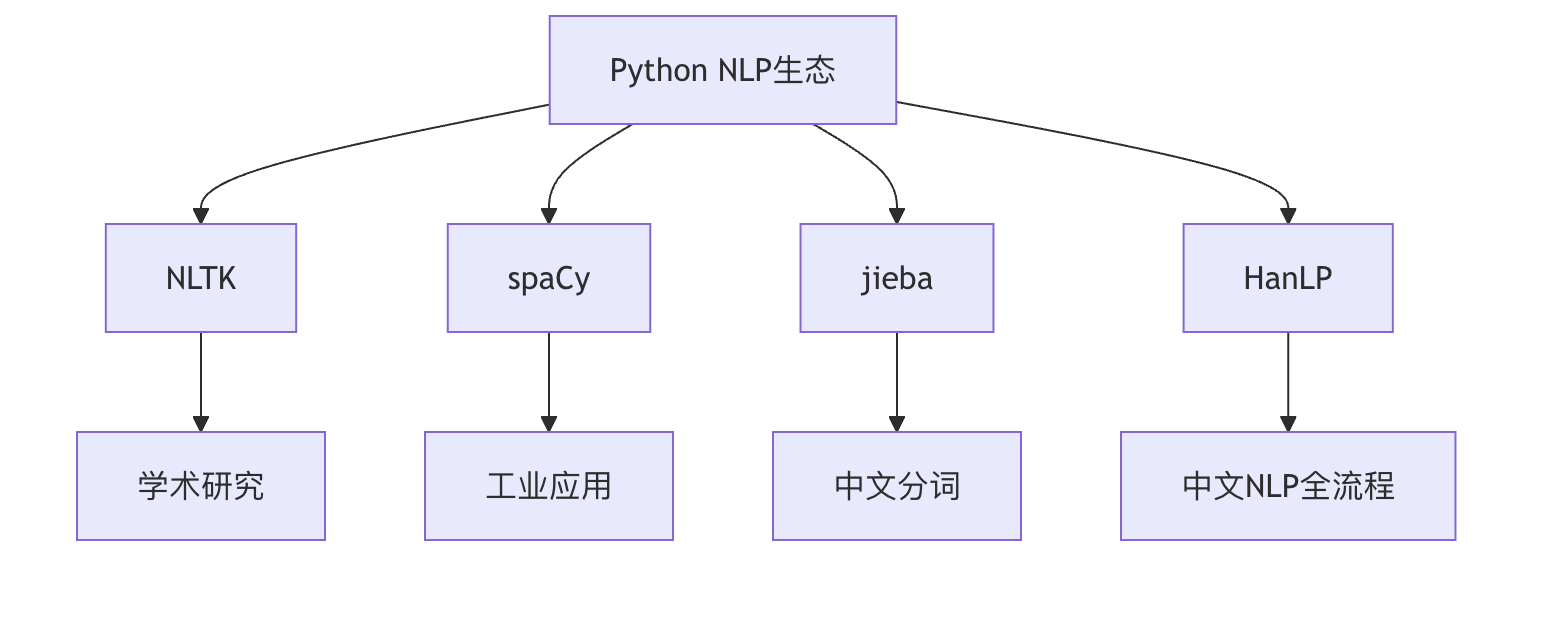
本記事では、Python NLPエコシステムの中核ツールキットを包括的に紹介します:
- NLTK- 学術研究で第一選択となる自然言語処理ツールキット
- spaCy- 産業級の高効率NLPフレームワーク
- jieba- 最も人気のある中国語分詞ツール
- HanLP- 機能が充実した中国語NLP処理ライブラリ
NLTK:自然言語処理のスイスアーミーナイフ
基本紹介
NLTK(Natural Language Toolkit)は最も有名なPython NLPライブラリの1つであり、ペンシルベニア大学によって開発され、教育や研究用途に特に適しています。
コア機能
- テキスト分詞(トークン化)
- 品詞タグ付け(POSタグ付け)
- 固有表現認識(NER)
- 感情分析(センチメント分析)
- ステミング(語幹抽出)とレンマ化(見出し語化)
インストールと基本使用
実例
import nltk
nltk.download('punkt') # 必要なデータパッケージをダウンロード
# 例:テキスト分詞
from nltk.tokenize import word_tokenize
text = "Natural language processing is fascinating."
tokens = word_tokenize(text)
print(tokens) # 出力: ['Natural', 'language', 'processing', 'is', 'fascinating', '.']
nltk.download('punkt') # 必要なデータパッケージをダウンロード
# 例:テキスト分詞
from nltk.tokenize import word_tokenize
text = "Natural language processing is fascinating."
tokens = word_tokenize(text)
print(tokens) # 出力: ['Natural', 'language', 'processing', 'is', 'fascinating', '.']
長所と短所の分析
| 長所 | 短所 |
|---|---|
| 機能が充実しており、NLPの主要タスクをカバー | 実行効率が低い |
| ドキュメントが整備され、学習リソースが豊富 | 追加のデータパッケージのダウンロードが必要 |
| 教育や研究に適している | 中国語のサポートが限定的 |
spaCy:産業級NLPフレームワーク
基本紹介
spaCyは産業アプリケーションに特化したモダンなNLPライブラリであり、その高効率性と使いやすさで知られています。
コア特徴
- 事前学習モデルのサポート
- パイプライン方式の処理メカニズム
- 高性能なニューラルネットワーク実装
- 多言語サポート(中国語を含む)
インストールと基本使用
実例
# 英語モデルのインストール: python -m spacy download en_core_web_sm
# 中国語モデルのインストール: python -m spacy download zh_core_web_sm
import spacy
# 英語モデルをロード
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple is looking at buying U.K. startup for $1 billion")
# 固有表現を抽出
for ent in doc.ents:
print(ent.text, ent.label_)
# 出力: Apple ORG
# U.K. GPE
# $1 billion MONEY
# 中国語モデルのインストール: python -m spacy download zh_core_web_sm
import spacy
# 英語モデルをロード
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple is looking at buying U.K. startup for $1 billion")
# 固有表現を抽出
for ent in doc.ents:
print(ent.text, ent.label_)
# 出力: Apple ORG
# U.K. GPE
# $1 billion MONEY
性能比較
実例
barChart
title NLPライブラリ処理速度比較(語/秒)
x-axis ライブラリ
y-axis 速度
bar NLTK: 10,000
bar spaCy: 100,000
title NLPライブラリ処理速度比較(語/秒)
x-axis ライブラリ
y-axis 速度
bar NLTK: 10,000
bar spaCy: 100,000
jieba:中国語分詞の利器
基本紹介
jiebaは中国語向けに特化して設計された分詞ツールであり、そのシンプルさと高効率・高精度で知られています。
3つの分詞モード
- 正確モード:最も正確な分詞結果
- 全モード:単語になり得るすべての語をスキャン
- 検索エンジンモード:長い単語をさらに分割
基本使用例
実例
import jieba
# 正確モードでの分詞
seg_list = jieba.cut("我爱自然语言处理", cut_all=False)
print("正確モード: " + "/".join(seg_list))
# 出力: 正確モード: 我/爱/自然语言/处理
# カスタム辞書を追加
jieba.load_userdict("userdict.txt") # カスタム辞書ファイル
# 正確モードでの分詞
seg_list = jieba.cut("我爱自然语言处理", cut_all=False)
print("正確モード: " + "/".join(seg_list))
# 出力: 正確モード: 我/爱/自然语言/处理
# カスタム辞書を追加
jieba.load_userdict("userdict.txt") # カスタム辞書ファイル
高度な機能
- キーワード抽出
- 品詞タグ付け
- 並列分詞(大規模テキストの処理速度を向上)
HanLP:ワンストップ中国語NLPソリューション
基本紹介
HanLPは一連のモデルとアルゴリズムで構成されるNLPツールキットであり、自然言語処理の本番環境での応用を普及させることを目指しています。
機能特性
- 複数の分詞モードをサポート
- 固有表現認識
- 依存構文解析
- テキスト分類
- 感情分析
基本使用例
実例
from hanlp import HanLP
# 分詞の例
print(HanLP.segment('你好,欢迎使用HanLP!'))
# 出力: [你好/vl, ,/w, 欢迎/v, 使用/v, HanLP/nx, !/w]
# 依存構文解析
sentence = HanLP.parseDependency("我爱自然语言处理")
print(sentence)
# 分詞の例
print(HanLP.segment('你好,欢迎使用HanLP!'))
# 出力: [你好/vl, ,/w, 欢迎/v, 使用/v, HanLP/nx, !/w]
# 依存構文解析
sentence = HanLP.parseDependency("我爱自然语言处理")
print(sentence)
多言語サポート
HanLPは中国語だけでなく、以下もサポートしています:
- 英語
- 日本語
- 韓国語
- などの多言語
ツール選定ガイド
適用シーン比較
| ツール | 最適な適用シーン | 中国語サポート | 学習曲線 |
|---|---|---|---|
| NLTK | 学術研究、教育 | 限定的 | 中程度 |
| spaCy | 産業応用、本番環境 | 良好 | 緩やか |
| jieba | 中国語分詞タスク | 優秀 | 簡単 |
| HanLP | 複雑な中国語NLPタスク | 優秀 | やや急 |
性能考慮要素
- 処理速度:spaCy > jieba > HanLP > NLTK
- メモリ使用量:HanLP > spaCy > NLTK > jieba
- 精度(中国語):HanLP ≈ jieba > spaCy > NLTK
総合実践ケース:中国語テキスト分析フロー
実例
# 複数のツールを組み合わせた中国語テキスト処理フロー
import jieba
from hanlp import HanLP
import spacy
text = 自然言語処理は人工知能の重要な一分野であり、近年急速に発展しています。
# 1. jiebaを使用して分詞
words = list(jieba.cut(text))
print("分詞結果:", words)
# 2. HanLPを使用して品詞タグ付け
print("\n品詞タグ付け:")
print(HanLP.segment(text))
# 3. spaCyの英語モデルを使用して英語部分を処理
nlp = spacy.load("en_core_web_sm")
doc = nlp("Natural Language Processing is amazing.")
print("\n英語固有表現認識:")
for ent in doc.ents:
print(ent.text, ent.label_)
import jieba
from hanlp import HanLP
import spacy
text = 自然言語処理は人工知能の重要な一分野であり、近年急速に発展しています。
# 1. jiebaを使用して分詞
words = list(jieba.cut(text))
print("分詞結果:", words)
# 2. HanLPを使用して品詞タグ付け
print("\n品詞タグ付け:")
print(HanLP.segment(text))
# 3. spaCyの英語モデルを使用して英語部分を処理
nlp = spacy.load("en_core_web_sm")
doc = nlp("Natural Language Processing is amazing.")
print("\n英語固有表現認識:")
for ent in doc.ents:
print(ent.text, ent.label_)
学習リソースのおすすめ
公式ドキュメント
- NLTK: https://www.nltk.org/
- spaCy: https://spacy.io/
- jieba: https://github.com/fxsjy/jieba
- HanLP: https://hanlp.hankcs.com/
まとめと展望
Python NLPエコシステムは、学術研究から産業応用までの完全なツールチェーンを提供しています。中国語処理において、jiebaとHanLPは不可欠なツールであり、spaCyは多言語サポートと産業導入の面で優れた性能を発揮します。将来のNLPの発展は以下をより重視するでしょう:
- 事前学習言語モデルの応用(BERT、GPTなど)
- マルチモーダル処理能力
- 低リソース言語のサポート
- 解釈可能性と公平性