Python-NLP-Ökosystem
Natural Language Processing (NLP) ist ein wichtiger Zweig der künstlichen Intelligenz. Mit seinem reichhaltigen Bibliotheks-Ökosystem ist Python zur bevorzugten Sprache für die NLP-Entwicklung geworden.
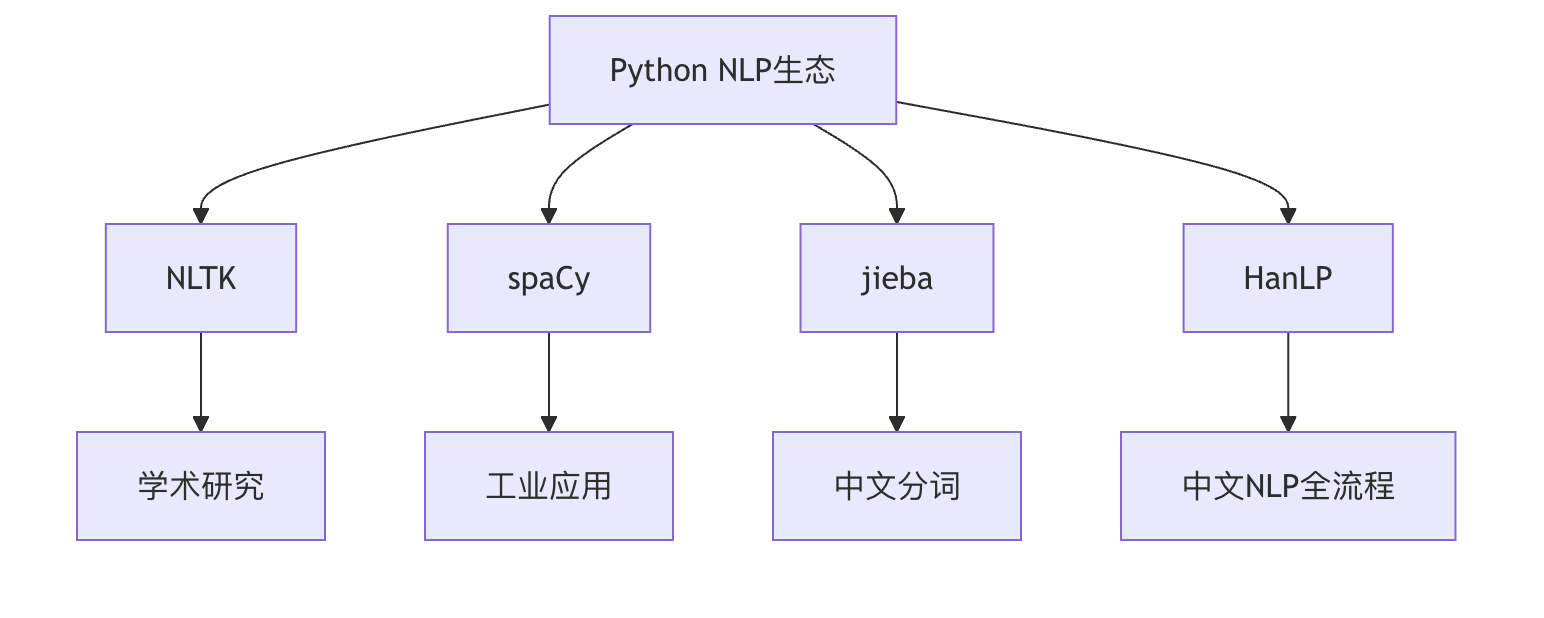
Dieser Artikel bietet eine umfassende Einführung in die zentralen Toolkits im Python-NLP-Ökosystem, darunter:
- NLTK- Das bevorzugte Toolkit zur Verarbeitung natürlicher Sprache für die akademische Forschung
- spaCy- Ein industrietaugliches, effizientes NLP-Framework
- jieba- Das beliebteste chinesische Wortsegmentierungstool
- HanLP- Eine voll funktionsfähige chinesische NLP-Verarbeitungsbibliothek
NLTK: Das Schweizer Taschenmesser der Verarbeitung natürlicher Sprache
Grundlegende Einführung
NLTK (Natural Language Toolkit) ist eine der bekanntesten Python-NLP-Bibliotheken. Sie wurde von der University of Pennsylvania entwickelt und eignet sich besonders für Lehr- und Forschungszwecke.
Kernfunktionen
- Text-Tokenisierung
- Wortarten-Tagging (POS-Tagging)
- Erkennung benannter Entitäten (NER)
- Stimmungsanalyse
- Stemming und Lemmatisierung
Installation und grundlegende Verwendung
Beispiel
nltk.download('punkt') # Notwendige Datenpakete herunterladen
# Beispiel: Text-Tokenisierung
from nltk.tokenize import word_tokenize
text = "Natural language processing is fascinating."
tokens = word_tokenize(text)
print(tokens) # Ausgabe: ['Natural', 'language', 'processing', 'is', 'fascinating', '.']
Vor- und Nachteile-Analyse
| Vorteile | Nachteile |
|---|---|
| Umfassende Funktionalität für die wichtigsten NLP-Aufgaben | Geringere Ausführungseffizienz |
| Gut dokumentiert mit reichhaltigen Lernressourcen | Erfordert das Herunterladen zusätzlicher Datenpakete |
| Geeignet für Lehre und Forschung | Begrenzte Unterstützung für Chinesisch |
spaCy: NLP-Framework in Industriequalität
Grundlegende Einführung
spaCy ist eine moderne NLP-Bibliothek, die sich auf industrielle Anwendungen konzentriert und für ihre Effizienz und Benutzerfreundlichkeit bekannt ist.
Kernfunktionen
- Unterstützung für vortrainierte Modelle
- Pipeline-basierter Verarbeitungsmechanismus
- Hochleistungsfähige Implementierung neuronaler Netzwerke
- Mehrsprachige Unterstützung (einschließlich Chinesisch)
Installation und grundlegende Verwendung
Beispiel
# Chinesisches Modell installieren: python -m spacy download zh_core_web_sm
import spacy
# Englisches Modell laden
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple erwägt, ein U.K.-Startup für $1 billion zu kaufen")
# Benannte Entitäten extrahieren
for ent in doc.ents:
print(ent.text, ent.label_)
# Ausgabe: Apple ORG
# U.K. GPE
# $1 billion MONEY
Leistungsvergleich
Beispiel
title Vergleich der Verarbeitungsgeschwindigkeit von NLP-Bibliotheken (words/second)
x-axis Bibliothek
y-axis Geschwindigkeit
bar NLTK: 10,000
Balken spaCy: 100,000
jieba: Ein leistungsstarkes Tool für die chinesische Wortsegmentierung
Grundlegende Einführung
jieba ist ein Wortsegmentierungswerkzeug, das speziell für Chinesisch entwickelt wurde und für seine Benutzerfreundlichkeit, Effizienz und Genauigkeit bekannt ist.
Drei Wortsegmentierungsmodi
- Präziser Modus: Das genaueste Segmentierungsergebnis
- Vollständiger Modus: Durchsucht alle möglichen Wortbildungen
- Suchmaschinenmodus: Zerlegt lange Wörter weiter
Grundlegende Anwendungsbeispiele
Beispiel
# Tokenisierung im präzisen Modus
seg_list = jieba.cut("I love natural language processing", cut_all=False)
print("Precise mode: " + "/".join(seg_list))
# Ausgabe: Precise Mode: I/love/natural language/processing
# Benutzerdefiniertes Wörterbuch hinzufügen
jieba.load_userdict("userdict.txt") # Benutzerdefinierte Wörterbuchdatei
Erweiterte Funktionen
- Schlüsselwortextraktion
- Wortarten-Tagging
- Parallele Wortsegmentierung (verbessert die Verarbeitungsgeschwindigkeit für große Texte)
HanLP: Eine Komplettlösung für chinesische NLP
Grundlegende Einführung
HanLP ist ein NLP-Toolkit, bestehend aus einer Reihe von Modellen und Algorithmen, mit dem Ziel, die Anwendung der Verarbeitung natürlicher Sprache in Produktionsumgebungen zu fördern.
Funktionen und Eigenschaften
- Unterstützt mehrere Wortsegmentierungsmodi
- Erkennung benannter Entitäten
- Dependenzparsing
- Text-Klassifizierung
- Stimmungsanalyse
Grundlegende Anwendungsbeispiele
Beispiel
# Beispiel für Wortsegmentierung
print(HanLP.segment('Hello, welcome to HanLP!'))
# Ausgabe: [hello/vl, ,/w, welcome/v, use/v, HanLP/nx, !/w]
# Abhängigkeitsanalyse
sentence = HanLP.parseDependency("I love natural language processing")
print(sentence)
Mehrsprachige Unterstützung
HanLP unterstützt nicht nur Chinesisch, sondern auch:
- Englisch
- Japanisch
- Koreanisch
- und viele weitere Sprachen
Leitfaden zur Tool-Auswahl
Vergleich von Anwendungsszenarien
| Tool | Am besten geeignete Anwendungsfälle | Chinesisch-Unterstützung | Lernkurve |
|---|---|---|---|
| NLTK | Akademische Forschung, Lehre | Eingeschränkt | Moderat |
| spaCy | Industrielle Anwendungen, Produktionsumgebungen | Gut | Gentle |
| jieba | Chinesische Wortsegmentierungsaufgaben | Ausgezeichnet | Einfach |
| HanLP | Komplexe chinesische NLP-Aufgaben | Ausgezeichnet | Steiler |
Leistungsüberlegungen
- Verarbeitungsgeschwindigkeit:spaCy > jieba > HanLP > NLTK
- Speicherverbrauch:HanLP > spaCy > NLTK > jieba
- Genauigkeit(Chinesisch): HanLP ≈ jieba > spaCy > NLTK
Umfassender praktischer Fall: Pipeline zur chinesischen Textanalyse
Beispiel
import jieba
from hanlp import HanLP
import spacy
text = "Die Verarbeitung natürlicher Sprache ist ein wichtiger Zweig der künstlichen Intelligenz und hat sich in den letzten Jahren schnell entwickelt."
# 1. Verwende jieba für die Wortsegmentierung
words = list(jieba.cut(text))
print("Tokenisierungsergebnis:", words)
# 2. HanLP für Part-of-Speech-Tagging verwenden
print("\nPart-of-Speech-Tagging:")
print(HanLP.segment(text))
# 3. Verwende das englische Modell von spaCy, um den englischen Teil zu verarbeiten
nlp = spacy.load("en_core_web_sm")
doc = nlp("Die Verarbeitung natürlicher Sprache ist erstaunlich.")
print("\nEnglische Entitätserkennung:")
for ent in doc.ents:
print(ent.text, ent.label_)
Empfohlene Lernressourcen
Offizielle Dokumentation
- NLTK: https://www.nltk.org/
- spaCy: https://spacy.io/
- jieba: https://github.com/fxsjy/jieba
- HanLP: https://hanlp.hankcs.com/
Zusammenfassung und Ausblick
Das Python-NLP-Ökosystem bietet eine vollständige Toolchain, die von der akademischen Forschung bis hin zu industriellen Anwendungen reicht. Für die chinesische Textverarbeitung sind jieba und HanLP unverzichtbare Werkzeuge, während spaCy bei der Mehrsprachigkeitsunterstützung und dem industriellen Einsatz hervorsticht. Die zukünftige NLP-Entwicklung wird größeren Wert auf Folgendes legen:
- Anwendung vortrainierter Sprachmodelle (wie BERT, GPT)
- Multimodale Verarbeitungsfähigkeiten
- Unterstützung für Sprachen mit geringen Ressourcen
- Interpretierbarkeit und Fairness