Ecosistema de Python NLP
El procesamiento del lenguaje natural (Natural Language Processing, NLP) es una rama importante del campo de la inteligencia artificial. Python, gracias a su rico ecosistema de bibliotecas, se ha convertido en el lenguaje preferido para el desarrollo de NLP.
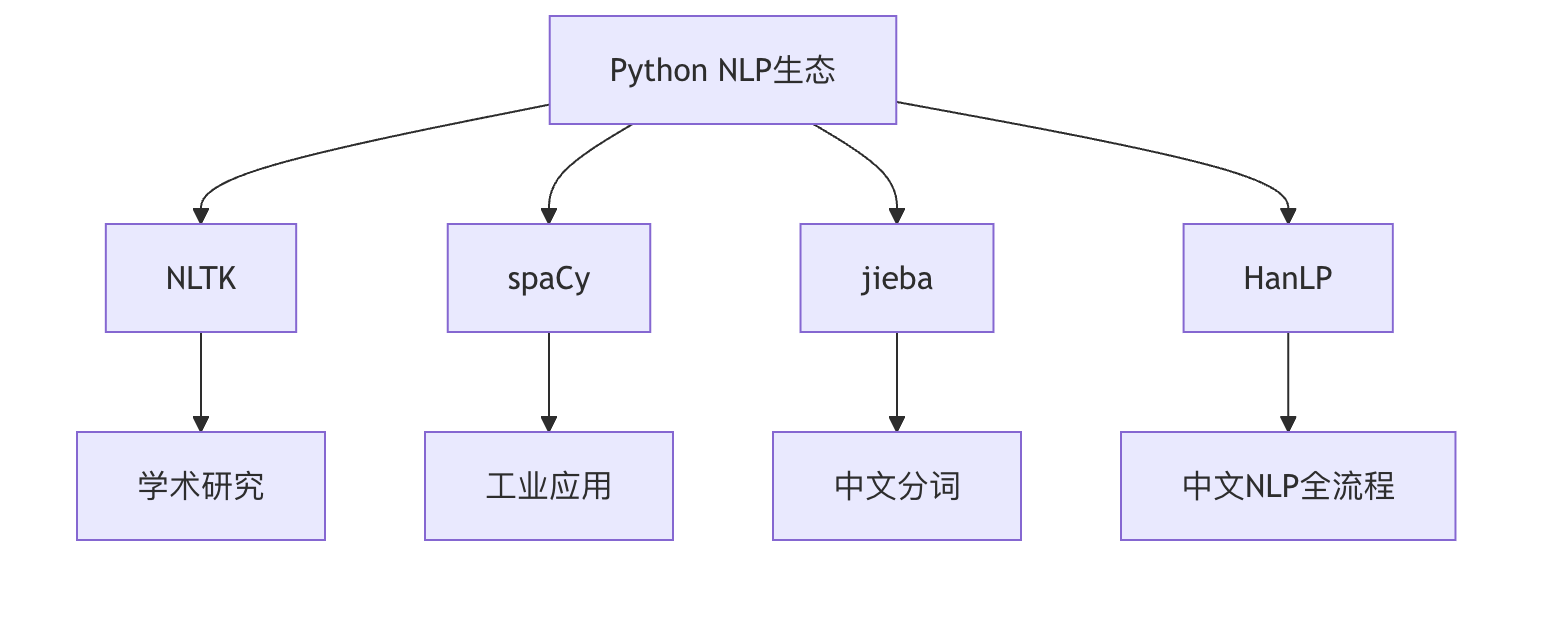
Este artículo presentará de forma integral los paquetes de herramientas principales del ecosistema de Python NLP, incluyendo:
- NLTK- El paquete de herramientas de NLP preferido para la investigación académica
- spaCy- Framework de NLP de nivel industrial y alta eficiencia
- jieba- La herramienta de segmentación de chino más popular
- HanLP- Biblioteca de procesamiento de NLP en chino con funciones completas
NLTK: la navaja suiza del procesamiento del lenguaje natural
Introducción básica
NLTK (Natural Language Toolkit) es una de las bibliotecas de Python NLP más famosas, desarrollada por la Universidad de Pensilvania. Es especialmente adecuada para fines educativos y de investigación.
Funciones principales
- Segmentación de texto (Tokenización)
- Etiquetado de partes de la oración (POS Tagging)
- Reconocimiento de entidades nombradas (NER)
- Análisis de sentimientos (Sentiment Analysis)
- Derivación de raíces (Stemming) y lematización (Lemmatization)
Instalación y uso básico
Ejemplo
nltk.download('punkt') # Descargar los paquetes de datos necesarios
# Ejemplo: segmentación de texto
from nltk.tokenize import word_tokenize
text = "Natural language processing is fascinating."
tokens = word_tokenize(text)
print(tokens) # Salida: ['Natural', 'language', 'processing', 'is', 'fascinating', '.']
Análisis de ventajas y desventajas
| Ventajas | Desventajas |
|---|---|
| Funciones completas que cubren las principales tareas de NLP | Menor eficiencia de ejecución |
| Documentación completa y abundantes recursos de aprendizaje | Requiere descargar paquetes de datos adicionales |
| Adecuado para la enseñanza y la investigación | Soporte limitado para chino |
spaCy: framework de NLP de nivel industrial
Introducción básica
spaCy es una biblioteca de NLP moderna enfocada en aplicaciones industriales, conocida por su alta eficiencia y facilidad de uso.
Características principales
- Soporte de modelos preentrenados
- Mecanismo de procesamiento en pipeline
- Implementación de redes neuronales de alto rendimiento
- Soporte multilingüe (incluido el chino)
Instalación y uso básico
Ejemplo
# Instalar el modelo en chino: python -m spacy download zh_core_web_sm
import spacy
# Cargar el modelo en inglés
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple is looking at buying U.K. startup for $1 billion")
# Extraer entidades nombradas
for ent in doc.ents:
print(ent.text, ent.label_)
# Salida: Apple ORG
# U.K. GPE
# $1 billion MONEY
Comparación de rendimiento
Ejemplo
title Comparación de velocidad de procesamiento de bibliotecas NLP (palabras/segundo)
x-axis Biblioteca
y-axis Velocidad
bar NLTK: 10,000
bar spaCy: 100,000
jieba: herramienta eficaz para la segmentación de palabras chinas
Introducción básica
jieba es una herramienta de segmentación diseñada específicamente para el chino, conocida por su simplicidad, facilidad de uso y alta precisión y eficiencia.
Tres modos de segmentación
- Modo preciso: el resultado de segmentación más preciso
- Modo completo: escanea todas las palabras posibles
- Modo de motor de búsqueda: vuelve a segmentar las palabras largas
Ejemplos de uso básico
Ejemplo
# Segmentación en modo preciso
seg_list = jieba.cut("Me encanta el procesamiento del lenguaje natural", cut_all=False)
print("Modo preciso: " + "/".join(seg_list))
# Salida: Modo preciso: yo/amo/lenguaje natural/procesamiento
# Añadir diccionario personalizado
jieba.load_userdict("userdict.txt") # Archivo de diccionario personalizado
Funciones avanzadas
- Extracción de palabras clave
- Etiquetado de partes de la oración
- Segmentación paralela (mejora la velocidad de procesamiento de textos grandes)
HanLP: solución integral de NLP para chino
Introducción básica
HanLP es un conjunto de herramientas de NLP compuesto por una serie de modelos y algoritmos, cuyo objetivo es popularizar la aplicación del procesamiento del lenguaje natural en entornos de producción.
Características y funciones
- Soporta múltiples modos de segmentación
- Reconocimiento de entidades nombradas
- Análisis de dependencias sintácticas
- Clasificación de textos
- Análisis de sentimientos
Ejemplos de uso básico
Ejemplo
# Ejemplo de segmentación
print(HanLP.segment('¡Hola, bienvenido a HanLP!'))
# Salida: [hola/vl, ,/w, acoger/v, usar/v, HanLP/nx, !/w]
# Análisis de dependencias sintácticas
sentence = HanLP.parseDependency("Me encanta el procesamiento del lenguaje natural")
print(sentence)
Soporte multilingüe
HanLP no solo admite chino, sino también:
- Inglés
- Japonés
- Coreano
- entre otros idiomas
Guía de selección de herramientas
Comparación de escenarios de aplicación
| Herramienta | Mejor escenario de aplicación | Soporte de chino | Curva de aprendizaje |
|---|---|---|---|
| NLTK | Investigación académica, enseñanza | Limitado | Media |
| spaCy | Aplicaciones industriales, entornos de producción | Bueno | Suave |
| jieba | Tareas de segmentación de chino | Excelente | Sencillo |
| HanLP | Tareas complejas de NLP en chino | Excelente | Más pronunciada |
Factores a considerar en el rendimiento
- Velocidad de procesamiento:spaCy > jieba > HanLP > NLTK
- Uso de memoria:HanLP > spaCy > NLTK > jieba
- Precisión(para chino): HanLP ≈ jieba > spaCy > NLTK
Caso práctico integral: flujo de análisis de texto en chino
Ejemplo
import jieba
from hanlp import HanLP
import spacy
text = El procesamiento del lenguaje natural es una rama importante de la inteligencia artificial, y se ha desarrollado rápidamente en los últimos años.
# 1. Usar jieba para la segmentación
words = list(jieba.cut(text))
print("Resultado de segmentación:", words)
# 2. Usar HanLP para el etiquetado de partes de la oración
print("\nEtiquetado gramatical:")
print(HanLP.segment(text))
# 3. Usar el modelo de inglés de spaCy para procesar la parte en inglés
nlp = spacy.load("en_core_web_sm")
doc = nlp("Natural Language Processing is amazing.")
print("\nReconocimiento de entidades en inglés:")
for ent in doc.ents:
print(ent.text, ent.label_)
Recursos de aprendizaje recomendados
Documentación oficial
- NLTK: https://www.nltk.org/
- spaCy: https://spacy.io/
- jieba: https://github.com/fxsjy/jieba
- HanLP: https://hanlp.hankcs.com/
Resumen y perspectivas
El ecosistema de Python NLP ofrece una cadena de herramientas completa que abarca desde la investigación académica hasta las aplicaciones industriales. Para el procesamiento en chino, jieba y HanLP son herramientas indispensables, mientras que spaCy destaca en el soporte multilingüe y el despliegue industrial. El desarrollo futuro de NLP prestará más atención a:
- La aplicación de modelos de lenguaje preentrenados (como BERT, GPT)
- La capacidad de procesamiento multimodal
- El soporte para idiomas con pocos recursos
- La explicabilidad y la equidad