Multimodale vortrainierte Modelle
Multimodale vortrainierte Modelle bezeichnen Deep-Learning-Modelle, die gleichzeitigmehrere Datenmodalitäten(wie Text, Bilder, Audio usw.) verarbeiten und verstehen können. Im Gegensatz zu traditionellen unimodalen Modellen lernen diese Modelle die Assoziationen und Entsprechungen zwischen verschiedenen Modalitäten durch umfangreiches Vortraining.
Kernvorteile des multimodalen Lernens
- Komplementäre Informationen: Verschiedene Modalitäten können komplementäre Informationen liefern (z. B. liefern Bilder visuelle Informationen, Text liefert semantische Informationen)
- Erhöhte Robustheit: Wenn Daten einer Modalität fehlen oder von schlechter Qualität sind, können andere Modalitäten Unterstützung bieten
- Erweiterte Anwendungsszenarien: Unterstützt reichhaltigere modalitätsübergreifende Aufgaben (wie Bild-Text-Retrieval, Bildbeschriftung usw.)
CLIP: Ein Meilenstein im kontrastiven Bild-Text-Lernen
Grundlegende Konzepte
CLIP (Contrastive Language-Image Pre-training) ist ein multimodales Modell, das 2021 von OpenAI vorgeschlagen wurde und durch kontrastives Lernen Assoziationen zwischen Bildern und Text herstellt.
CLIP besteht aus zwei Kernkomponenten:
- Bild-Encoder: Wandelt Bilder in Merkmalsvektoren um (z. B. unter Verwendung von Vision Transformer oder ResNet).
- Text-Encoder: Wandelt Textbeschreibungen in Merkmalsvektoren um (z. B. unter Verwendung von Transformer).
Workflow:
- Eingabe:
- Bild-Text-Paare (z. B. ein Foto eines Hundes + die Beschreibung "ein Foto eines Hundes").
- Kodierung:
- Der Bild-Encoder extrahiert Bildmerkmale, und der Text-Encoder extrahiert Textmerkmale.
- Kontrastives Lernen:
- Berechnen Sie eine Ähnlichkeitsmatrix für alle Bild-Text-Paare und optimieren Sie das Modell mit einer Verlustfunktion (wie InfoNCE), sodass Merkmale zugehöriger Paare zusammengeführt und Merkmale nicht zugehöriger Paare auseinandergezogen werden.
Die von beiden Encodern ausgegebenen Merkmalsvektoren werden in denselben semantischen Raum abgebildet, wodurch Bild- und Textrepräsentationen durch kontrastives Lernen ausgerichtet werden.
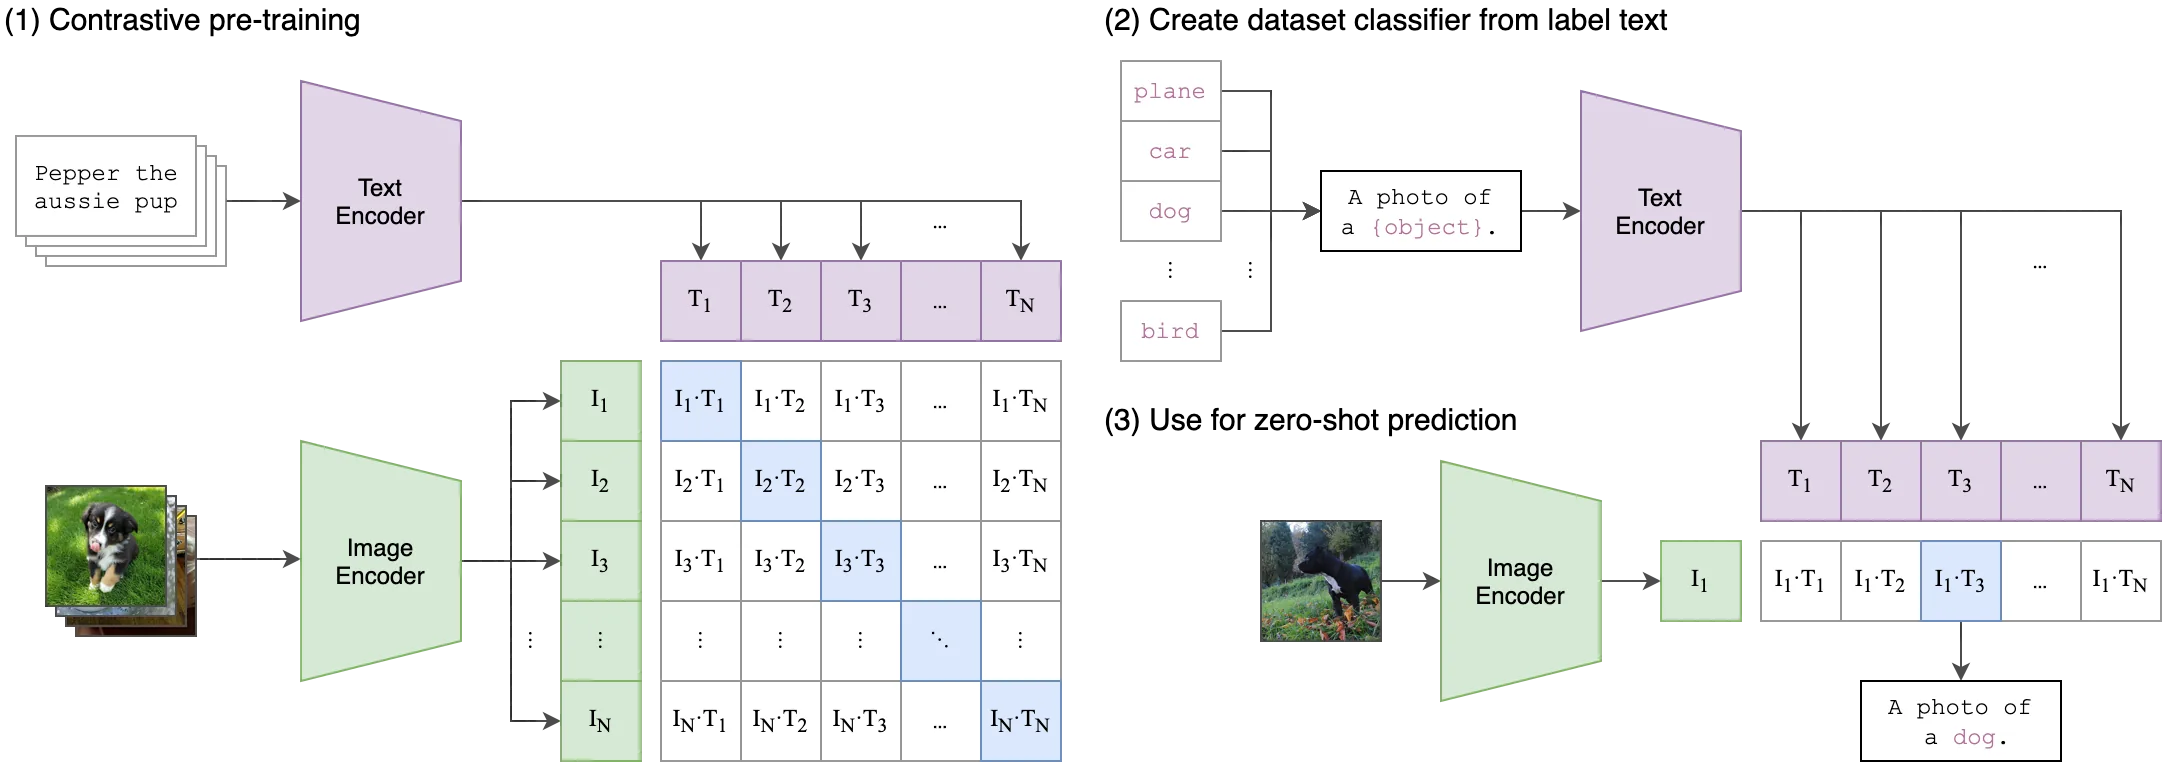
Erklärung der wichtigsten Teile in der Abbildung
Tabellenabschnitt: Matrix des kontrastiven Lernens
Die Tabelle zeigt die Ähnlichkeitsberechnung für Bild-Text-Paare (angenommen, es gibtNTexte und4Bilder):
- Zeilen (Bilder):
I1, I2, I3, I4Repräsentieren unterschiedliche Bildmerkmale. - Spalten (Texte):
T1, T2, ..., TNRepräsentieren unterschiedliche Textmerkmale. - Zellwerte(e.g.,
I1-T1): Die Kosinusähnlichkeit zwischen den Merkmalsvektoren von BildI1und TextT1.
Ziel:
Die Ähnlichkeit auf der Diagonalen maximieren (korrekte Paare, z. B.,I1-T1), und die Ähnlichkeit außerhalb der Diagonalen minimieren (inkorrekte Paare, z. B.,I1-T2). Dies ist die Kernidee des kontrastiven Lernens.
Beispielabschnitt
- Bildbeispiele:
- "Pepper the aussie pup" (ein Foto eines Australian-Shepherd-Welpen).
- "Planer car dog" (möglicherweise Rauschen oder eine falsche Annotation; eigentlich sollte es sich um den Vorlagentext von "A photo of a (object)" handeln).
- Textvorlage:
- "A photo of a (object)" ist eine häufig verwendete Text-Prompt-Vorlage während des CLIP-Pretrainings, die verwendet wird, um über verschiedene Kategorien hinweg zu generalisieren (z. B. "a photo of a dog").
Modellarchitektur
- Dual-Encoder-Architektur:
- Bild-Encoder: Typischerweise Vision Transformer (ViT) oder ResNet
- Text-Encoder: Basierend auf der Transformer-Architektur
- Kontrastives Lernziel:
- Positive Paare (zusammengehörige Bild-Text-Paare) sind im Merkmalsraum nahe beieinander
- Negative Paare (nicht zusammengehörige Bild-Text-Paare) sind im Merkmalsraum weit voneinander entfernt
Trainingsprozess
Beispiel
image_features = image_encoder(image_batch) # Bildmerkmalsextraktion
text_features = text_encoder(text_batch) # Textmerkmalsextraktion
# Ähnlichkeitsmatrix berechnen
logits = torch.matmul(image_features, text_features.T) * temperature
labels = torch.arange(batch_size) # Die Diagonale enthält positive Beispiele
# Symmetrischer kontrastiver Verlust
loss_img = cross_entropy(logits, labels)
loss_txt = cross_entropy(logits.T, labels)
total_loss = (loss_img + loss_txt)/2
Anwendungsszenarien
- Zero-Shot-Bildklassifizierung: Neue Kategorien ohne Fine-Tuning klassifizieren
- Bild-Text-Retrieval: Effiziente Text-zu-Bild- oder Bild-zu-Text-Suche ermöglichen
- Inhaltsmoderation: Bildinhalte identifizieren, die nicht zu Textbeschreibungen passen
DALL-E: Die Magie der Text-zu-Bild-Generierung
Grundlegende Konzepte
DALL-E ist ein von OpenAI entwickeltes Text-zu-Bild-Generierungsmodell, das hochwertige Bilder aus Beschreibungen in natürlicher Sprache erzeugen kann.
Technische Merkmale
Zweistufiges Training:
- Stufe 1: Ein diskreter Variational-Autoencoder (dVAE) komprimiert Bilder zu visuellen Tokens
- Stufe 2: Ein autoregressiver Transformer lernt die Abbildung von Text auf visuelle Tokens
Wichtige Innovationen:
- Bildgenerierung als ein Sequenzvorhersageproblem behandeln
- Verwendet ein Transformer-Modell mit 12 Milliarden Parametern
Beispielhafter Generierungsprozess
Beispiel
text = "Ein Shiba Inu in einem Raumanzug, der auf einer Raumstation ein Videospiel spielt"
text_tokens = tokenizer(text) # Textkodierung
image_tokens = transformer.generate(text_tokens) # Visuelle Tokens generieren
image = dvae.decode(image_tokens) # In ein Bild dekodieren
Modell-Evolution
| Version | Wesentliche Verbesserungen | Generierungsfähigkeit |
|---|---|---|
| DALL-E 1 | Basisarchitektur | 256x256-Auflösung |
| DALL-E 2 | Diffusionsmodell | 1024x1024-Auflösung, präziser |
| DALL-E 3 | Mit ChatGPT integriert | Komplexeres Prompt-Verständnis |
Weitere wichtige multimodale Modelle
ALIGN(Google)
- Trainiert auf verrauschten Daten im Web-Maßstab
- Demonstrierte die Effektivität umfangreicher schwach überwachter Daten
Flamingo(DeepMind)
- Verarbeitet verschachtelte multimodale Sequenzen (z. B. abwechselnd Text und Bilder)
- Unterstützt Few-Shot-Lernen
BEiT-3(Microsoft)
- Einheitliches multimodales Pre-Training-Framework
- Erzielt hervorragende Leistungen bei Bild-, Text- und Vision-Language-Aufgaben
Herausforderungen bei der Anwendung multimodaler Modelle
- Datenanforderungen: Erfordert enorme Mengen hochwertiger, multimodal ausgerichteter Daten
- Rechenkosten: Das Training dieser Modelle erfordert enorme Rechenressourcen
- Bewertungsschwierigkeiten: Fehlende einheitliche Bewertungsstandards für multimodale Aufgaben
- Bias-Probleme: Können soziale Verzerrungen in den Trainingsdaten verstärken
Praxisübung: Zero-Shot-Klassifikation mit CLIP
Beispiel
import torch
from PIL import Image
# Modell laden und Vorverarbeitung
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)
# Eingaben vorbereiten
image = preprocess(Image.open("dog.jpg")).unsqueeze(0).to(device)
text_inputs = clip.tokenize(["a dog", "a cat", "ein Vogel"]).to(device)
# Merkmale berechnen
with torch.no_grad():
image_features = model.encode_image(image)
text_features = model.encode_text(text_inputs)
# Ähnlichkeit berechnen
logits = (image_features @ text_features.T).softmax(dim=-1)
print("Vorhergesagte Wahrscheinlichkeiten:", logits.cpu().numpy())
Zukünftige Entwicklungsrichtungen
- Effizientere Architekturen: Rechenkosten senken und Inferenzgeschwindigkeit verbessern
- Mehr Modalitätsfusion: Weitere Modalitäten wie Audio und Video einbeziehen
- Fähigkeit zum kausalen Verständnis: Das tiefe Verständnis des Modells für multimodale Inhalte verbessern
- Kontrollierbare Generierung: Präzise Steuerung und Editierbarkeit generierter Inhalte verbessern
Multimodale vortrainierte Modelle verändern die Art und Weise, wie Menschen mit Maschinen interagieren. Von CLIPs modalübergreifendem Verständnis bis hin zu DALL-Es kreativer Generierung eröffnen diese Technologien völlig neue Möglichkeiten für KI-Anwendungen.
Andere Erweiterungen