Modèles pré-entraînés multimodaux
Les modèles pré-entraînés multimodaux désignent des modèles d'apprentissage profond qui peuvent simultanément traiter et comprendreplusieurs modalités de données(comme le texte, les images, l'audio, etc.). Contrairement aux modèles unimodaux traditionnels, ces modèles apprennent les associations et les correspondances entre différentes modalités grâce à un pré-entraînement à grande échelle.
Principaux avantages de l'apprentissage multimodal
- Informations complémentaires: Différentes modalités peuvent fournir des informations complémentaires (par exemple, les images fournissent des informations visuelles, le texte fournit des informations sémantiques)
- Robustesse améliorée: Lorsque les données d’une modalité sont manquantes ou de mauvaise qualité, d’autres modalités peuvent apporter un soutien
- Scénarios d’application élargis: Prend en charge des tâches intermodales plus riches (telles que la recherche d’images par texte, le légendage d’images, etc.)
CLIP : Un jalon dans l’apprentissage contrastif image-texte
Concepts de base
CLIP (Contrastive Language-Image Pre-training) est un modèle multimodal proposé par OpenAI en 2021 qui établit des associations entre les images et le texte grâce à l’apprentissage contrastif.
CLIP se compose de deux composants essentiels :
- Encodeur d’images: Convertit les images en vecteurs de caractéristiques (par exemple, à l’aide de Vision Transformer ou ResNet).
- Encodeur de texte: Convertit les descriptions textuelles en vecteurs de caractéristiques (par exemple, à l’aide de Transformer).
Flux de travail :
- Entrée:
- Paires image-texte (par exemple, une photo d’un chien + la description "une photo d’un chien").
- Encodage:
- L’encodeur d’images extrait les caractéristiques des images, et l’encodeur de texte extrait les caractéristiques du texte.
- Apprentissage contrastif:
- Calculer une matrice de similarité pour toutes les paires image-texte et optimiser le modèle à l'aide d'une fonction de perte (telle que InfoNCE), de sorte que les caractéristiques des paires appariées soient rapprochées et que celles des paires non appariées soient éloignées.
Les vecteurs de caractéristiques produits par les deux encodeurs sont projetés dans le même espace sémantique, ce qui aligne les représentations d'image et de texte par apprentissage contrastif.
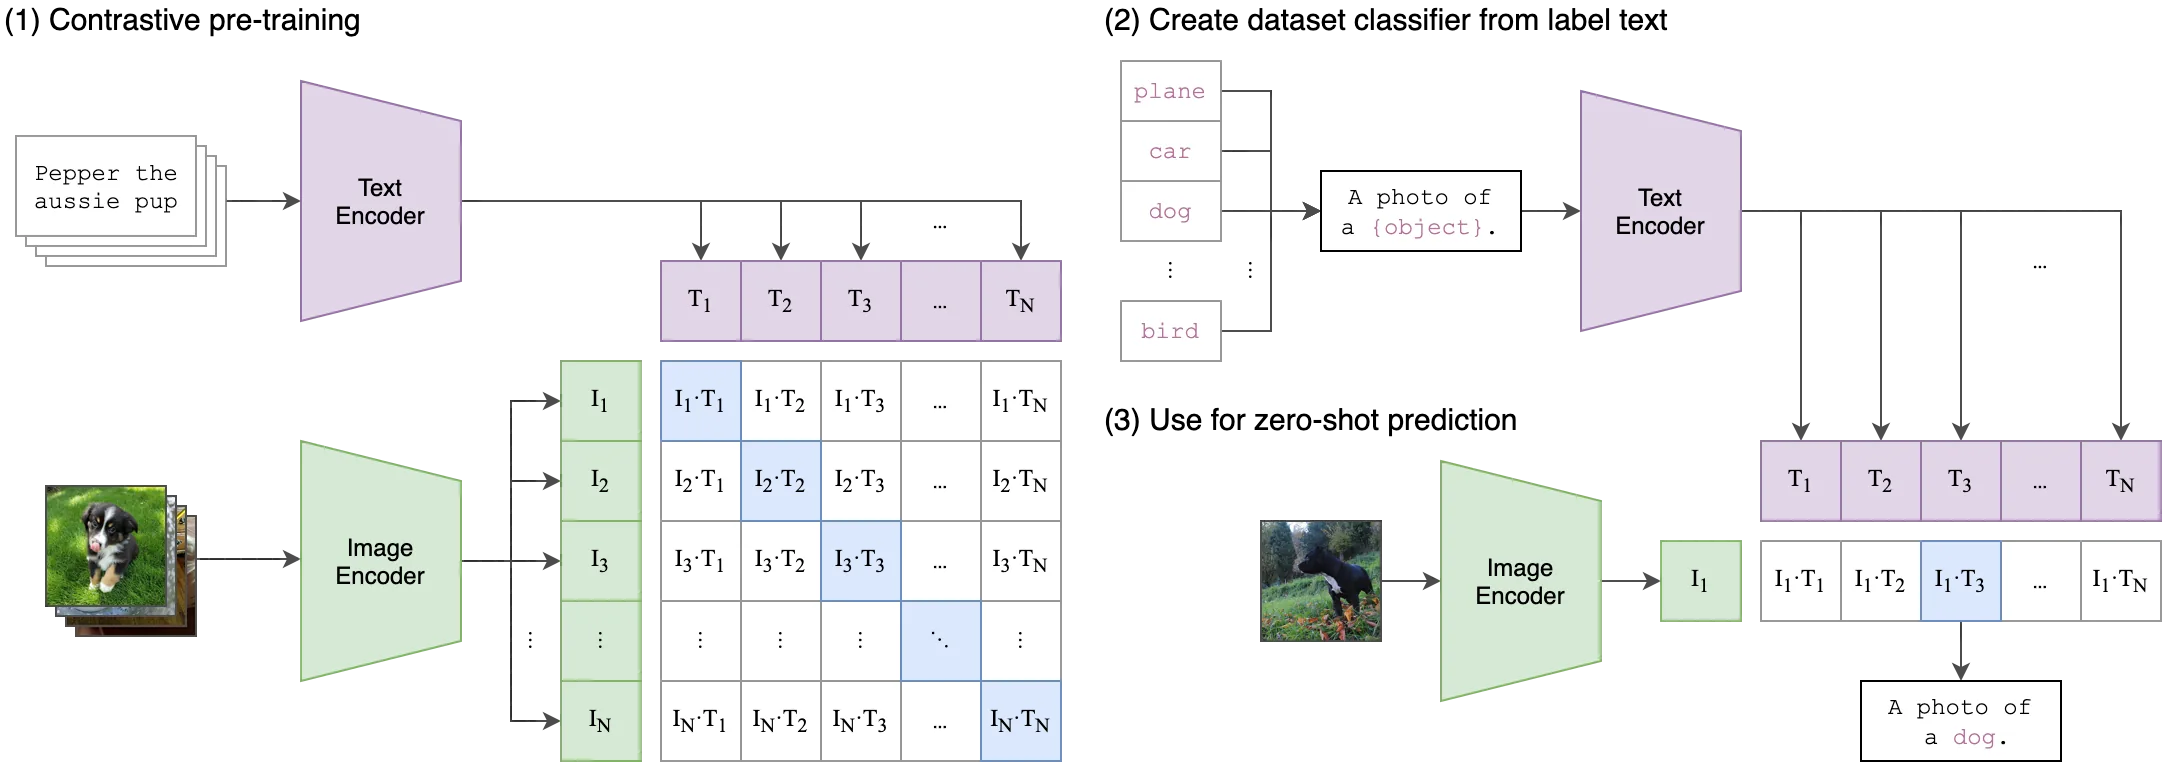
Explication des éléments clés de la figure
Section du tableau : Matrice d'apprentissage contrastif
Le tableau montre le calcul de similarité pour les paires image-texte (en supposant qu'il y aNdes textes et4des images) :
- Lignes (images):
I1, I2, I3, I4Représentent différentes caractéristiques d'image. - Colonnes (textes):
T1, T2, ..., TNReprésentent différentes caractéristiques de texte. - Valeurs des cellules(e.g.,
I1-T1) : La similarité cosinus entre les vecteurs de caractéristiques de l'imageI1et du texteT1.
Objectif:
Maximiser la similarité sur la diagonale (paires correctes, par ex.,I1-T1), et minimiser la similarité hors diagonale (paires incorrectes, par ex.,I1-T2). C'est l'idée centrale de l'apprentissage contrastif.
Section d'exemple
- Exemples d'images:
- "Pepper the aussie pup" (une photo d'un chiot berger australien).
- "Planer car dog" (éventuellement du bruit ou une annotation incorrecte ; il devrait en fait s'agir du texte modèle de "A photo of a (object)").
- Modèle de texte:
- "A photo of a (object)" est un modèle de prompt textuel couramment utilisé pendant le pré-entraînement de CLIP, utilisé pour généraliser à travers différentes catégories (par ex., "a photo of a dog").
Architecture du modèle
- Architecture à double encodeur:
- Encodeur d'images : généralement Vision Transformer (ViT) ou ResNet
- Encodeur de texte : basé sur l'architecture Transformer
- Objectif d'apprentissage contrastif:
- Les paires positives (paires image-texte correspondantes) sont proches dans l'espace des caractéristiques
- Les paires négatives (paires image-texte non correspondantes) sont éloignées dans l'espace des caractéristiques
Processus d'entraînement
Exemple
image_features = image_encoder(image_batch) # Extraction des caractéristiques d'image
text_features = text_encoder(text_batch) # Extraction des caractéristiques de texte
# Calcul de la matrice de similarité
logits = torch.matmul(image_features, text_features.T) * temperature
labels = torch.arange(batch_size) # La diagonale correspond aux échantillons positifs
# Perte contrastive symétrique
loss_img = cross_entropy(logits, labels)
loss_txt = cross_entropy(logits.T, labels)
total_loss = (loss_img + loss_txt)/2
Scénarios d'application
- Classification d'images zero-shot: Classer des catégories sans fine-tuning
- Recherche croisée image-texte: Permettre une recherche efficace texte-vers-image ou image-vers-texte
- Modération de contenu: Identifier le contenu d'une image qui ne correspond pas aux descriptions textuelles
DALL-E : La magie du texte-vers-image
Concepts de base
DALL-E est un modèle de génération d'images à partir de texte développé par OpenAI qui peut générer des images de haute qualité à partir de descriptions en langage naturel.
Caractéristiques techniques
Entraînement en deux étapes:
- Étape 1 : un autoencodeur variationnel discret (dVAE) compresse les images en tokens visuels
- Étape 2 : un Transformer autorégressif apprend la correspondance du texte vers les tokens visuels
Innovations clés:
- Traiter la génération d'images comme un problème de prédiction de séquence
- Utilise un modèle Transformer de 12 milliards de paramètres
Processus de génération d'exemples
Exemple
text = "Un Shiba Inu portant une combinaison spatiale jouant à un jeu vidéo dans une station spatiale"
text_tokens = tokenizer(text) # Encodage du texte
image_tokens = transformer.generate(text_tokens) # Générer les tokens visuels
image = dvae.decode(image_tokens) # Décoder en une image
Évolution du modèle
| Version | Améliorations majeures | Capacité de génération |
|---|---|---|
| DALL-E 1 | Architecture de base | résolution 256x256 |
| DALL-E 2 | Modèle de diffusion | résolution 1024x1024, plus précise |
| DALL-E 3 | Intégré à ChatGPT | Compréhension plus complexe des prompts |
Autres modèles multimodaux importants
ALIGN(Google)
- Entraîné sur des données web bruitées à grande échelle
- A démontré l'efficacité des données à grande échelle faiblement supervisées
Flamingo(DeepMind)
- Traite des séquences multimodales entrelacées (par ex., texte et images en alternance)
- Prend en charge l'apprentissage few-shot
BEiT-3(Microsoft)
- Cadre unifié de pré-entraînement multimodal
- Excellentes performances sur les tâches d'image, de texte et de vision-langage
Défis d'application des modèles multimodaux
- Exigences en matière de données: nécessite d'énormes quantités de données multimodales alignées de haute qualité
- Coût de calcul: L'entraînement de ces modèles nécessite d'énormes ressources de calcul
- Difficultés d'évaluation: manque de normes d'évaluation unifiées pour les tâches multimodales
- Problèmes de biais: peuvent amplifier les biais sociaux présents dans les données d'entraînement
Exercice pratique : classification zero-shot avec CLIP
Exemple
import torch
from PIL import Image
# Charger le modèle et le prétraitement
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)
# Préparer les entrées
image = preprocess(Image.open("dog.jpg")).unsqueeze(0).to(device)
text_inputs = clip.tokenize(["a dog", "a cat", "a bird"]).vers(device)
# Calculer les caractéristiques
with torch.no_grad():
image_features = model.encode_image(image)
text_features = model.encode_text(text_inputs)
# Calculer la similarité
logits = (image_features @ text_features.T).softmax(dim=-1)
print("Probabilités prédites:", logits.cpu().numpy())
Orientations futures de développement
- Architectures plus efficaces: Réduire le coût de calcul et améliorer la vitesse d'inférence
- Fusion de modalités plus poussée: Intégrer davantage de modalités telles que l'audio et la vidéo
- Capacité de compréhension causale: Améliorer la compréhension profonde du modèle du contenu multimodal
- Génération contrôlable: Améliorer le contrôle précis et la capacité d'édition du contenu généré
Les modèles pré-entraînés multimodaux transforment la façon dont les humains interagissent avec les machines. De la compréhension intermodale de CLIP à la génération créative de DALL-E, ces technologies ouvrent des possibilités entièrement nouvelles pour les applications d'IA.
Autres extensions