Modèles génératifs pré-entraînés
Les modèles génératifs pré-entraînés sont une classe de modèles d'apprentissage profond qui acquièrent des connaissances linguistiques générales à partir de données textuelles grâce à un apprentissage non supervisé à grande échelle et sont capables de générer un texte cohérent et raisonnable. Les caractéristiques principales de ces modèles sont :
- Capacité de génération : peut générer automatiquement un nouveau texte en fonction de l'entrée (prompt ou contexte).
- Paradigme de pré-entraînement + ajustement fin : d'abord pré-entraîner sur de grandes quantités de données, puis ajuster finement pour des tâches spécifiques.
- Architecture autorégressive ou autoencodeuse : apprend les schémas linguistiques via différents objectifs d'entraînement.

I. Historique du développement des modèles de la série GPT
1.1 GPT-1 : un point de départ pionnier
GPT-1 (Transformer génératif pré-entraîné) a été publié par OpenAI en 2018, démontrant pour la première fois l'efficacité du pré-entraînement non supervisé à grande échelle ainsi que de l'ajustement fin supervisé.
Fonctionnalités principales:
- Architecture de décodeur Transformer à 12 couches
- 117 millions de paramètres
- A utilisé le jeu de données BooksCorpus (environ 7,000 livres)
- A été pionnier du paradigme en deux étapes de "pré-entraînement + ajustement fin"
1.2 GPT-2 : une percée dans la mise à l'échelle
GPT-2, publié en 2019, a démontré une corrélation positive entre l'échelle du modèle et les performances.
Principales améliorations:
- Échelle des paramètres : 1.5 milliards (10 fois celle de GPT-1)
- Données d'entraînement : WebText (8 millions de pages web, 40GB de texte)
- Suppression de l'étape de fine-tuning, démontrant une capacité d'apprentissage zero-shot
- Introduction d'une fenêtre de contexte plus longue (1024 tokens)
1.3 GPT-3 : Du changement quantitatif au changement qualitatif
GPT-3, lancé en 2020, a acquis la capacité d'apprentissage few-shot, avec une échelle de paramètres de 175 milliards.
Progrès révolutionnaire:
- Architecture du modèle : Transformer à 96 couches
- Données d'entraînement : Common Crawl + jeux de données sélectionnés (environ 570GB)
- A démontré une forte capacité d'apprentissage en contexte
- A permis pour la première fois d'accomplir plusieurs tâches NLP sans fine-tuning
1.4 GPT-4 et développements ultérieurs
GPT-4, sorti en 2023, a encore repoussé les limites des capacités des modèles.
Derniers développements:
- Capacité de traitement multimodal (texte + images)
- Mémoire contextuelle plus longue (32k tokens)
- Capacités améliorées de raisonnement et de suivi d'instructions
- API commerciale et écosystème de plugins
II. Principes des modèles de langage autorégressifs
2.1 Concepts de base
Les modèles de langage autorégressifs prédisent la distribution de probabilité du mot suivant en fonction du contexte précédent :
P(x_t | x_<t) = P(x_t | x_1, x_2, ..., x_{t-1})
2.2 Principes mathématiques
Étant donné une séquence de mots x = (x₁, ..., xₙ), la probabilité conjointe est factorisée comme suit :
P(x) = ∏ P(x_t | x_<t)
L'entraînement utilise l'estimation par maximum de vraisemblance :
L(θ) = ∑ log P(x_t | x_<t; θ)
2.3 Architecture du décodeur Transformer
Composants clés :
- Auto-attention masquée: Empêche la fuite d'informations
# PyTorch 伪代码
attn_mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1)
- Encodage positionnel: Injecte les informations d'ordre de séquence
- Réseau feed-forward: Transformation des caractéristiques par position
III. Explication détaillée des techniques de génération de texte
3.1 Processus de génération
Processus typique de génération de texte :
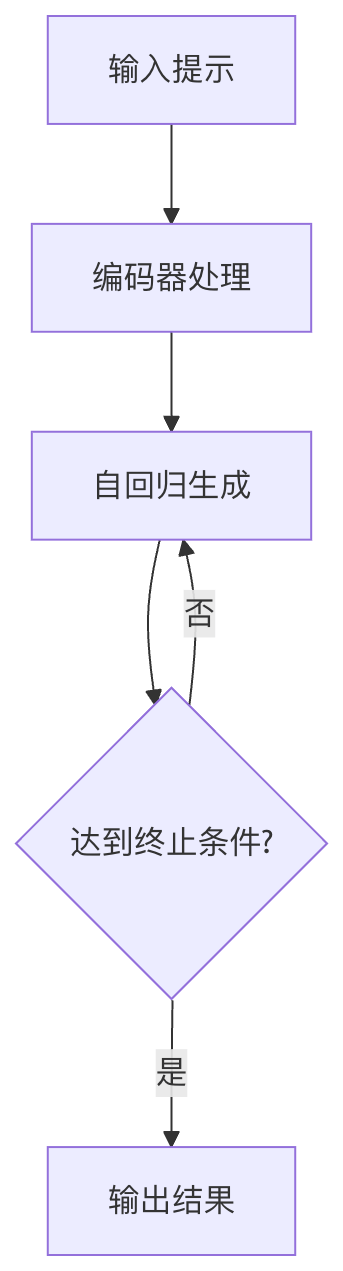
3.2 Comparaison des stratégies de décodage
| Stratégie | Température | Top-k | Top-p | Caractéristiques |
|---|---|---|---|---|
| Recherche gloutonne | - | - | - | Déterminisme élevé mais manque de diversité |
| Échantillonnage aléatoire | Réglable | Optional | Optional | Bonne créativité mais peut être incohérent |
| Recherche par faisceau | - | - | - | Équilibre la qualité et la diversité |
3.3 Paramètres de contrôle de génération
Exemples de paramètres clés :
Exemple
"max_length": 100, # Longueur maximale de génération
"temperature": 0.7, # Contrôle le caractère aléatoire (0-1)
"top_k": 50, # Nombre de jetons candidats
"top_p": 0.9, # Seuil d'échantillonnage nucleus
"repetition_penalty": 1.2 # Facteur de pénalité de répétition
}
IV. Bases de l'ingénierie des prompts
4.1 Principes fondamentaux
- Clarté: Exprimer clairement l'intention
- Contexte: Fournir suffisamment d'informations contextuelles
- Structure: Utiliser des séparateurs et une mise en forme
- Guidé par des exemples: Inclure des exemples few-shot
4.2 Conseils pratiques
- Définition du rôle:
You are a senior machine learning engineer, please explain in plain language...
- Décomposition en étapes:
请按以下步骤解决问题:
1. 首先分析...
2. 然后计算...
3. 最后输出...
- Spécification du format:
请用JSON格式输出,包含字段:summary, keywords, confidence
4.3 Schémas typiques
- Gabarit d'instruction:
任务:文本分类 输入:{text} 选项:positive, neutral, negative 输出: - **Chaîne de pensée (CoT)** :
Please reason step by step: First... Second... Therefore the conclusion is...
V. Exercices pratiques
5.1 Génération de base
Exemple
generator = pipeline('text-generation', model='gpt2')
prompt = "Le développement futur de l'intelligence artificielle"
output = generator(prompt, max_length=100)
print(output[0]['generated_text'])
5.2 Expériences de réglage des paramètres
Concevez des expériences comparatives pour observer les effets de différents paramètres :
- Fixez le prompt, faites varier la température (0.3 vs 0.7 vs 1.2)
- Comparez les différences entre top_k=10 et top_k=50
- Tester l'impact de différentes valeurs de max_length sur la cohérence de génération
5.3 Défi d'optimisation de prompt
Étant donné un prompt de base :
Write an article about climate change.
Directions d'optimisation :
- Ajouter un paramètre de rôle
- Spécifier la structure de l'article
- Inclure les exigences relatives aux mots-clés
- Définir des contraintes de style
En apprenant systématiquement l'historique de développement des modèles GPT, les principes autorégressifs, les techniques de génération et l'ingénierie de prompt, les développeurs peuvent mieux exploiter les capacités des grands modèles de langage modernes. Il est recommandé de commencer par des prompts simples, d'expérimenter progressivement différents paramètres de génération, d'observer les changements de comportement du modèle et, finalement, de maîtriser la méthodologie d'utilisation efficace de l'IA générative.
Autres extensions