Generative vortrainierte Modelle
Generative vortrainierte Modelle sind eine Klasse von Deep-Learning-Modellen, die durch groß angelegtes unüberwachtes Lernen allgemeines Sprachwissen aus Textdaten erwerben und in der Lage sind, kohärenten und sinnvollen Text zu generieren. Die Kernmerkmale solcher Modelle sind:
- Generierungsfähigkeit: Kann automatisch neuen Text basierend auf der Eingabe (Prompt oder Kontext) generieren.
- Pre-Training + Fine-Tuning-Paradigma: Zuerst auf großen Datenmengen vortrainieren, dann für spezifische Aufgaben feinabstimmen.
- Autoregressive oder Autoencoding-Architektur: Lernt Sprachmuster durch unterschiedliche Trainingsziele.

I. Entwicklungsgeschichte der GPT-Modellreihe
1.1 GPT-1: Ein wegweisender Ausgangspunkt
GPT-1 (Generative Pre-trained Transformer) wurde 2018 von OpenAI veröffentlicht und zeigte erstmals die Wirksamkeit von umfangreichem unüberwachtem Pre-Training plus überwachtem Fine-Tuning.
Kernfunktionen:
- 12-schichtige Transformer-Decoder-Architektur
- 117 Millionen Parameter
- Verwendete den BooksCorpus-Datensatz (ungefähr 7,000 Bücher)
- Begründete das zweistufige Paradigma des "Pre-Training + Fine-Tuning"
1.2 GPT-2: Ein Durchbruch bei der Skalierung
GPT-2, veröffentlicht 2019, zeigte eine positive Korrelation zwischen Modellgröße und Leistung.
Wichtige Upgrades:
- Parametergröße: 1.5 Milliarden (10-mal so viel wie GPT-1)
- Trainingsdaten: WebText (8 Millionen Webseiten, 40GB Text)
- Feinabstimmungsphase entfernt, wodurch Zero-Shot-Lernfähigkeit demonstriert wurde
- Einführung eines längeren Kontextfensters (1024 Token)
1.3 GPT-3: Von quantitativer zu qualitativer Veränderung
GPT-3, 2020 eingeführt, erreichte Few-Shot-Lernfähigkeit mit einer Parametergröße von 175 Milliarden.
Revolutionärer Fortschritt:
- Modellarchitektur: 96-schichtiger Transformer
- Trainingsdaten: Common Crawl + kuratierte Datensätze (ca. 570GB)
- Starke In-Context-Lernfähigkeit demonstriert
- Erreichte erstmals die Fähigkeit, mehrere NLP-Aufgaben ohne Fine-Tuning zu bewältigen
1.4 GPT-4 und nachfolgende Entwicklungen
GPT-4, veröffentlicht im Jahr 2023, erweiterte die Grenzen der Modellfähigkeiten weiter.
Neueste Entwicklungen:
- Multimodale Verarbeitungsfähigkeit (Text + Bilder)
- Längeres Kontextgedächtnis (32k Token)
- Verbesserte Fähigkeiten zum Schlussfolgern und Befolgen von Anweisungen
- Kommerzielles API- und Plugin-Ökosystem
II. Prinzipien autoregressiver Sprachmodelle
2.1 Grundlegende Konzepte
Autoregressive Sprachmodelle sagen die Wahrscheinlichkeitsverteilung des nächsten Wortes basierend auf dem vorangehenden Kontext voraus:
P(x_t | x_<t) = P(x_t | x_1, x_2, ..., x_{t-1})
2.2 Mathematische Prinzipien
Gegeben eine Wortsequenz x = (x₁, ..., xₙ), wird die gemeinsame Wahrscheinlichkeit wie folgt faktorisiert:
P(x) = ∏ P(x_t | x_<t)
Das Training verwendet die Maximum-Likelihood-Schätzung:
L(θ) = ∑ log P(x_t | x_<t; θ)
2.3 Transformer-Decoder-Architektur
Schlüsselkomponenten:
- Maskierte Selbstaufmerksamkeit: Verhindert Informationslecks
# PyTorch 伪代码
attn_mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1)
- Positionskodierung: Fügt Informationen zur Sequenzreihenfolge hinzu
- Feed-Forward-Netzwerk: Positionsweise Merkmalstransformation
III. Detaillierte Erläuterung der Techniken zur Textgenerierung
3.1 Generierungsprozess
Typischer Textgenerierungsprozess:
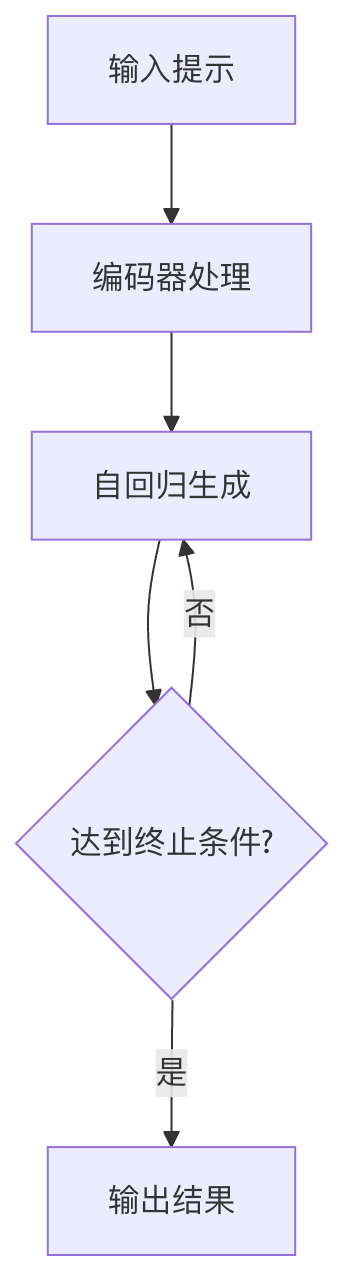
3.2 Vergleich der Dekodierungsstrategien
| Strategie | Temperatur | Top-k | Top-p | Eigenschaften |
|---|---|---|---|---|
| Greedy-Suche | - | - | - | Hoher Determinismus, aber geringe Vielfalt |
| Zufällige Stichprobenentnahme | Anpassbar | Optional | Optional | Gute Kreativität, aber möglicherweise inkohärent |
| Beam-Suche | - | - | - | Bringt Qualität und Vielfalt in Einklang |
3.3 Parameter zur Steuerung der Generierung
Beispiele für Schlüsselparameter:
Beispiel
"max_length": 100, # Maximale Generierungslänge
"temperature": 0.7, # Steuert die Zufälligkeit (0-1)
"top_k": 50, # Anzahl der Kandidaten-Tokens
"top_p": 0.9, # Schwellenwert für Nucleus-Sampling
"repetition_penalty": 1.2 # Faktor für Wiederholungsstrafe
}
IV. Grundlagen des Prompt-Engineerings
4.1 Kernprinzipien
- Klarheit: Absicht klar ausdrücken
- Kontext: Ausreichend Hintergrundinformationen bereitstellen
- Struktur: Trennzeichen und Formatierung verwenden
- Beispielbasiert: Few-Shot-Beispiele einbeziehen
4.2 Praktische Tipps
- Rolleneinstellung:
You are a senior machine learning engineer, please explain in plain language...
- Schrittzerlegung:
请按以下步骤解决问题:
1. 首先分析...
2. 然后计算...
3. 最后输出...
- Formatspezifikation:
请用JSON格式输出,包含字段:summary, keywords, confidence
4.3 Typische Muster
- Instruktionsvorlage:
任务:文本分类 输入:{text} 选项:positive, neutral, negative 输出: - **Gedankenkette (CoT)**:
Please reason step by step: First... Second... Therefore the conclusion is...
V. Praktische Übungen
5.1 Grundlegende Generierung
Beispiel
generator = pipeline('text-generation', model='gpt2')
prompt = "Die zukünftige Entwicklung der künstlichen Intelligenz"
output = generator(prompt, max_length=100)
print(output[0]['generated_text'])
5.2 Parameter-Tuning-Experimente
Entwerfen Sie vergleichende Experimente, um die Auswirkungen verschiedener Parameter zu beobachten:
- Halten Sie den Prompt fest, variieren Sie temperature (0.3 vs 0.7 vs 1.2)
- Vergleichen Sie die Unterschiede zwischen top_k=10 und top_k=50
- Testen Sie die Auswirkungen verschiedener max_length auf die Kohärenz der Generierung
5.3 Herausforderung zur Prompt-Optimierung
Gegeben sei ein einfacher Prompt:
Write an article about climate change.
Optimierungsrichtungen:
- Rolleneinstellung hinzufügen
- Artikelstruktur festlegen
- Keyword-Anforderungen einbeziehen
- Stilvorgaben festlegen
Indem Entwickler die Entwicklungsgeschichte von GPT-Modellen, autoregressive Prinzipien, Generierungstechniken und Prompt-Engineering systematisch erlernen, können sie die Fähigkeiten moderner großer Sprachmodelle besser nutzen. Es wird empfohlen, mit einfachen Prompts zu beginnen, schrittweise mit verschiedenen Generierungsparametern zu experimentieren, Veränderungen im Modellverhalten zu beobachten und schließlich die Methodik der effizienten Nutzung generativer KI zu beherrschen.
Andere Erweiterungen