生成型事前学習モデル
生成型事前学習モデルとは、大規模な教師なし学習を通じてテキストデータから一般的な言語知識を獲得し、一貫性のある合理的なテキストを生成できる深層学習モデルの一種です。この種のモデルの核心的な特徴は次のとおりです:
- 生成能力:入力(プロンプトまたはコンテキスト)に基づいて新しいテキストを自動的に生成できる。
- 事前学習+ファインチューニングパラダイム:まず大量のデータで事前学習し、その後特定のタスクに合わせてファインチューニングする。
- 自己回帰または自己符号化アーキテクチャ:異なるトレーニング目標を通じて言語の規則性を学習する。

一、GPTシリーズモデルの発展の歴史
1.1 GPT-1:革新的な出発点
GPT-1(Generative Pre-trained Transformer)は2018年にOpenAIによって公開され、大規模な教師なし事前学習+教師ありファインチューニングの有効性を初めて実証しました。
核心的な特徴:
- 12層のTransformerデコーダー構造
- 1億1700万パラメータ
- BooksCorpusデータセットを利用(約7,000冊の書籍)
- 「事前学習+ファインチューニング」という二段階パラダイムを開拓した
1.2 GPT-2:スケール化の突破口
2019年に公開されたGPT-2は、モデル規模と性能の正の相関関係を証明しました。
主なアップグレード:
- パラメータ規模:15億(GPT-1の10倍)
- トレーニングデータ:WebText(800万ウェブページ、40GBのテキスト)
- ファインチューニング段階を除去し、ゼロショット学習能力を実証
- より長いコンテキストウィンドウ(1024トークン)を導入
1.3 GPT-3:量から質への転換
2020年に発表されたGPT-3はフューショット学習能力を実現し、パラメータ規模は1750億に達しました。
革命的進歩:
- モデルアーキテクチャ:96層のTransformer
- トレーニングデータ:Common Crawl + 精選データセット(約570GB)
- 強力なインコンテキスト学習能力を実証
- ファインチューニングなしで多様なNLPタスクを完了できることを初めて実現
1.4 GPT-4とその後の発展
2023年に公開されたGPT-4は、モデル能力の境界をさらに拡張しました。
最新の進展:
- マルチモーダル処理能力(テキスト+画像)
- より長いコンテキストメモリ(32kトークン)
- 強化された推論および命令追従能力
- 商用化されたAPIとプラグインエコシステム
二、自己回帰言語モデルの原理
2.1 基本概念
自己回帰(Autoregressive)言語モデルは、先行する文脈から次の単語の確率分布を予測します:
P(x_t | x_<t) = P(x_t | x_1, x_2, ..., x_{t-1})
2.2 数学的原理
単語列 x = (x₁, ..., xₙ) が与えられたとき、結合確率は次のように分解されます:
P(x) = ∏ P(x_t | x_<t)
最尤推定を使用してトレーニングします:
L(θ) = ∑ log P(x_t | x_<t; θ)
2.3 Transformerデコーダーアーキテクチャ
主要コンポーネント:
- マスク付き自己注意:情報漏洩の防止
# PyTorch 伪代码
attn_mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1)
- 位置エンコーディング:シーケンスの順序情報を注入
- フィードフォワードネットワーク:位置ごとの特徴変換
三、テキスト生成技術の詳細解説
3.1 生成プロセス
典型的なテキスト生成フロー:
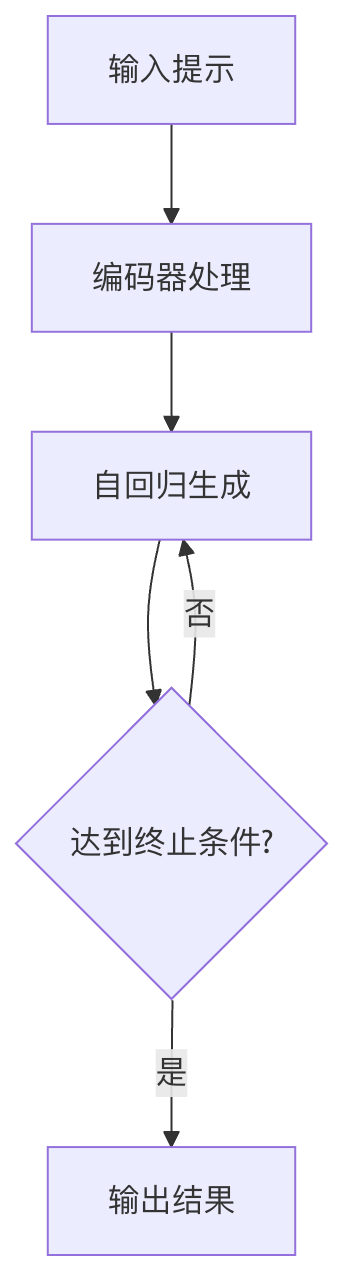
3.2 デコード戦略の比較
| 戦略 | 温度 | Top-k | Top-p | 特徴 |
|---|---|---|---|---|
| グリーディー探索 | - | - | - | 決定性が高いが多様性に欠ける |
| ランダムサンプリング | 調整可能 | 選択可能 | 選択可能 | 創造性は良いが、一貫性がない可能性がある |
| Beam Search | - | - | - | 品質と多様性のバランス |
3.3 生成制御パラメータ
主要パラメータの例:
例
generation_config = {
"max_length": 100, # 最大生成長
"temperature": 0.7, # ランダム性の制御(0-1)
"top_k": 50, # 候補単語数
"top_p": 0.9, # 核サンプリング閾値
"repetition_penalty": 1.2 # 繰り返しペナルティ係数
}
"max_length": 100, # 最大生成長
"temperature": 0.7, # ランダム性の制御(0-1)
"top_k": 50, # 候補単語数
"top_p": 0.9, # 核サンプリング閾値
"repetition_penalty": 1.2 # 繰り返しペナルティ係数
}
四、プロンプトエンジニアリングの基礎
4.1 中核原則
- 明確性:意図を明確に表現する
- コンテキスト:十分な背景情報を提供する
- 構造化:区切り文字とフォーマットを使用する
- 例示駆動:フューショットの例を含める
4.2 実用的なテクニック
- ロール設定:
あなたはベテランの機械学習エンジニアです。わかりやすい言葉で説明してください...
- ステップ分解:
请按以下步骤解决问题:
1. 首先分析...
2. 然后计算...
3. 最后输出...
- フォーマット指定:
请用JSON格式输出,包含字段:summary, keywords, confidence
4.3 典型的なパターン
- 指示テンプレート:
任务:文本分类 输入:{text} 选项:positive, neutral, negative 输出: - **思考の連鎖(CoT)**:
段階的に推論してください:まず... 次に... したがって結論は...
五、実践演習
5.1 基本生成
例
from transformers import pipeline
generator = pipeline('text-generation', model='gpt2')
prompt = 「人工知能の将来の発展」
output = generator(prompt, max_length=100)
print(output[0]['generated_text'])
generator = pipeline('text-generation', model='gpt2')
prompt = 「人工知能の将来の発展」
output = generator(prompt, max_length=100)
print(output[0]['generated_text'])
5.2 パラメータ調整実験
異なるパラメータの影響を観察するための対照実験を設計します:
- プロンプトを固定し、temperatureを変化させる(0.3 vs 0.7 vs 1.2)
- top_k=10 と top_k=50 の結果の違いを比較する
- 異なるmax_lengthが生成の一貫性に与える影響をテストする
5.3 プロンプト最適化チャレンジ
基本プロンプトが与えられた場合:
気候変動についての記事を書いてください
最適化の方向性:
- ロール設定を追加する
- 文章の構造を指定する
- キーワードの要件を含める
- スタイルの制約を設定する
GPTモデルの発展の歴史、自己回帰の原理、生成技術、プロンプトエンジニアリングを体系的に学ぶことで、開発者は現代の大規模言語モデルの能力をより良く活用できます。簡単なプロンプトから始め、異なる生成パラメータを徐々に実験し、モデルの動作の変化を観察し、最終的に生成型AIを効率的に使用する方法論を習得することをお勧めします。
その他の拡張