Modèles de la série BERT
BERT (Bidirectional Encoder Representations from Transformers) est un modèle révolutionnaire de traitement du langage naturel proposé par Google en 2018, qui a complètement changé les paradigmes de recherche et d'application dans le domaine du NLP.
Cet article présentera systématiquement les principes fondamentaux de BERT, les méthodes d'entraînement, les techniques de fine-tuning et les principaux modèles dérivés.
Architecture et entraînement de BERT
La figure ci-dessous montreBERT(Bidirectional Encoder Representations from Transformers)l'architecture centrale du modèle et la tâche de modélisation du langage masqué (Masked Language Modeling, MLM) lors du pré-entraînement.
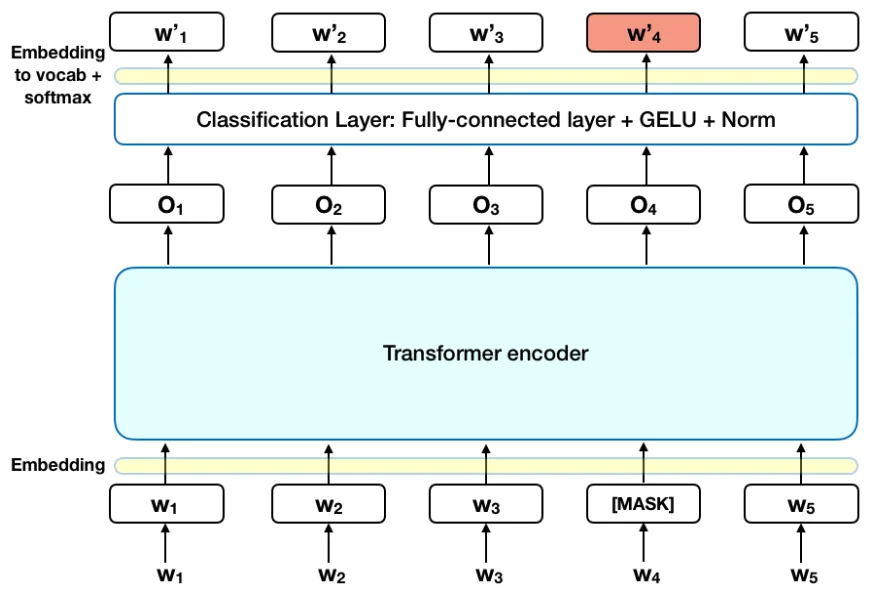
1. Couche d'entrée (Embedding)
- Séquence d'entrée: texte composé de mots (ou sous-mots), par exemple
[W₁, W₂, W₃, [MASK], W₅, W₆, W₇, W₂, W₃, W₄, W₅]。[MASK]est le mot masqué aléatoirement par BERT lors du pré-entraînement (comme dans le texte original,W₄est remplacé par[MASK])。
- Couche de plongement: convertit chaque mot en une représentation vectorielle de dimension fixe (par exemple, 768 dimensions), comprenant :
- Plongements de tokens: informations sémantiques du vocabulaire.
- Plongements de position: informations de position des mots dans la séquence.
- Plongements de segment: permettent de distinguer les phrases (utiles pour les tâches de paires de phrases, non explicitement montrés dans la figure).
2. Encodeur Transformer
- Blocs Transformer multicouches: détails non développés dans la figure, mais chaque bloc contient :
- Mécanisme d'auto-attention: capture de manière bidirectionnelle les dépendances contextuelles (caractéristique centrale de BERT).
- Réseau feed-forward: transformation non linéaire.
- Connexions résiduelles et normalisation de couche: stabilisent le processus d'entraînement.
- Sortie: la représentation vectorielle contextuelle correspondant à chaque mot d'entrée (par exemple,
O₁, O₂, ..., O₅)。
3. Tâche de modélisation du langage masqué (MLM)
- Objectif: prédire le mot masqué
[MASK]correspondant au mot original (dans la figureW₄)。 - Couche de classification:
- Couche entièrement connectée: projette le vecteur de sortie du Transformer (par ex.,
O₄) à la dimension de la taille du vocabulaire. - Fonction d'activation GELU: Unité linéaire d'erreur gaussienne (la fonction non linéaire utilisée par BERT).
- Normalisation de couche (Norm): normalise la sortie.
- Softmax: calcule la probabilité de chaque mot du vocabulaire et sélectionne le mot ayant la probabilité la plus élevée comme résultat de prédiction (par ex.,
W'₁, W'₂, ..., W'₅est un mot candidat).
- Couche entièrement connectée: projette le vecteur de sortie du Transformer (par ex.,
Structure de l'encodeur Transformer
BERT est construit sur la partie encodeur du Transformer, dont le cœur est le mécanisme d'auto-attention multicouche :
Exemple
class TransformerEncoderLayer(nn.Module):
def __init__(self, d_model, nhead, dim_feedforward=2048):
super().__init__()
self.self_attn = MultiheadAttention(d_model, nhead)
self.linear1 = nn.Linear(d_model, dim_feedforward)
self.linear2 = nn.Linear(dim_feedforward, d_model)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
def forward(self, src):
# Mécanisme d'auto-attention
src2 = self.self_attn(src, src, src)[0]
src = src + self.norm1(src2)
# Réseau de propagation avant
src2 = self.linear2(F.relu(self.linear1(src)))
src = src + self.norm2(src2)
return src
Innovation clé : Modélisation contextuelle bidirectionnelle
Contrairement aux modèles de langage traditionnels, BERT obtient une compréhension bidirectionnelle du contexte grâce aux deux tâches de pré-entraînement suivantes :
- Modèle de langage masqué (MLM): masque aléatoirement 15 % des jetons d'entrée et prédit les mots masqués
- Prédiction de la phrase suivante (NSP): détermine si deux phrases apparaissent consécutivement
Paramètres et configuration d'entraînement
| Paramètre | BERT-base | BERT-large |
|---|---|---|
| Nombre de couches | 12 | 24 |
| Taille de la couche cachée | 768 | 1024 |
| Nombre de têtes d'attention | 12 | 16 |
| Nombre total de paramètres | 110M | 340M |
Méthodes de fine-tuning de BERT
Processus de fine-tuning standard
- Ajout d'une couche d'adaptation spécifique à la tâche: ajouter une couche de classification/régression selon la tâche en aval
- Réglage du taux d'apprentissage: on utilise généralement un petit taux d'apprentissage (2e-5 à 5e-5)
- Taille de lot: 16 ou 32 sont des choix courants
- Époques d'entraînement: 2-4 époques sont généralement suffisantes
Techniques de fine-tuning efficaces
Exemple
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained('bert-base-uncased')
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset,
eval_dataset=eval_dataset
)
trainer.train()
Comparaison des stratégies de fine-tuning courantes
| Méthode | Avantage | Inconvénient |
|---|---|---|
| Fine-tuning complet des paramètres | Meilleures performances | Coût de calcul élevé |
| Extraction de caractéristiques (figer BERT) | Efficace en calcul | Performances sous-optimales |
| Adapter | Économe en paramètres | Nécessite une modification de l'architecture |
| Apprentissage par prompts | Bon pour les performances en few-shot | Nécessite la conception de modèles de prompts |
Modèles variants de BERT courants
RoBERTa (BERT robustement optimisé)
- Points d'amélioration:
- Taille de lot plus grande (8k vs 256)
- Temps d'entraînement plus long
- Tâche NSP supprimée
- Schéma de masquage dynamique
- Performance: amélioration moyenne de 2-3% sur le benchmark GLUE
ALBERT (un BERT allégé)
- Innovations clés:
- Partage de paramètres (partage des paramètres d'attention entre les couches)
- Factorisation des embeddings (décomposition de l'embedding de mots en deux petites matrices)
- Effet: nombre de paramètres réduit de 89%, vitesse multipliée par 1.7
Autres variantes importantes
- DistilBERT: compresse le modèle grâce à la distillation de connaissances
- ELECTRA: remplace le MLM par une architecture générateur-discriminateur
- SpanBERT: optimise la modélisation des segments de texte
Modèles BERT chinois
Aperçu des modèles pré-entraînés chinois
| Modèle | Institution | Fonctionnalités |
|---|---|---|
| BERT-wwm | Institut de technologie de Harbin | Masquage de mots entiers |
| RoBERTa-wwm-ext | Institut de technologie de Harbin | Données d'entraînement étendues |
| ERNIE (Baidu) | Baidu | Intègre des graphes de connaissances |
| NEZHA | Huawei | Encodage de position relative |
Exemple d'utilisation de BERT chinois
Exemple
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("Le traitement du langage naturel est très intéressant", return_tensors="pt")
outputs = model(**inputs)
Recommandations de fine-tuning pour les tâches en chinois
- L'utilisation de la version Whole Word Masking (wwm) donne de meilleurs résultats
- Prêtez attention à la gestion des problèmes de limites de segmentation des mots chinois
- Pour les domaines spécialisés, envisagez un pré-entraînement adapté au domaine
Recommandations pratiques et ressources
Feuille de route d'apprentissage
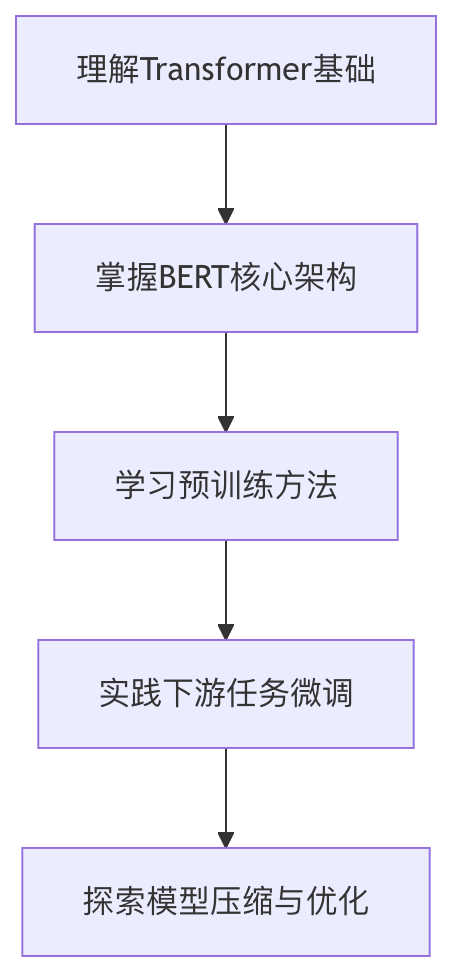
Ressources recommandées
- Articles:
- Article original sur BERT (arXiv:1810.04805)
- Articles sur les variantes telles que RoBERTa, ALBERT, etc.
- Dépôts de code:
- HuggingFace Transformers
- Implémentation GitHub de BERT chinois
- Cours en ligne:
- Spécialisation en traitement du langage naturel de Coursera
- Cours d'apprentissage profond de Hung-yi Lee
Grâce à un apprentissage et une pratique systématiques, les modèles de la série BERT peuvent devenir un outil puissant pour résoudre des problèmes de NLP. Il est recommandé de commencer par la version de base et d'explorer progressivement des variantes plus avancées et des techniques d'optimisation.
Autres extensions