Modelos de la serie BERT
BERT (Bidirectional Encoder Representations from Transformers) es un modelo revolucionario de procesamiento de lenguaje natural propuesto por Google en 2018, que transformó por completo los paradigmas de investigación y aplicación en el campo de la PNL.
Este artículo presentará sistemáticamente los principios fundamentales de BERT, sus métodos de entrenamiento, técnicas de ajuste fino y los principales modelos variantes.
Arquitectura y entrenamiento de BERT
La siguiente figura muestraBERT(Bidirectional Encoder Representations from Transformers)la arquitectura central del modelo y la tarea de modelado de lenguaje enmascarado (Masked Language Modeling, MLM) durante el proceso de preentrenamiento.
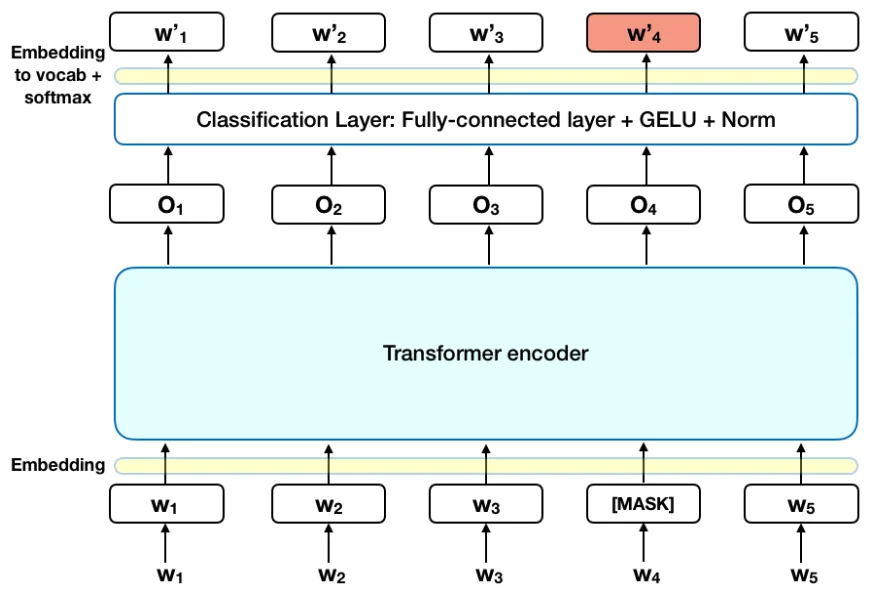
1. Capa de entrada (Embedding)
- Secuencia de entrada: texto compuesto por palabras (o subpalabras), por ejemplo
[W₁, W₂, W₃, [MASK], W₅, W₆, W₇, W₂, W₃, W₄, W₅]。[MASK]es la palabra que BERT enmascara aleatoriamente durante el preentrenamiento (como en el texto original,W₄es reemplazada por[MASK])。
- Capa de Embedding: convierte cada palabra en una representación vectorial de dimensión fija (por ejemplo, 768 dimensiones), que incluye:
- Embeddings de tokens (Token Embeddings): información semántica del vocabulario.
- Embeddings de posición (Position Embeddings): información de la posición de la palabra en la secuencia.
- Embeddings de segmento (Segment Embeddings): distinguen oraciones (útil para tareas de pares de oraciones, como no se muestra explícitamente en la figura).
2. Codificador Transformer (Transformer Encoder)
- Bloques Transformer de múltiples capas: la figura no muestra los detalles, pero cada bloque contiene:
- Mecanismo de autoatención (Self-Attention): captura bidireccional de dependencias contextuales (característica principal de BERT).
- Red de avance (Feed-Forward Network): transformación no lineal.
- Conexión residual y normalización de capa: estabiliza el proceso de entrenamiento.
- Salida: la representación vectorial dependiente del contexto correspondiente a cada palabra de entrada (por ejemplo,
O₁, O₂, ..., O₅)。
3. Tarea de modelado de lenguaje enmascarado (MLM)
- Objetivo: predecir la palabra enmascarada
[MASK]correspondiente a la palabra original (en la figura,W₄)。 - Capa de clasificación (Classification Layer):
- Capa totalmente conectada (Fully-Connected Layer): mapea el vector de salida del Transformer (como
O₄) a una dimensión del tamaño del vocabulario. - Función de activación GELU: Unidad lineal de error gaussiano (función no lineal utilizada por BERT).
- Normalización de capa (Norm): normaliza la salida.
- Softmax: calcula la probabilidad de cada palabra en el vocabulario y selecciona la palabra con mayor probabilidad como resultado de la predicción (por ejemplo,
W'₁, W'₂, ..., W'₅es la palabra candidata).
- Capa totalmente conectada (Fully-Connected Layer): mapea el vector de salida del Transformer (como
Estructura del codificador Transformer
BERT se construye sobre la parte del codificador de Transformer, cuyo núcleo es el mecanismo de autoatención de múltiples capas:
Ejemplo
class TransformerEncoderLayer(nn.Module):
def __init__(self, d_model, nhead, dim_feedforward=2048):
super().__init__()
self.self_attn = MultiheadAttention(d_model, nhead)
self.linear1 = nn.Linear(d_model, dim_feedforward)
self.linear2 = nn.Linear(dim_feedforward, d_model)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
def forward(self, src):
# Mecanismo de autoatención
src2 = self.self_attn(src, src, src)[0]
src = src + self.norm1(src2)
# Red de avance
src2 = self.linear2(F.relu(self.linear1(src)))
src = src + self.norm2(src2)
return src
Innovación clave: modelado de contexto bidireccional
A diferencia de los modelos de lenguaje tradicionales, BERT logra la comprensión bidireccional del contexto mediante las siguientes dos tareas de preentrenamiento:
- Masked Language Model (MLM): enmascara aleatoriamente el 15% de los tokens de entrada y predice las palabras enmascaradas
- Next Sentence Prediction (NSP): determina si dos oraciones aparecen de forma consecutiva
Parámetros de entrenamiento y configuración
| Parámetro | BERT-base | BERT-large |
|---|---|---|
| Número de capas | 12 | 24 |
| Tamaño de la capa oculta | 768 | 1024 |
| Número de cabezas de atención | 12 | 16 |
| Cantidad total de parámetros | 110M | 340M |
Métodos de ajuste fino de BERT
Proceso estándar de ajuste fino
- Adición de capa de adaptación a la tarea: agregar una capa de clasificación/regresión según la tarea downstream
- Configuración de la tasa de aprendizaje: normalmente se usa una tasa de aprendizaje pequeña (2e-5 a 5e-5)
- Tamaño de lote: 16 o 32 son opciones comunes
- Épocas de entrenamiento: normalmente 2-4 épocas son suficientes
Técnicas de ajuste fino eficientes
Ejemplo
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained('bert-base-uncased')
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset,
eval_dataset=eval_dataset
)
trainer.train()
Comparación de estrategias comunes de ajuste fino
| Método | Ventajas | Desventajas |
|---|---|---|
| Ajuste fino de todos los parámetros | Mejor rendimiento | Alto costo computacional |
| Extracción de características (BERT congelado) | Computacionalmente eficiente | Rendimiento subóptimo |
| Adaptador (Adapter) | Eficiente en parámetros | Requiere modificación de la arquitectura |
| Aprendizaje por prompts (Prompt) | Bueno para pocos ejemplos | Requiere diseñar plantillas de prompts |
Modelos variantes principales de BERT
RoBERTa (Robustly Optimized BERT)
- Puntos de mejora:
- Lotes más grandes (8k vs 256)
- Mayor tiempo de entrenamiento
- Eliminación de la tarea NSP
- Modo de enmascaramiento dinámico
- Rendimiento: mejora promedio del 2-3% en el benchmark GLUE
ALBERT (A Lite BERT)
- Innovación principal:
- Compartir parámetros (compartir parámetros de atención entre capas)
- Descomposición de embeddings (descomponer el embedding de palabras en dos matrices pequeñas)
- Efecto: la cantidad de parámetros se reduce en un 89% y la velocidad aumenta 1.7 veces
Otras variantes importantes
- DistilBERT: compresión del modelo mediante destilación de conocimiento
- ELECTRA: reemplazo del MLM con una arquitectura generador-discriminador
- SpanBERT: optimización del modelado de tramos de texto
Modelos BERT chinos
Descripción general de modelos preentrenados chinos
| Modelo | Institución | Características |
|---|---|---|
| BERT-wwm | HIT (Universidad de Tecnología de Harbin) | Enmascaramiento de palabra completa (Whole Word Masking) |
| RoBERTa-wwm-ext | HIT (Universidad de Tecnología de Harbin) | Datos de entrenamiento ampliados |
| ERNIE (Baidu) | Baidu | Integración de grafos de conocimiento |
| NEZHA | Huawei | Codificación de posición relativa |
Ejemplo de uso de BERT chino
Ejemplo
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("El procesamiento del lenguaje natural es muy interesante", return_tensors="pt")
outputs = model(**inputs)
Recomendaciones de ajuste fino para tareas en chino
- Usar la versión con enmascaramiento de palabra completa (wwm) funciona mejor
- Prestar atención al manejo de los límites de segmentación de palabras en chino
- Para dominios especializados, considerar el preentrenamiento adaptativo al dominio
Recomendaciones prácticas y recursos
Hoja de ruta de aprendizaje
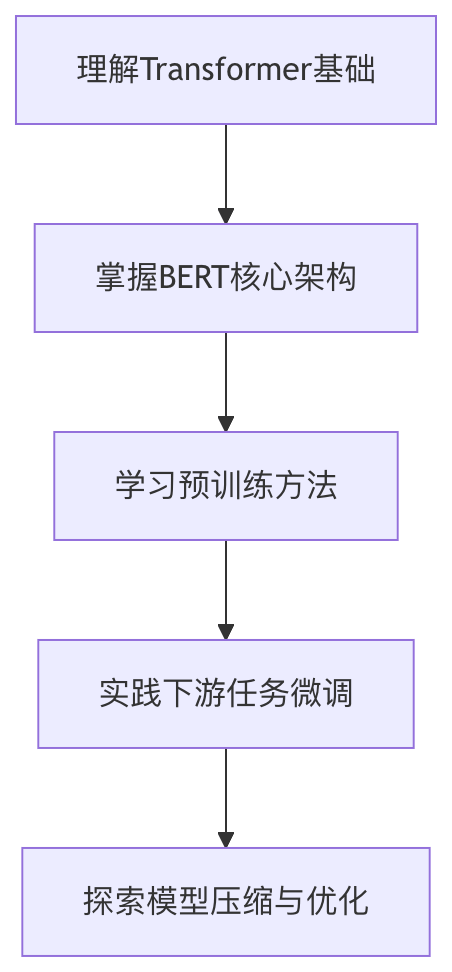
Recursos recomendados
- Artículos:
- Artículo original de BERT (arXiv:1810.04805)
- Artículos de variantes como RoBERTa, ALBERT, etc.
- Repositorios de código:
- HuggingFace Transformers
- Implementación de GitHub de BERT chino
- Cursos en línea:
- Especialización en Procesamiento de Lenguaje Natural en Coursera
- Curso de Deep Learning de Hung-yi Lee
Mediante el aprendizaje sistemático y la práctica, los modelos de la serie BERT pueden convertirse en una poderosa herramienta para resolver problemas de PNL. Se recomienda comenzar con la versión básica y explorar gradualmente variantes y técnicas de optimización más avanzadas.
Otras extensiones