BERT-Serienmodelle
BERT (Bidirectional Encoder Representations from Transformers) ist ein revolutionäres Modell zur Verarbeitung natürlicher Sprache, das 2018 von Google vorgeschlagen wurde und die Forschungs- und Anwendungsparadigmen im NLP-Bereich vollständig verändert hat.
Dieser Artikel führt systematisch in die Kernprinzipien, Trainingsmethoden, Fine-Tuning-Techniken und gängigen Variantenmodelle von BERT ein.
BERT-Architektur und Training
Die folgende Abbildung zeigtBERT(Bidirectional Encoder Representations from Transformers)die Kernarchitektur des Modells und die Aufgabe der maskierten Sprachmodellierung (Masked Language Modeling, MLM) während des Pretrainings.
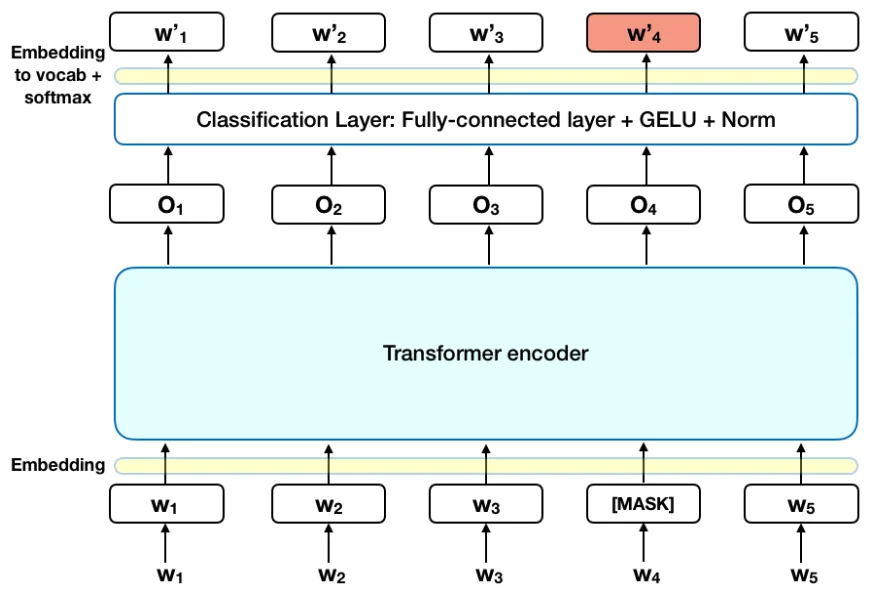
1. Eingabeschicht (Embedding)
- Eingabesequenz: Text, der aus Wörtern (oder Teilwörtern) besteht, zum Beispiel
[W₁, W₂, W₃, [MASK], W₅, W₆, W₇, W₂, W₃, W₄, W₅]。[MASK]ist das Wort, das während des Pretrainings zufällig von BERT maskiert wird (wie im Originaltext,W₄wird ersetzt durch[MASK])。
- Einbettungsschicht: wandelt jedes Wort in eine Vektordarstellung fester Dimension um (z. B. 768 Dimensionen), einschließlich:
- Token-Einbettungen: semantische Informationen des Vokabulars.
- Positions-Einbettungen: Positionsinformationen der Wörter in der Sequenz.
- Segment-Einbettungen: unterscheiden Sätze (nützlich für Satzpaar-Aufgaben, in der Abbildung nicht explizit dargestellt).
2. Transformer-Encoder
- Mehrschichtige Transformer-Blöcke: Details werden in der Abbildung nicht weiter ausgeführt, aber jeder Block enthält:
- Selbstaufmerksamkeitsmechanismus: erfasst bidirektional kontextuelle Abhängigkeiten (BERTs Kernmerkmal).
- Feed-Forward-Netzwerk: nichtlineare Transformation.
- Residualverbindungen und Layer-Normalisierung: stabilisieren den Trainingsprozess.
- Ausgabe: die kontextbewusste Vektordarstellung, die jedem Eingabewort entspricht (z. B.
O₁, O₂, ..., O₅)。
3. Aufgabe der maskierten Sprachmodellierung (MLM)
- Zielsetzung: das maskierte Wort vorhersagen
[MASK]entsprechend dem ursprünglichen Wort (in der AbbildungW₄)。 - Klassifikationsschicht:
- Vollständig verbundene Schicht: bildet den Transformer-Ausgabevektor (z. B.,
O₄) auf die Dimension der Vokabulargröße ab. - Aktivierungsfunktion GELU: Gaussian Error Linear Unit (die von BERT verwendete nichtlineare Funktion).
- Layer-Normalisierung (Norm): standardisiert die Ausgabe.
- Softmax: berechnet die Wahrscheinlichkeit jedes Wortes im Vokabular und wählt das Wort mit der höchsten Wahrscheinlichkeit als Vorhersageergebnis aus (z. B.,
W'₁, W'₂, ..., W'₅ist ein Kandidatenwort).
- Vollständig verbundene Schicht: bildet den Transformer-Ausgabevektor (z. B.,
Transformer-Encoder-Struktur
BERT basiert auf dem Encoder-Teil des Transformers, dessen Kern der mehrschichtige Self-Attention-Mechanismus ist:
Beispiel
class TransformerEncoderLayer(nn.Module):
def __init__(self, d_model, nhead, dim_feedforward=2048):
super().__init__()
self.self_attn = MultiheadAttention(d_model, nhead)
self.linear1 = nn.Linear(d_model, dim_feedforward)
self.linear2 = nn.Linear(dim_feedforward, d_model)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
def forward(self, src):
# Self-Attention-Mechanismus
src2 = self.self_attn(src, src, src)[0]
src = src + self.norm1(src2)
# Feed-Forward-Netzwerk
src2 = self.linear2(F.relu(self.linear1(src)))
src = src + self.norm2(src2)
return src
Schlüsselinnovation: Bidirektionale Kontextmodellierung
Im Gegensatz zu traditionellen Sprachmodellen erreicht BERT ein bidirektionales Kontextverständnis durch die folgenden zwei Vortrainingsaufgaben:
- Maskiertes Sprachmodell (MLM): maskiert zufällig 15 % der Eingabe-Tokens und sagt die maskierten Wörter voraus
- Vorhersage des nächsten Satzes (NSP): bestimmt, ob zwei Sätze aufeinanderfolgen
Trainingsparameter und Konfiguration
| Parameter | BERT-base | BERT-large |
|---|---|---|
| Anzahl der Schichten | 12 | 24 |
| Größe der verborgenen Schicht | 768 | 1024 |
| Anzahl der Attention-Heads | 12 | 16 |
| Gesamtanzahl der Parameter | 110M | 340M |
BERT-Fine-Tuning-Methoden
Standard-Fine-Tuning-Prozess
- Hinzufügen einer aufgabenspezifischen Anpassungsschicht: Je nach nachgelagerter Aufgabe eine Klassifizierungs-/Regressionsschicht hinzufügen
- Einstellung der Lernrate: Normalerweise wird eine kleine Lernrate verwendet (2e-5 bis 5e-5)
- Batch-Größe: 16 oder 32 sind übliche Werte
- Trainings-Epochen: 2-4 Epochen sind normalerweise ausreichend
Effiziente Fine-Tuning-Techniken
Beispiel
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained('bert-base-uncased')
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset,
eval_dataset=eval_dataset
)
trainer.train()
Vergleich gängiger Fine-Tuning-Strategien
| Methode | Vorteil | Nachteil |
|---|---|---|
| Vollparameter-Feinabstimmung | Beste Leistung | Hoher Rechenaufwand |
| Merkmalsextraktion (BERT einfrieren) | Recheneffizient | Suboptimale Leistung |
| Adapter | Parametereffizient | Erfordert Architekturänderung |
| Prompt-Lernen | Gut für Few-Shot-Leistung | Erfordert das Entwerfen von Prompt-Vorlagen |
Mainstream-BERT-Variantenmodelle
RoBERTa (Robust optimiertes BERT)
- Verbesserungspunkte:
- Größere Batch-Größe (8k vs 256)
- Längere Trainingszeit
- Entfernte NSP-Aufgabe
- Dynamisches Maskierungsmuster
- Leistung: durchschnittliche Verbesserung von 2-3% beim GLUE-Benchmark
ALBERT (Ein leichtes BERT)
- Kerninnovationen:
- Parameter-Sharing (gemeinsame Nutzung von Attention-Parametern über Schichten hinweg)
- Embedding-Faktorisierung (Zerlegung des Wort-Embeddings in zwei kleine Matrizen)
- Effekt: Parameteranzahl um 89% reduziert, Geschwindigkeit um das 1.7-Fache erhöht
Andere wichtige Varianten
- DistilBERT: komprimiert das Modell durch Wissensdestillation
- ELECTRA: ersetzt MLM durch eine Generator-Diskriminator-Architektur
- SpanBERT: optimiert die Modellierung von Textspans
Chinesische BERT-Modelle
Überblick über chinesische vortrainierte Modelle
| Modell | Institution | Funktionen |
|---|---|---|
| BERT-wwm | Technische Universität Harbin | Maskierung ganzer Wörter |
| RoBERTa-wwm-ext | Technische Universität Harbin | Erweiterte Trainingsdaten |
| ERNIE (Baidu) | Baidu | Integriert Wissensgraphen |
| NEZHA | Huawei | Relative Positionskodierung |
Chinesisches BERT-Anwendungsbeispiel
Beispiel
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("Natürliche Sprachverarbeitung ist sehr interessant", return_tensors="pt")
outputs = model(**inputs)
Fine-Tuning-Empfehlungen für chinesische Aufgaben
- Die Verwendung der Whole Word Masking (wwm)-Version liefert bessere Ergebnisse
- Achten Sie auf den Umgang mit Grenzproblemen bei der chinesischen Wortsegmentierung
- Bei spezialisierten Domänen domänenadaptives Pretraining erwägen
Praktische Empfehlungen und Ressourcen
Lern-Roadmap
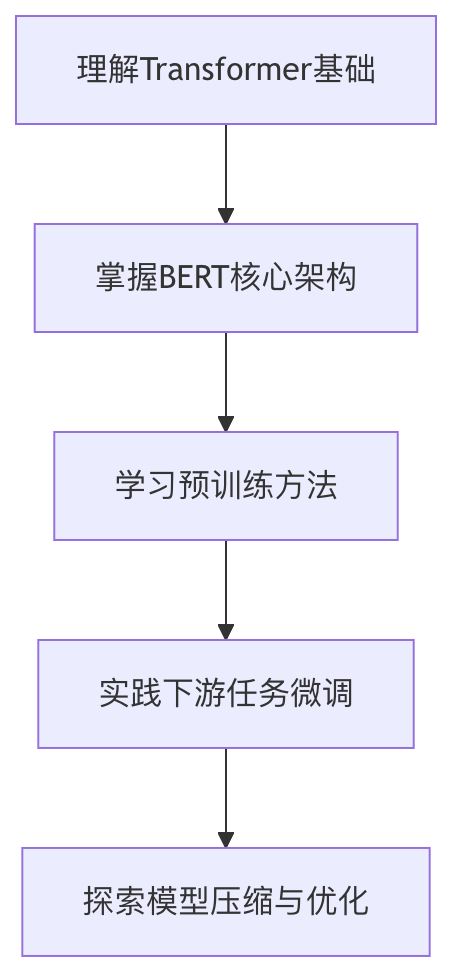
Empfohlene Ressourcen
- Fachartikel:
- Originalarbeit zu BERT (arXiv:1810.04805)
- Fachartikel zu Varianten wie RoBERTa, ALBERT usw.
- Code-Repositorien:
- HuggingFace Transformers
- GitHub-Implementierung von Chinese BERT
- Online-Kurse:
- Coursera-Spezialisierung für natürliche Sprachverarbeitung
- Hung-yi Lees Deep-Learning-Kurs
Durch systematisches Lernen und Üben können Modelle der BERT-Serie zu einem leistungsstarken Werkzeug zur Lösung von NLP-Problemen werden. Es wird empfohlen, mit der Basisversion zu beginnen und schrittweise fortgeschrittenere Varianten und Optimierungstechniken zu erkunden.
Andere Erweiterungen