Mécanisme d'attention
Le mécanisme d'attention est une technique importante en apprentissage profond qui imite la manière dont l'attention est allouée dans les processus visuels et cognitifs humains. Tout comme vous vous concentrez inconsciemment sur les mots-clés pendant la lecture, le mécanisme d'attention permet aux réseaux de neurones de se concentrer dynamiquement sur les parties les plus pertinentes des données d'entrée.
Concepts de base
L'idée centrale du mécanisme d'attention est :attribuer dynamiquement différents poids en fonction de l'importance des différentes parties de l'entrée pour la tâche en coursCette attribution de poids n'est pas fixe, mais calculée dynamiquement en fonction du contexte.
Expression mathématique
Le mécanisme d'attention peut généralement s'exprimer comme suit :
Attention(Q, K, V) = softmax(QK^T/√d_k)V
où :
- Q (Query) : l'élément de requête pour lequel la sortie doit actuellement être calculée
- K (Key) : la clé utilisée pour correspondre à l'élément de requête
- V (Value) : la valeur réelle correspondant à la clé
- d_k : la dimension de la clé, utilisée pour mettre à l'échelle le résultat du produit scalaire
Pourquoi un mécanisme d'attention est-il nécessaire ?
- Résoudre le problème de dépendance à long terme: les RNN traditionnels ont du mal à capturer les relations entre des mots éloignés
- Capacité de calcul parallèle: comparé au traitement séquentiel des RNN, l'attention peut être calculée en parallèle
- Interprétabilité: les poids d'attention peuvent montrer intuitivement sur quoi le modèle se concentre
Mécanisme d'auto-attention
L'auto-attention est une forme particulière du mécanisme d'attention qui permet à chaque élément de la séquence d'entrée d'établir des connexions avec tous les autres éléments de la séquence.
Comment ça marche
- Pour chaque élément de la séquence d'entrée, calculez son score de similarité avec tous les éléments
- Utilisez la fonction softmax pour convertir ces scores en poids (entre 0 et 1)
- Utilisez ces poids pour effectuer une somme pondérée des valeurs correspondantes afin d'obtenir la sortie
Exemple
import torch
import torch.nn.functional as F
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) / (query.size(-1) ** 0.5)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, value)
Avantages de l'auto-attention
- Prise en compte du contexte global: chaque position peut accéder directement aux informations de toutes les positions de la séquence
- Invariance de position: ne dépend pas de l'ordre de la séquence, convient au traitement de divers types de données structurées
- Calcul efficace: par rapport à la complexité O(n) des RNN, l'auto-attention peut être calculée en parallèle
Attention multi-têtes
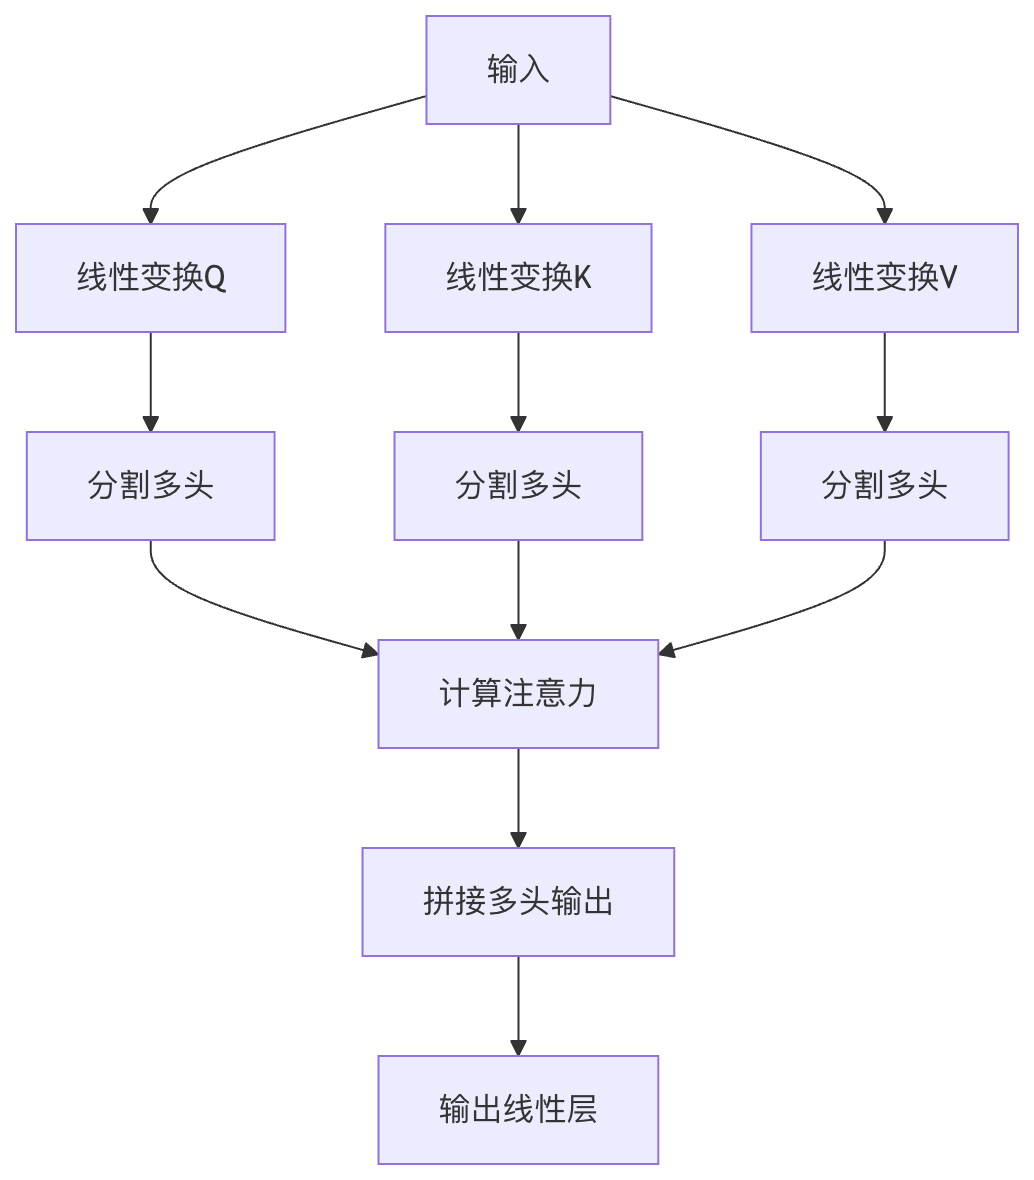
L'attention multi-têtes est une extension de l'auto-attention. Elle exécute le mécanisme d'attention plusieurs fois en parallèle, puis concatène les résultats.
Structure
- Plusieurs têtes d'attention: utilise généralement 8 têtes d'attention parallèles ou plus
- Couches de transformation linéaire: chaque tête possède ses propres matrices de transformation Q, K, V
- Concaténation et sortie: concatène les sorties de toutes les têtes et les fait passer à travers une couche linéaire
Avantages de l'attention multi-têtes
- Capturer différentes relations: chaque tête peut apprendre à se concentrer sur des relations sous différents angles
- Pouvoir expressif renforcé: capacité d'extraction de caractéristiques plus forte que l'attention à tête unique
- Entraînement stable: la combinaison de plusieurs têtes peut réduire la dépendance du modèle à des motifs spécifiques
Exemple
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.W_q = nn.Linear(d_model, d_model)
self.W_k = nn.Linear(d_model, d_model)
self.W_v = nn.Linear(d_model, d_model)
self.W_o = nn.Linear(d_model, d_model)
def forward(self, query, key, value):
batch_size = query.size(0)
# Transformation linéaire et découpage en plusieurs têtes
Q = self.W_q(query).view(batch_size, -1, self.num_heads, self.d_k)
K = self.W_k(key).view(batch_size, -1, self.num_heads, self.d_k)
V = self.W_v(value).view(batch_size, -1, self.num_heads, self.d_k)
# Calcul de l'attention
scores = torch.matmul(Q, K.transpose(-2, -1)) / (self.d_k ** 0.5)
weights = F.softmax(scores, dim=-1)
output = torch.matmul(weights, V)
# Concaténer les têtes et la sortie
output = output.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
return self.W_o(output)
Applications du mécanisme d'attention en NLP
Le mécanisme d'attention est devenu un composant central des systèmes NLP modernes, en particulier dans l'architecture Transformer.
Principaux scénarios d'application
Traduction automatique:
- Modèle Seq2Seq classique avec attention
- Permet au modèle de se concentrer sur les parties les plus pertinentes de la phrase source lors de la génération de chaque mot cible
Résumé de texte:
- Identifier les informations clés dans le texte source grâce aux poids d'attention
- Les modèles de résumé génératif utilisent l'auto-attention pour capturer les relations globales dans de longs documents
Systèmes de réponse aux questions:
- Attention croisée entre la question et le document
- Aide le modèle à localiser les segments de texte pertinents pour la question
Modèles de langage:
- Les modèles de la série GPT utilisent l'auto-attention masquée
- Permet à chaque mot de prêter attention à tous les mots précédents
Étude de cas : Attention dans BERT
BERT (Bidirectional Encoder Representations from Transformers) est un représentant typique des modèles utilisant le mécanisme d'attention :
- Auto-attention bidirectionnelle: prend en compte simultanément le contexte gauche et le contexte droit
- 12/24 couches Transformer: couches d'attention multi-têtes empilées
- Tâches de pré-entraînement: apprend des représentations générales via les tâches de modélisation du langage masquée et de prédiction de la phrase suivante
Exemple
from transformers import BertModel, BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')
inputs = tokenizer("Bonjour, mon chien est mignon", return_tensors="pt")
outputs = model(**inputs)
# Obtenir les poids d'attention
attention = outputs.attentions # Contient les poids d'attention pour toutes les couches
Variantes et extensions du mécanisme d'attention
1. Attention par produit scalaire mise à l'échelle
- Introduit un facteur d'échelle (√d_k) pour éviter la saturation du softmax
- Haute efficacité de calcul, adaptée aux applications à grande échelle
2. Attention additive
- Utilise un réseau feedforward à une seule couche pour calculer la fonction de compatibilité
- Convient aux cas où les dimensions de la requête et de la clé diffèrent
3. Attention locale
- Ne prête attention qu'à un sous-ensemble de l'entrée, ce qui réduit la complexité de calcul
- Équilibre l'attention globale et l'efficacité de calcul
4. Attention éparse
- Ne calcule les poids d'attention que pour certaines positions
- Comme l'attention à fenêtre glissante utilisée par Longformer
Exercices pratiques
Exercice 1 : Implémenter un mécanisme d'attention de base
Exemple
import torch.nn as nn
import torch.nn.functional as F
class SimpleAttention(nn.Module):
def __init__(self, hidden_size):
super(SimpleAttention, self).__init__()
self.attention = nn.Linear(hidden_size, 1)
def forward(self, encoder_outputs):
# encoder_outputs: [batch_size, seq_len, hidden_size]
attention_scores = self.attention(encoder_outputs).squeeze(2) # [batch_size, seq_len]
attention_weights = F.softmax(attention_scores, dim=1)
context_vector = torch.bmm(attention_weights.unsqueeze(1), encoder_outputs) # [batch_size, 1, hidden_size]
return context_vector.squeeze(1), attention_weights
Exercice 2 : Visualisation des poids d'attention
Exemple
import seaborn as sns
def plot_attention(attention_weights, source_tokens, target_tokens):
plt.figure(figsize=(10, 8))
sns.heatmap(attention_weights,
xticklabels=source_tokens,
yticklabels=target_tokens,
cmap="YlGnBu")
plt.xlabel("Jetons source")
plt.ylabel("Jetons cible")
plt.title("Visualisation des poids d'attention")
plt.show()
# Exemple d'utilisation
source = ["The", "cat", "sat", "on", "the", "mat"]
target = ["Le", "chat", "s'est", "assis", "sur", "le", "tapis"]
attention = torch.rand(7, 6) # Poids d'attention simulés
plot_attention(attention, source, target)
Résumé et approfondissement
Le mécanisme d'attention est devenu une technologie fondamentale de l'apprentissage profond moderne, en particulier dans le domaine du traitement du langage naturel. Pour l'étudier plus en profondeur :
Lire les articles originaux:
- "Attention Is All You Need" (Vaswani et al., 2017)
- "Neural Machine Translation by Jointly Learning to Align and Translate" (Bahdanau et al., 2015)
Projets pratiques suggérés:
- Implémenter un modèle Transformer complet
- Utiliser le mécanisme d'attention pour améliorer les modèles existants
- Analyser l'impact de différentes variantes d'attention sur les performances
Domaines d'application élargis:
- Attention visuelle en vision par ordinateur
- Attention intermodale dans l'apprentissage multimodal
- Mécanisme d'attention de graphe dans les réseaux de neurones de graphes
Le développement du mécanisme d'attention est toujours en cours. Comprendre ses principes fondamentaux vous aidera à mieux maîtriser les techniques modernes d'apprentissage profond.
Autres extensions