Attention-Mechanismus
Der Aufmerksamkeitsmechanismus ist eine wichtige Technik im Deep Learning, die die Art und Weise nachahmt, wie Aufmerksamkeit in menschlichen visuellen und kognitiven Prozessen zugewiesen wird. So wie man beim Lesen unbewusst auf Schlüsselwörter achtet, ermöglicht der Aufmerksamkeitsmechanismus neuronalen Netzen, sich dynamisch auf die relevantesten Teile der Eingabedaten zu konzentrieren.
Grundlegende Konzepte
Die Kernidee des Aufmerksamkeitsmechanismus ist:dynamische Zuweisung unterschiedlicher Gewichtungen basierend auf der Wichtigkeit verschiedener Teile der Eingabe für die aktuelle AufgabeDiese Gewichtszuweisung ist nicht fest, sondern wird dynamisch basierend auf dem Kontext berechnet.
Mathematischer Ausdruck
Der Aufmerksamkeitsmechanismus kann allgemein ausgedrückt werden als:
Attention(Q, K, V) = softmax(QK^T/√d_k)V
wobei:
- Q (Query): das Abfrageelement, für das die Ausgabe derzeit berechnet werden muss
- K (Key): der Schlüssel, der zum Abgleich mit dem Abfrageelement verwendet wird
- V (Value): der tatsächliche Wert, der dem Schlüssel entspricht
- d_k: die Dimension des Schlüssels, die zur Skalierung des Skalarprodukts verwendet wird
Warum wird ein Aufmerksamkeitsmechanismus benötigt?
- Lösung des Problems der weitreichenden Abhängigkeiten: traditionelle RNNs haben Schwierigkeiten, Beziehungen zwischen weit entfernten Wörtern zu erfassen
- Parallele Rechenfähigkeit: Im Vergleich zur sequenziellen Verarbeitung von RNNs kann Attention parallel berechnet werden
- Interpretierbarkeit: Attention-Gewichte können intuitiv zeigen, worauf das Modell seinen Fokus legt
Self-Attention-Mechanismus
Self-Attention ist eine spezielle Form des Attention-Mechanismus, die es jedem Element in der Eingabesequenz ermöglicht, Verbindungen mit allen anderen Elementen in der Sequenz herzustellen.
Funktionsweise
- Berechne für jedes Element in der Eingabesequenz seinen Ähnlichkeitswert mit allen Elementen
- Verwende die Softmax-Funktion, um diese Scores in Gewichte (zwischen 0 und 1) umzuwandeln
- Verwende diese Gewichte, um eine gewichtete Summe der entsprechenden Werte zu bilden und die Ausgabe zu erhalten
Beispiel
import torch
import torch.nn.functional as F
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) / (query.size(-1) ** 0.5)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, value)
Vorteile von Self-Attention
- Globales Kontextbewusstsein: Jede Position kann direkt auf Informationen von allen Positionen in der Sequenz zugreifen
- Positionsinvarianz: hängt nicht von der Reihenfolge der Sequenz ab, geeignet für die Verarbeitung verschiedener Arten strukturierter Daten
- Effiziente Berechnung: Im Vergleich zur O(n)-Komplexität von RNNs kann Self-Attention parallel berechnet werden
Multi-Head Attention
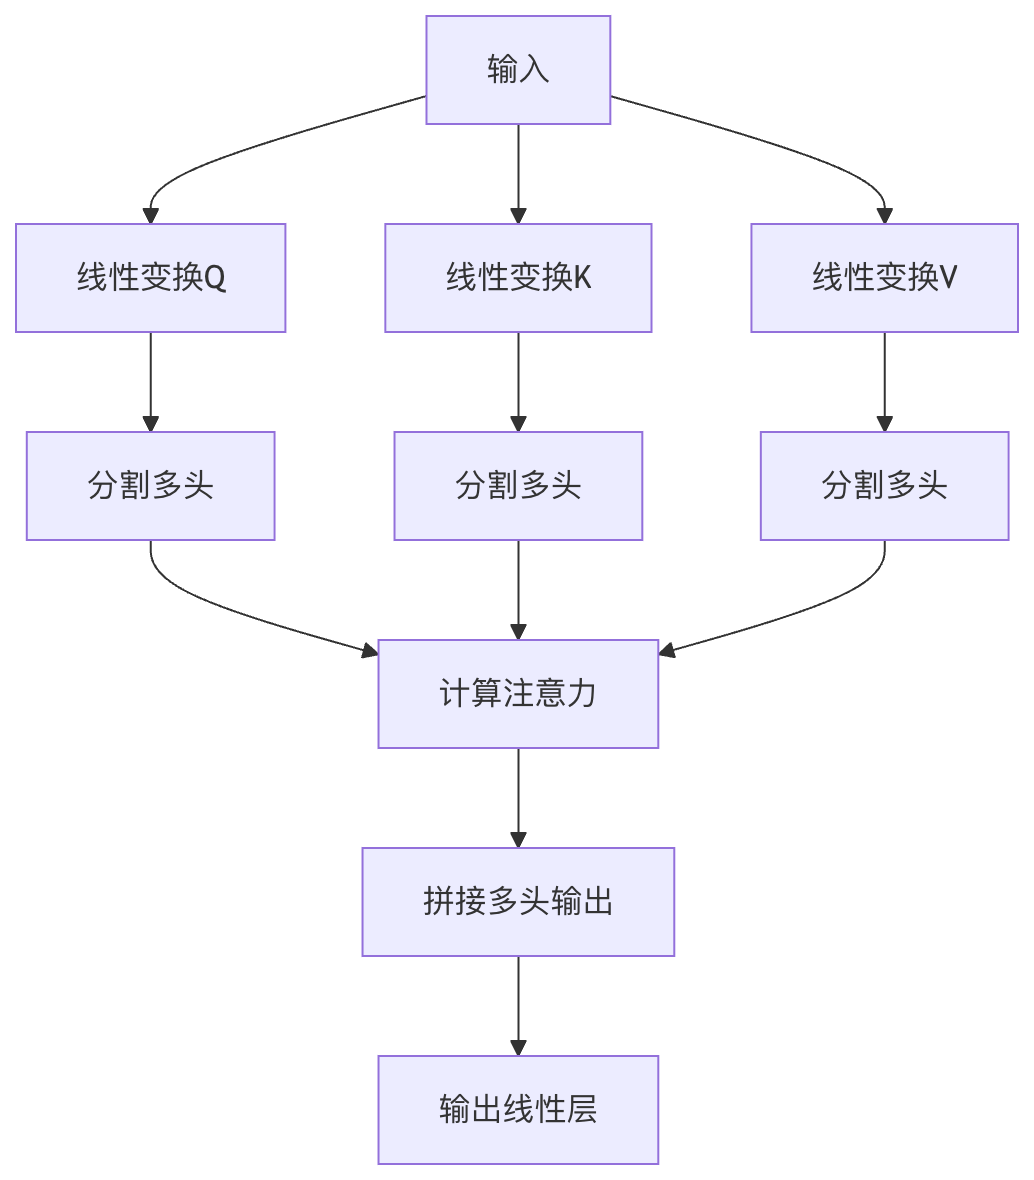
Multi-Head-Attention ist eine Erweiterung von Self-Attention. Sie führt den Attention-Mechanismus mehrfach parallel aus und konkateniert dann die Ergebnisse.
Struktur
- Mehrere Attention-Heads: verwendet typischerweise 8 oder mehr parallele Attention-Heads
- Lineare Transformationsschichten: Jeder Head hat seine eigenen Q-, K-, V-Transformationsmatrizen
- Konkatenation und Ausgabe: Die Ausgaben aller Heads konkatenieren und sie durch eine lineare Schicht leiten
Vorteile von Multi-Head-Attention
- Erfassen unterschiedlicher Beziehungen: Jeder Head kann lernen, sich auf Beziehungen aus verschiedenen Perspektiven zu konzentrieren
- Erhöhte Ausdrucksstärke: stärkere Merkmalsextraktionsfähigkeit als Single-Head-Attention
- Stabiles Training: Die Kombination mehrerer Heads kann die Abhängigkeit des Modells von spezifischen Mustern verringern
Beispiel
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.W_q = nn.Linear(d_model, d_model)
self.W_k = nn.Linear(d_model, d_model)
self.W_v = nn.Linear(d_model, d_model)
self.W_o = nn.Linear(d_model, d_model)
def forward(self, query, key, value):
batch_size = query.size(0)
# Lineare Transformation und Aufteilung in mehrere Köpfe
Q = self.W_q(query).view(batch_size, -1, self.num_heads, self.d_k)
K = self.W_k(key).view(batch_size, -1, self.num_heads, self.d_k)
V = self.W_v(value).view(batch_size, -1, self.num_heads, self.d_k)
# Attention berechnen
scores = torch.matmul(Q, K.transpose(-2, -1)) / (self.d_k ** 0.5)
weights = F.softmax(scores, dim=-1)
output = torch.matmul(weights, V)
# Köpfe und Ausgabe verketten
output = output.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
return self.W_o(output)
Anwendungen des Attention-Mechanismus in NLP
Der Attention-Mechanismus ist zu einer Kernkomponente moderner NLP-Systeme geworden, insbesondere in der Transformer-Architektur.
Hauptanwendungsszenarien
Maschinelle Übersetzung:
- Klassisches Seq2Seq-Modell mit Attention
- Ermöglicht es dem Modell, sich bei der Generierung jedes Zielworts auf die relevantesten Teile des Quellsatzes zu konzentrieren
Textzusammenfassung:
- Identifizierung wichtiger Informationen im Quelltext durch Attention-Gewichte
- Generative Zusammenfassungsmodelle verwenden Selbstaufmerksamkeit, um globale Beziehungen in langen Dokumenten zu erfassen
Frage-Antwort-Systeme:
- Kreuzaufmerksamkeit zwischen der Frage und dem Dokument
- Hilft dem Modell, Textsegmente zu finden, die für die Frage relevant sind
Sprachmodelle:
- Modelle der GPT-Serie verwenden maskierte Selbstaufmerksamkeit
- Ermöglicht jedem Wort, auf alle vorangehenden Wörter zu achten
Fallstudie: Aufmerksamkeit in BERT
BERT (Bidirectional Encoder Representations from Transformers) ist ein typischer Vertreter von Modellen, die den Aufmerksamkeitsmechanismus verwenden:
- Bidirektionale Selbstaufmerksamkeit: berücksichtigt gleichzeitig den linken und den rechten Kontext
- 12/24 Transformer-Schichten: gestapelte Multi-Head-Attention-Schichten
- Vorabtrainingsaufgaben: lernt allgemeine Repräsentationen durch maskierte Sprachmodellierung und Aufgaben zur Vorhersage des nächsten Satzes
Beispiel
from transformers import BertModel, BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')
inputs = tokenizer("Hallo, mein Hund ist süß", return_tensors="pt")
outputs = model(**inputs)
# Aufmerksamkeitsgewichte abrufen
attention = outputs.attentions # Enthält Aufmerksamkeitsgewichte für alle Schichten
Varianten und Erweiterungen des Aufmerksamkeitsmechanismus
1. Skalierte Punktprodukt-Aufmerksamkeit
- Führt einen Skalierungsfaktor (√d_k) ein, um eine Softmax-Sättigung zu verhindern
- Hohe Recheneffizienz, geeignet für Anwendungen im großen Maßstab
2. Additive Aufmerksamkeit
- Verwendet ein einschichtiges Feedforward-Netzwerk, um die Kompatibilitätsfunktion zu berechnen
- Geeignet für Fälle, in denen sich die Query- und Key-Dimensionen unterscheiden
3. Lokale Attention
- Berücksichtigt nur eine Teilmenge der Eingabe, was den Rechenaufwand reduziert
- Balanciert globale Attention und Recheneffizienz
4. Sparse Attention
- Berechnet Attention-Gewichte nur für einige Positionen
- Wie zum Beispiel die von Longformer verwendete Sliding-Window-Attention
Übungsaufgaben
Übung 1: Implementierung eines grundlegenden Attention-Mechanismus
Beispiel
import torch.nn as nn
import torch.nn.functional as F
class SimpleAttention(nn.Module):
def __init__(self, hidden_size):
super(SimpleAttention, self).__init__()
self.attention = nn.Linear(hidden_size, 1)
def forward(self, encoder_outputs):
# encoder_outputs: [batch_size, seq_len, hidden_size]
attention_scores = self.attention(encoder_outputs).squeeze(2) # [batch_size, seq_len]
attention_weights = F.softmax(attention_scores, dim=1)
context_vector = torch.bmm(attention_weights.unsqueeze(1), encoder_outputs) # [batch_size, 1, hidden_size]
return context_vector.squeeze(1), attention_weights
Übung 2: Visualisierung der Attention-Gewichte
Beispiel
import seaborn as sns
def plot_attention(attention_weights, source_tokens, target_tokens):
plt.figure(figsize=(10, 8))
sns.heatmap(attention_weights,
xticklabels=source_tokens,
yticklabels=target_tokens,
cmap="YlGnBu")
plt.xlabel("Quell-Token")
plt.ylabel("Ziel-Token")
plt.title("Visualisierung der Aufmerksamkeitsgewichte")
plt.show()
# Beispielverwendung
source = ["The", "cat", "sat", "on", "the", "mat"]
target = ["Le", "chat", "s'est", "assis", "sur", "le", "tapis"]
attention = torch.rand(7, 6) # Simulierte Aufmerksamkeitsgewichte
plot_attention(attention, source, target)
Zusammenfassung und weiterführendes Lernen
Der Attention-Mechanismus hat sich zu einer Grundpfeilertechnologie des modernen Deep Learning entwickelt, insbesondere im NLP-Bereich. Um ihn eingehender zu untersuchen:
Lies die Originalarbeiten:
- "Attention Is All You Need" (Vaswani et al., 2017)
- "Neural Machine Translation by Jointly Learning to Align and Translate" (Bahdanau et al., 2015)
Vorgeschlagene Übungsprojekte:
- Implementiere ein vollständiges Transformer-Modell
- Nutze den Attention-Mechanismus, um bestehende Modelle zu verbessern
- Analysiere die Auswirkungen verschiedener Attention-Varianten auf die Leistung
Erweiterte Anwendungsbereiche:
- Visuelle Aufmerksamkeit in der Computer Vision
- Cross-modale Attention im multimodalen Lernen
- Graph-Aufmerksamkeitsmechanismus in Graph-Neuronalen Netzen
Die Entwicklung des Aufmerksamkeitsmechanismus ist noch im Gange. Das Verständnis seiner Kernprinzipien wird Ihnen helfen, moderne Deep-Learning-Techniken besser zu beherrschen.
Andere Erweiterungen