Einführung in das maschinelle Lernen
Maschinelles Lernen ist ein Teilgebiet der Künstlichen Intelligenz (KI), das Computersysteme in die Lage versetzt, mithilfe von Daten und Algorithmen automatisch zu lernen und ihre Leistung zu verbessern.
Maschinelles Lernen ist ein sich ständig weiterentwickelndes Feld, das die Art und Weise verändert, wie wir mit Technologie interagieren, und neue Werkzeuge und Methoden zur Lösung komplexer Probleme bereitstellt.
Maschinelles Lernen ist eine Technik, die es Computern ermöglicht, aus Daten zu lernen, und wird in verschiedenen Branchen breit eingesetzt.
Stellen Sie sich vor, Sie bringen einem Kind bei, verschiedene Tiere zu erkennen. Sie müssen keine komplexen Regeln erklären wie "alle Katzen haben zwei Ohren, vier Beine, Schnurrhaare ...". Stattdessen zeigen Sie ihm viele Bilder von Katzen und sagen ihm "das ist eine Katze". Nach und nach kann das Kind Katzen erkennen, die es noch nie zuvor gesehen hat.
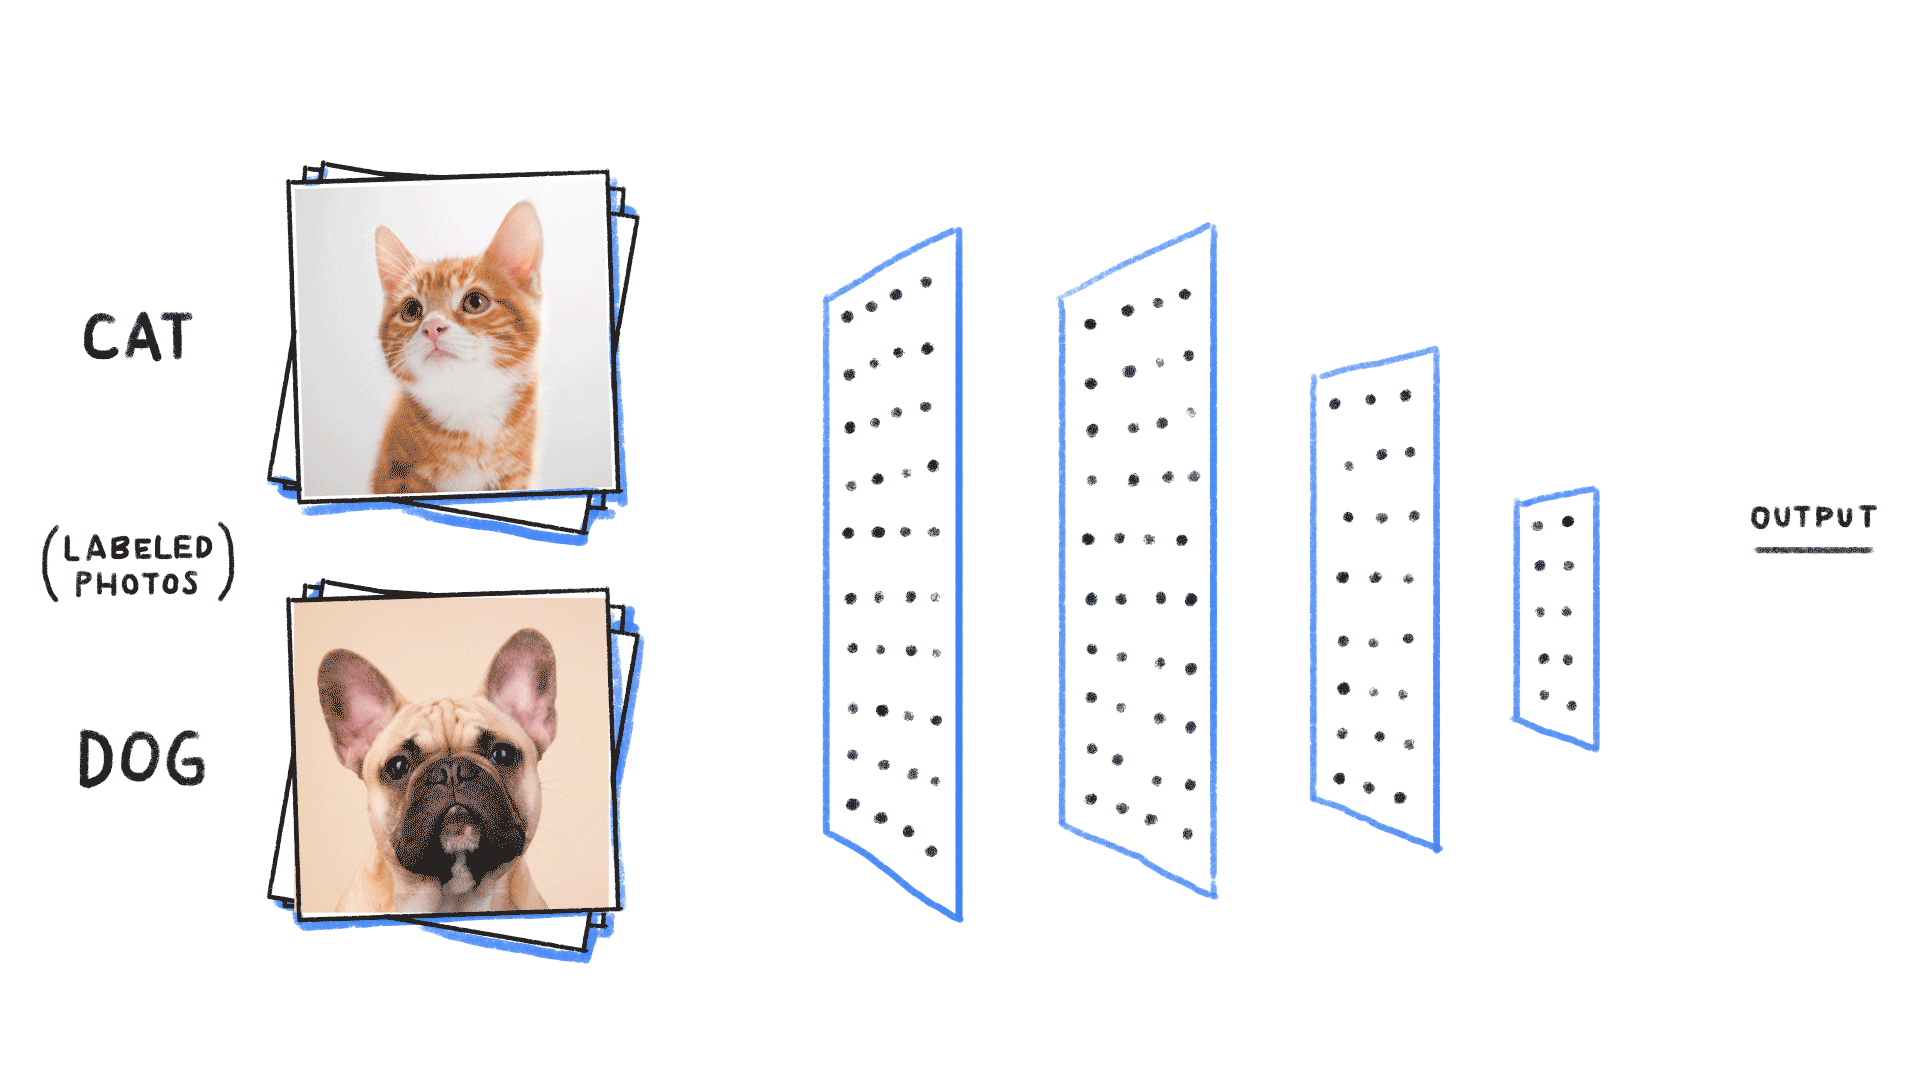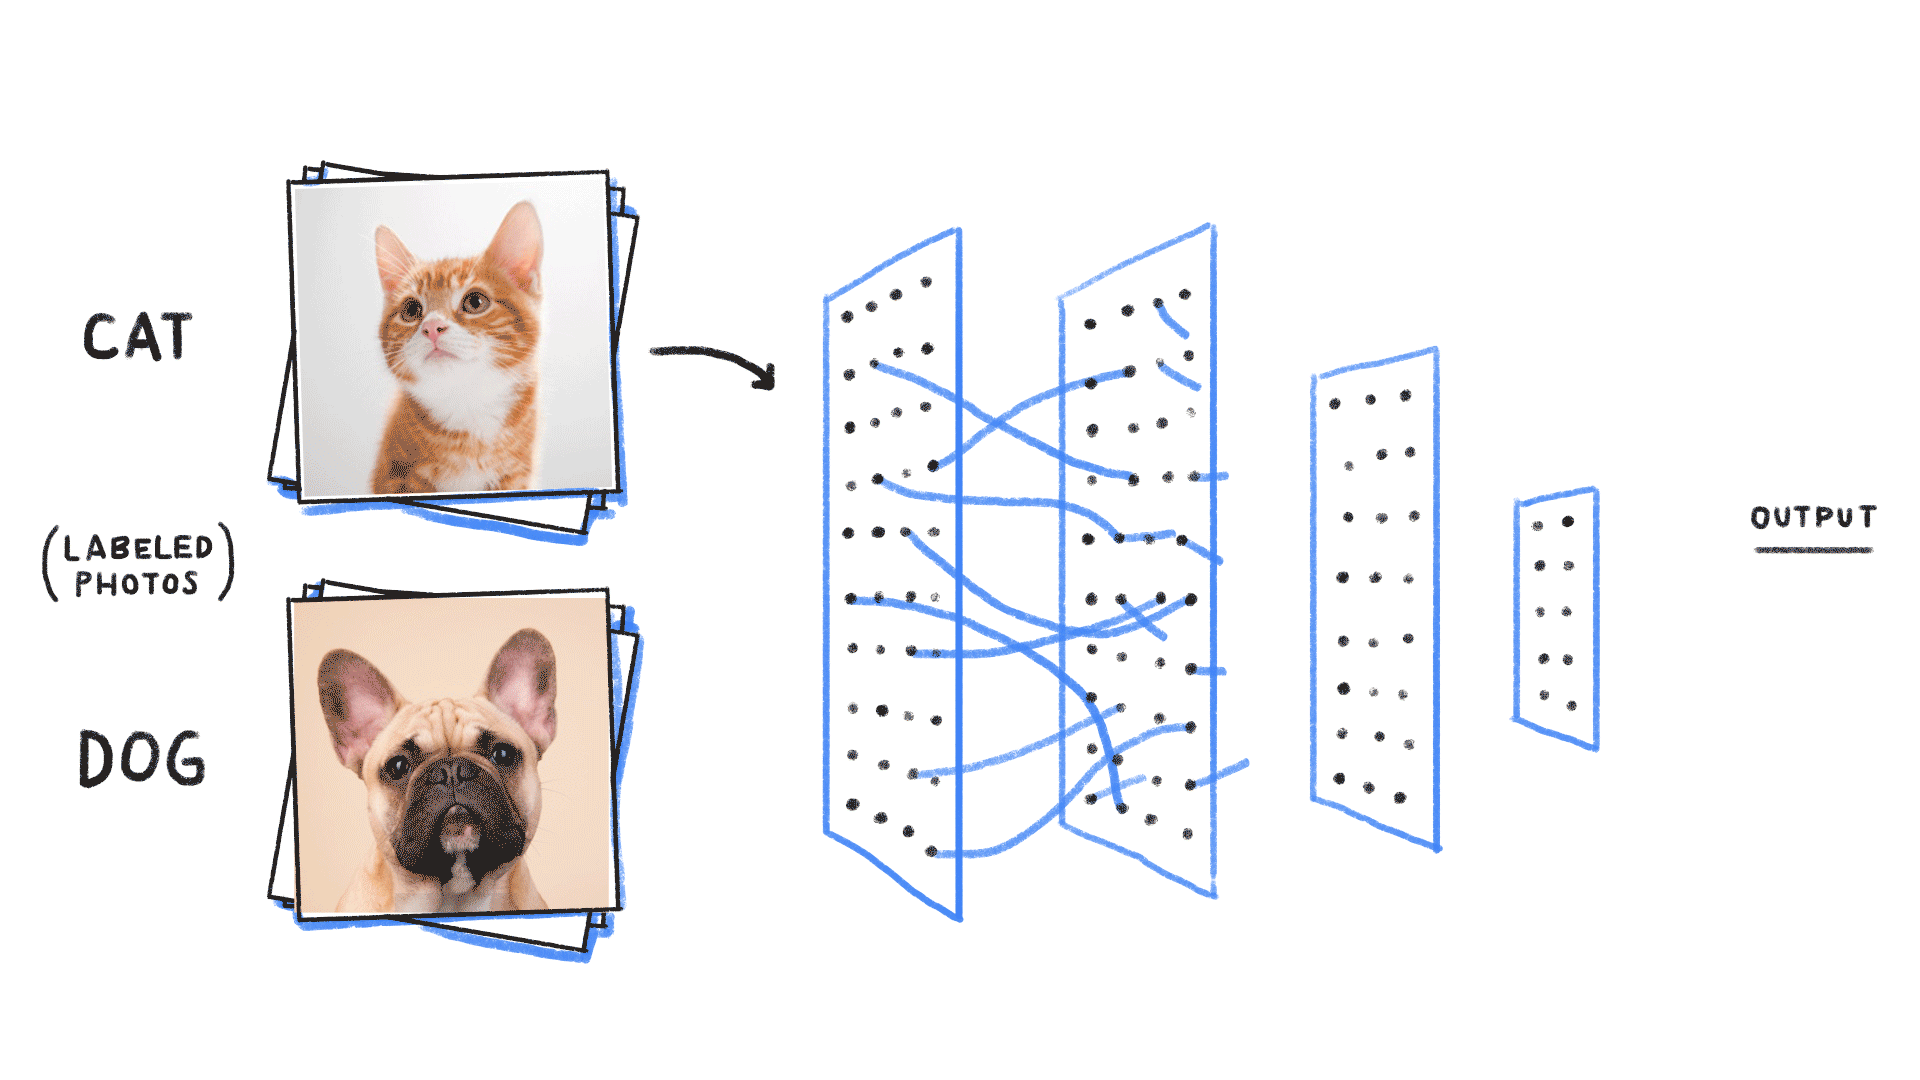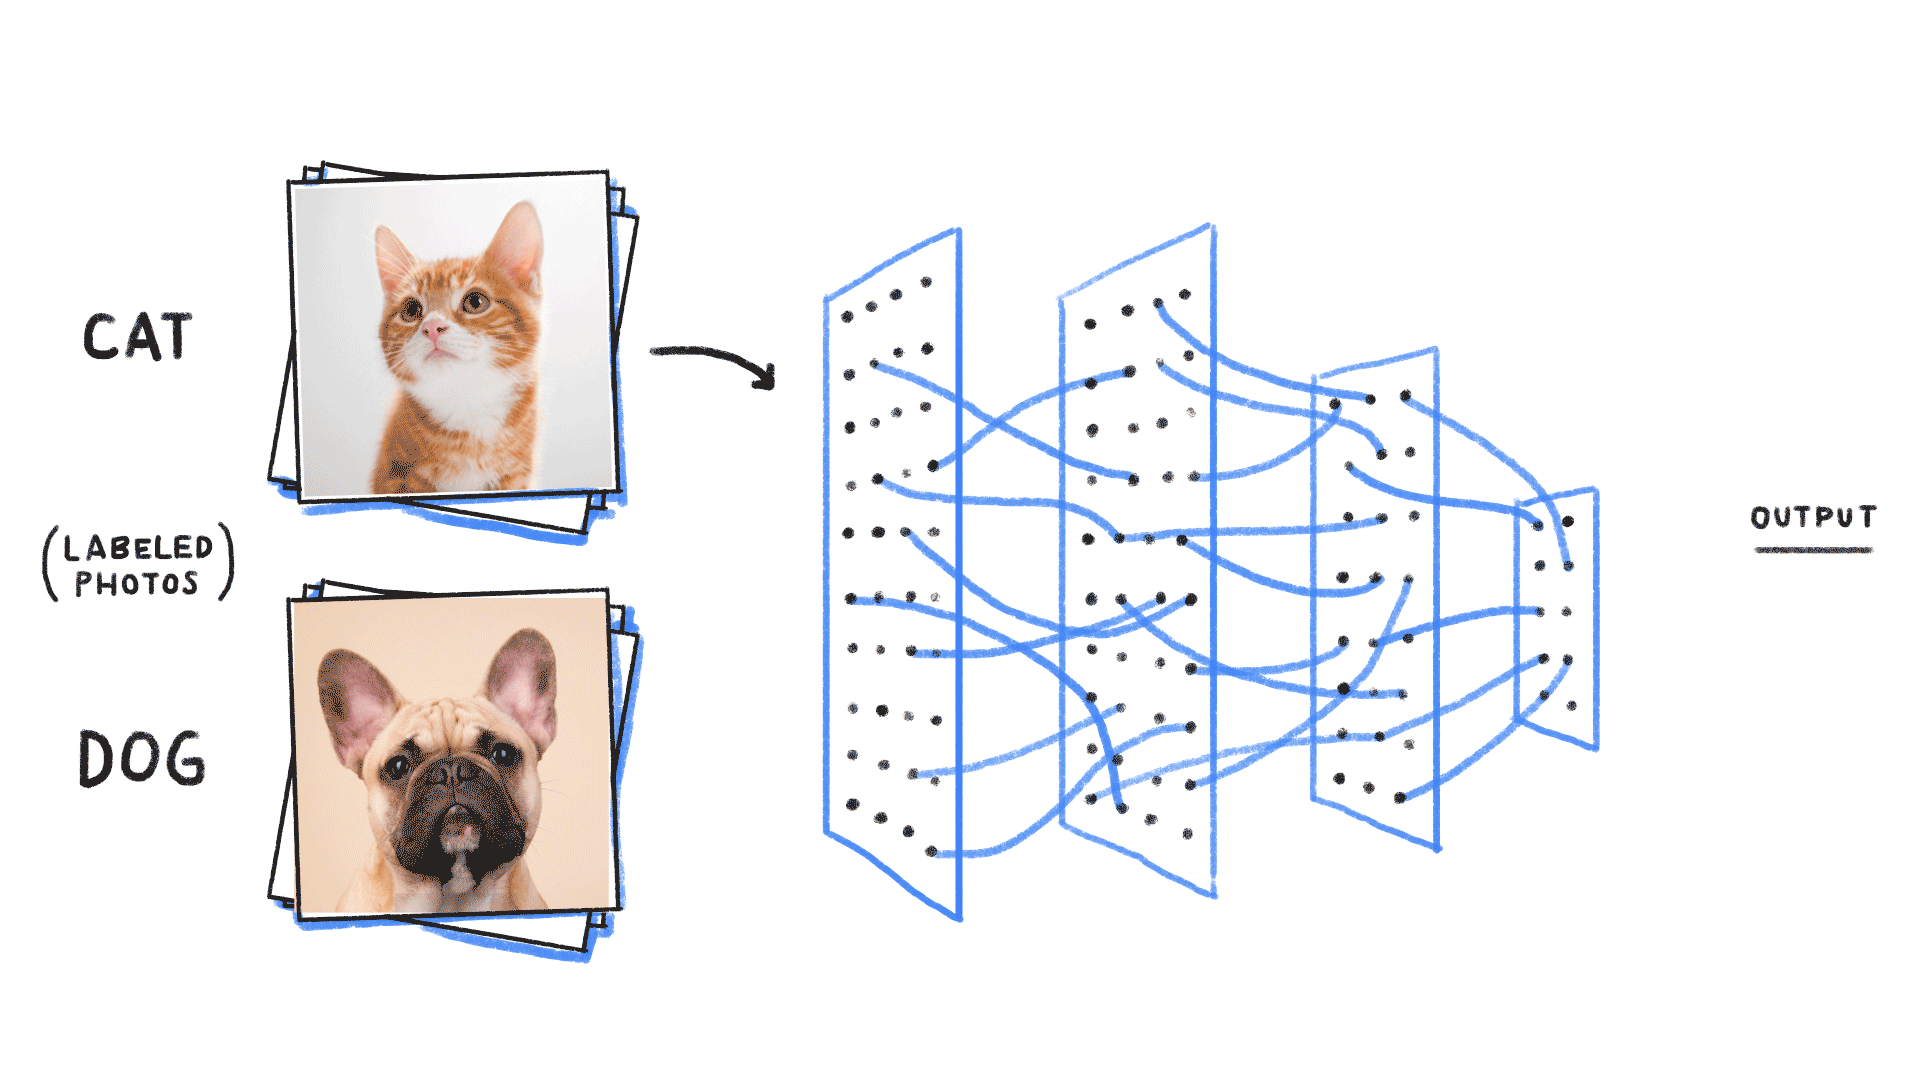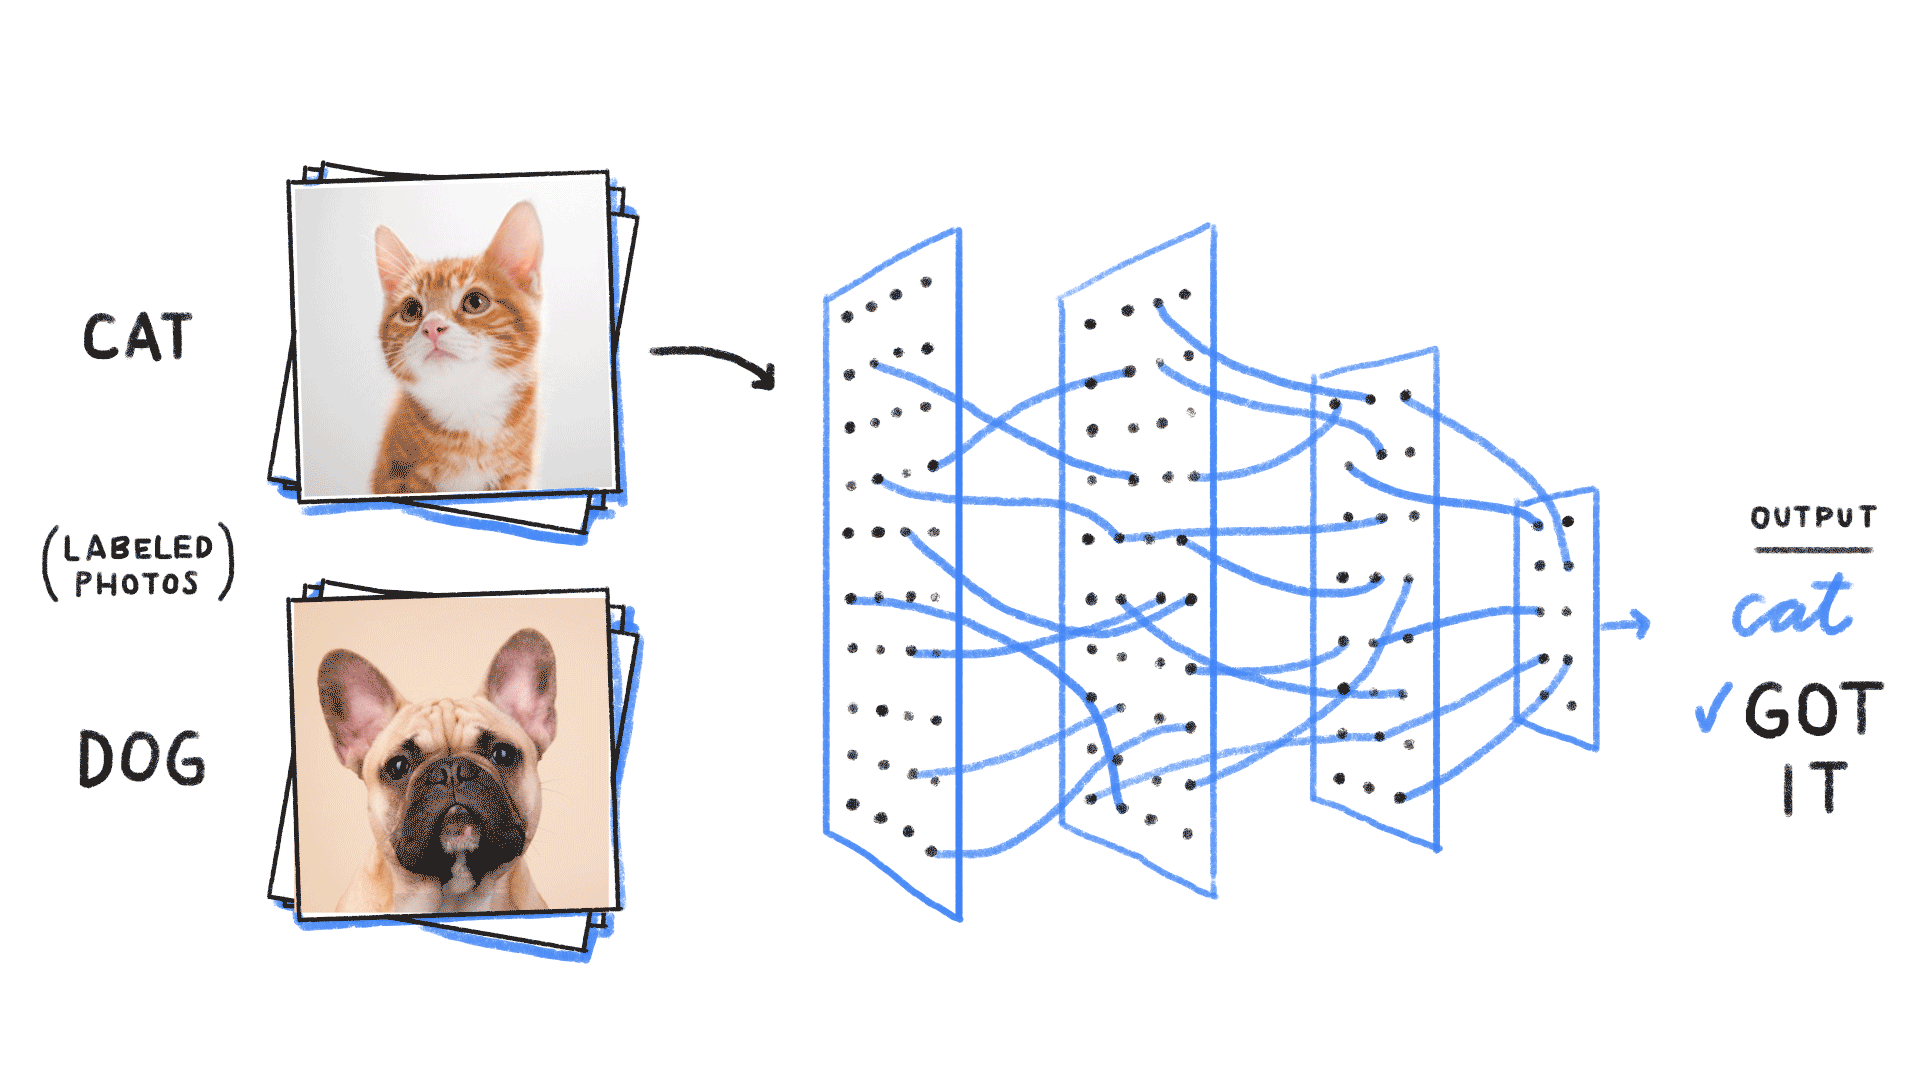
Maschinelles Lernen ist genau eine solche Methode, mit der Computer lernen können: Anstatt komplexe Regeln direkt zu schreiben, lassen wir Computer automatisch Muster und Regelmäßigkeiten aus großen Datenmengen entdecken.
Wie funktioniert maschinelles Lernen?
Maschinelles Lernen trifft Entscheidungen und Vorhersagen, indem es Computern ermöglicht, Muster und Regelmäßigkeiten aus großen Datenmengen zu lernen.
- Zuerst werden Daten gesammelt und vorbereitet, dann wird ein geeigneter Algorithmus ausgewählt, um das Modell zu trainieren.
- Dann optimiert das Modell kontinuierlich Parameter, um Vorhersagefehler zu minimieren, bis es neue Daten genau vorhersagen kann.
- Schließlich wird das Modell in realen Anwendungen eingesetzt, trifft in Echtzeit Vorhersagen oder Entscheidungen und wird basierend auf neuen Daten aktualisiert.
Maschinelles Lernen ist ein iterativer Prozess, der mehrere Anpassungen der Modellparameter und der Merkmalsauswahl erfordern kann, um die Modellleistung zu verbessern.
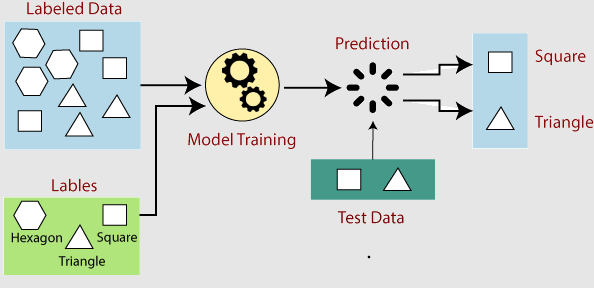
Das folgende Diagramm veranschaulicht den grundlegenden Arbeitsablauf des maschinellen Lernens:
-
Beschriftete Daten:: Der blaue Bereich in der Abbildung zeigt beschriftete Daten, die verschiedene geometrische Formen enthalten (wie Sechsecke, Quadrate, Dreiecke).
-
Modelltraining:: In dieser Phase analysiert der Algorithmus des maschinellen Lernens die Merkmale der Daten und lernt, wie Labels basierend auf diesen Merkmalen vorhergesagt werden.
-
Testdaten:: Der dunkelgrüne Bereich in der Abbildung zeigt Testdaten, darunter ein Quadrat und ein Dreieck.
-
Vorhersage:: Das Modell verwendet aus den Trainingsdaten gelernte Regeln, um die Labels der Testdaten vorherzusagen. In der Abbildung sagt das Modell das Quadrat und das Dreieck in den Testdaten voraus.
-
Bewertung:: Die Vorhersageergebnisse werden mit den wahren Labels der Testdaten verglichen, um die Genauigkeit des Modells zu bewerten.
Der Arbeitsablauf des maschinellen Lernens kann grob in die folgenden Schritte unterteilt werden:
1. Datenerfassung
- Daten sammeln: Dies ist der erste Schritt eines Projekts für maschinelles Lernen und umfasst das Sammeln relevanter Daten. Daten können aus Datenbanken, Dateien, dem Web oder Echtzeit-Datenströmen stammen.
- Datentypen: Sie können strukturierte Daten (wie Tabellendaten) oder unstrukturierte Daten (wie Text, Bilder, Videos) sein.
2. Datenvorverarbeitung
- Daten bereinigen: Umgang mit fehlenden Werten, Ausreißern, Fehlern und doppelten Daten.
- Feature-Engineering: Wählen Sie die relevantesten Merkmale aus, die dem Modell beim Lernen helfen; dies kann das Erstellen neuer Merkmale oder das Transformieren bestehender Merkmale umfassen.
- Datenstandardisierung/-normalisierung: Passen Sie die Skala der Daten an, um die Daten in denselben Bereich zu bringen, was die Leistung bestimmter Algorithmen verbessert.
3. Modellauswahl
- Problemtyp bestimmen: Wählen Sie ein geeignetes Machine-Learning-Modell basierend auf der Art des Problems (Klassifikation, Regression, Clustering usw.).
- Algorithmus auswählen: Wählen Sie basierend auf dem Problemtyp und den Datenmerkmalen einen oder mehrere Algorithmen zum Experimentieren aus.
4. Modelltraining
- Datensatz aufteilen: Teilen Sie die Daten in Trainings-, Validierungs- und Testsets auf.
- Training: Verwenden Sie die Daten im Trainingsset, um das Modell zu trainieren, und passen Sie die Modellparameter an, um die Verlustfunktion zu minimieren.
- Validierung: Verwenden Sie das Validierungsset, um Modellparameter anzupassen und Overfitting zu vermeiden.
5. Modellbewertung
- Leistungsmetriken: Verwenden Sie das Testset, um die Leistung des Modells zu bewerten. Häufige Metriken sind Genauigkeit, Recall, F1-Score usw.
- Kreuzvalidierung: Eine Technik zur Bewertung der Generalisierungsfähigkeit eines Modells, indem die Daten in mehrere Teilmengen für Training und Validierung aufgeteilt werden.
6. Modelloptimierung
- Hyperparameter anpassen: Hyperparameter sind Parameter, die vor dem Lernprozess festgelegt werden, wie Lernrate, Baumtiefe usw. Sie können mit Methoden wie Grid Search, Random Search oder Bayesscher Optimierung abgestimmt werden.
- Merkmalsauswahl: Es kann notwendig sein, Merkmale erneut zu bewerten und auszuwählen, um die Modellleistung zu verbessern.
7. Modellbereitstellung
- In Anwendungen integrieren: Integrieren Sie das trainierte Modell in reale Anwendungen wie Websites, mobile Apps oder Software.
- Überwachung und Wartung: Überwachen Sie kontinuierlich die Leistung des Modells und aktualisieren Sie das Modell basierend auf neuen Daten.
8. Feedbackschleife
- Kontinuierliches Lernen: Modelle für maschinelles Lernen können so gestaltet werden, dass sie im Laufe der Zeit automatisch aus neuen Daten lernen, um sich an Veränderungen anzupassen.
Technische Details
- Verlustfunktion: Eine Funktion, die die Differenz zwischen Modellvorhersagen und tatsächlichen Ergebnissen misst. Das Ziel des Modelltrainings ist es, diese Funktion zu minimieren.
- Optimierungsalgorithmus: Wie etwa Gradientenabstieg, wird verwendet, um Parameterwerte zu finden, die die Verlustfunktion minimieren.
- Regularisierung: Eine Technik, die Überanpassung des Modells verhindert, indem Strafterme hinzugefügt werden.
Der Workflow des maschinellen Lernens ist iterativ und kann mehrere Anpassungen und Optimierungen erfordern, um die beste Leistung zu erzielen. Darüber hinaus können maschinelle Lernmodelle mit der Anhäufung von Daten und der Entwicklung von Algorithmen genauer und effizienter werden.
Arten des maschinellen Lernens
Maschinelles Lernen wird hauptsächlich in die folgenden drei Arten unterteilt:
1. Überwachtes Lernen
- Definition:Überwachtes Lernen bezeichnet das Training mit beschrifteten Daten, wobei das Modell die Beziehung zwischen Eingabedaten und Labels lernt, um Vorhersagen oder Klassifizierungen zu treffen.
- Anwendungen:Klassifikation (z. B. Spam-Erkennung), Regression (z. B. Vorhersage von Hauspreisen).
- Beispiele:Lineare Regression, Entscheidungsbäume, Support-Vektor-Maschinen (SVM).
2. Unüberwachtes Lernen
- Definition:Unüberwachtes Lernen verwendet unbeschriftete Daten, und das Modell versucht, zugrunde liegende Strukturen oder Muster in den Daten zu entdecken.
- Anwendungen:Clustering (z. B. Kundensegmentierung), Dimensionsreduktion (z. B. Datenvisualisierung).
- Beispiele:K-Means-Clustering, Hauptkomponentenanalyse (PCA).
3. Bestärkendes Lernen
- Definition:Bestärkendes Lernen beinhaltet die Interaktion mit der Umgebung, wobei ein Agent die optimale Strategie durch Versuch und Irrtum lernt, um langfristige Belohnungen zu maximieren. Nach jeder Aktion erhält das System eine Belohnung oder Strafe, um die Verhaltensverbesserung zu lenken.
- Anwendungen:Spiel-KI (z. B. AlphaGo), autonomes Fahren, Robotersteuerung.
- Beispiele:Q-Learning, Deep Q-Network (DQN).

Diese drei Arten des maschinellen Lernens haben jeweils eigene Anwendungsszenarien und Vorteile. Überwachtes Lernen eignet sich für Daten mit klaren Labels, unüberwachtes Lernen eignet sich für die Erforschung der zugrunde liegenden Struktur von Daten, und bestärkendes Lernen eignet sich für Szenarien, in denen die optimale Strategie durch Versuch und Irrtum erlernt werden muss.
Anwendungsbereiche des maschinellen Lernens
Empfehlungssysteme:Zum Beispiel empfiehlt Douyin Videos, die dich interessieren könnten, Taobao empfiehlt Produkte, die du kaufen könntest, und NetEase Cloud Music empfiehlt Musik, die dir gefällt.
Verarbeitung natürlicher Sprache (NLP):Anwendungen des maschinellen Lernens in Spracherkennung, maschineller Übersetzung, Sentimentanalyse, Chatbots und mehr. Zum Beispiel Google Translate, Siri und intelligenter Kundenservice.
Computer Vision:Maschinelles Lernen wird häufig in Bilderkennung, Objekterkennung, Gesichtserkennung, autonomem Fahren und anderen Bereichen eingesetzt. Zum Beispiel verwenden selbstfahrende Autos Kameras und Sensoren, um umgebende Hindernisse, Fußgänger und andere Fahrzeuge zu identifizieren.
Finanzanalyse:Maschinelles Lernen hat wichtige Anwendungen im Finanzwesen, wie Aktienmarktvorhersage, Kreditbewertung und Betrugserkennung. Zum Beispiel verwenden Banken maschinelles Lernen, um betrügerische Kreditkartentransaktionen zu erkennen.
Gesundheitswesen:Maschinelles Lernen hilft Ärzten, Krankheiten zu diagnostizieren, Nebenwirkungen von Medikamenten zu entdecken, den Krankheitsverlauf vorherzusagen und mehr. Zum Beispiel hilft IBMs Watson-System Ärzten, Patientendaten aus Krankenakten zu analysieren, und liefert Diagnose- und Behandlungsempfehlungen.
Gaming und Unterhaltung:Maschinelles Lernen wird nicht nur für intelligente Gegner in Spielen eingesetzt, sondern auch in Spieldesign, dynamischer Schwierigkeitsanpassung und anderen Bereichen. Zum Beispiel nutzte AlphaGo Deep-Learning-Techniken, um den Go-Weltmeister zu besiegen.
Die Zukunft des maschinellen Lernens
Mit dem explosionsartigen Wachstum des Datenvolumens und der Verbesserung der Rechenleistung werden sich die Anwendungen des maschinellen Lernens weiter ausdehnen und intelligentere und effizientere Systeme hervorbringen. Zum Beispiel:
Bestärkendes Lernen:Es ermöglicht Computern, komplexe Probleme durch Versuch und Irrtum ohne explizite Anleitung zu lösen. Zum Beispiel verwenden AlphaGo und die Spiel-KI von Dota 2 beide bestärkendes Lernen.
Selbstüberwachtes Lernen:Aktuelle Modelle des maschinellen Lernens benötigen normalerweise eine große Menge beschrifteter Daten für das Training, während selbstüberwachtes Lernen effektivere Repräsentationen aus unbeschrifteten Daten lernen kann.
Deep Learning:Deep Learning ist ein Teilgebiet des maschinellen Lernens, das sich auf die Anwendung neuronaler Netze konzentriert. Es hat bahnbrechende Fortschritte in der Bilderkennung, der Verarbeitung natürlicher Sprache und anderen Bereichen erzielt. In Zukunft wird Deep Learning die Entwicklung der künstlichen Intelligenz weiter vorantreiben.
Durch maschinelles Lernen können wir intelligentere Systeme schaffen, langwierige Aufgaben automatisieren und verschiedene Aspekte unseres täglichen Lebens verbessern. Mit der Entwicklung der Technologie wird maschinelles Lernen in Zukunft zu einer der zentralen Triebkräfte in verschiedenen Branchen werden.
Andere Erweiterungen