Entscheidungsbaum
Der Entscheidungsbaum ist ein häufig verwendeter Algorithmus des maschinellen Lernens und wird breit auf Klassifikations- und Regressionsprobleme angewendet.
Der Entscheidungsbaum stellt den Entscheidungsprozess durch eine Baumstruktur dar. Jeder interne Knoten repräsentiert einen Test auf ein Merkmal oder Attribut, jeder Zweig repräsentiert das Ergebnis des Tests, und jeder Blattknoten repräsentiert eine Klasse oder einen Wert.
Grundlegende Konzepte des Entscheidungsbaums
- Knoten: Jeder Punkt im Baum wird als Knoten bezeichnet. Der Wurzelknoten ist der Ausgangspunkt des Baums, interne Knoten sind Entscheidungspunkte und Blattknoten sind die endgültigen Entscheidungsergebnisse.
- Zweig: Der Pfad von einem Knoten zu einem anderen wird als Zweig bezeichnet.
- Aufteilung: Der Prozess, einen Datensatz basierend auf einem bestimmten Merkmal in mehrere Teilmengen aufzuteilen.
- Reinheit: Misst, ob die Klassen der Proben in einer Teilmenge konsistent sind. Je höher die Reinheit, desto ähnlicher sind die Proben in der Teilmenge.
Funktionsweise von Entscheidungsbäumen
Der Entscheidungsbaum erstellt die Baumstruktur, indem er den Datensatz rekursiv in kleinere Teilmengen aufteilt. Die einzelnen Schritte sind wie folgt:
- Bestes Merkmal auswählen: Wählen Sie das beste Merkmal für die Aufteilung basierend auf bestimmten Kriterien aus (wie Informationsgewinn, Gini-Index usw.).
- Datensatz aufteilen: Teilen Sie den Datensatz basierend auf dem ausgewählten Merkmal in mehrere Teilmengen auf.
- Rekursiv Unterbäume erstellen: Wiederholen Sie den obigen Prozess für jede Teilmenge, bis eine Abbruchbedingung erfüllt ist (z. B. alle Proben gehören derselben Klasse an, maximale Tiefe erreicht usw.).
- Blattknoten erzeugen: Wenn die Abbruchbedingung erfüllt ist, erzeugen Sie einen Blattknoten und weisen Sie eine Klasse oder einen Wert zu.
Kriterien für die Konstruktion von Entscheidungsbäumen
Beim Aufbau eines Entscheidungsbaums müssen wir das beste Merkmal zum Aufteilen auswählen. Gängige Kriterien sind:
1. Informationsgewinn
Wird für Klassifikationsprobleme verwendet und misst die Verbesserung der Reinheit des Datensatzes nach Auswahl eines Merkmals. Die Berechnungsformel lautet:
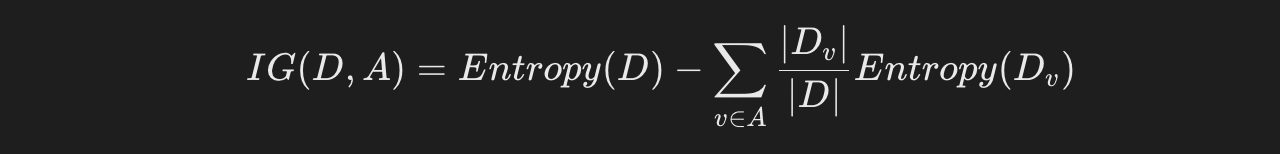
wobeiEntropiedie Entropie des Datensatzes ist, die zur Messung der Unsicherheit der Daten verwendet wird.
2. Gini-Index
Ebenfalls ein Aufteilungskriterium für Klassifikationsprobleme. Die Berechnungsformel lautet:
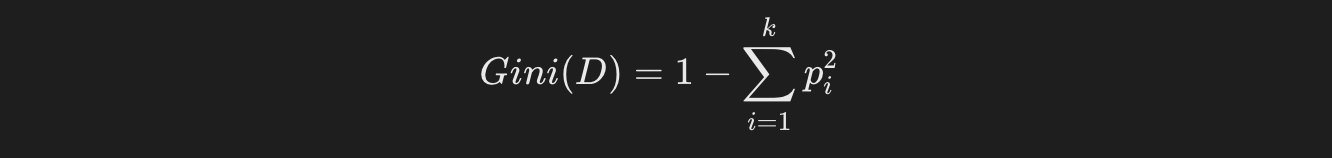
wobei pider Anteil der Proben der Klasse i ist. Je kleiner der Gini-Index, desto reiner ist der Datensatz.
3. Mittlerer quadratischer Fehler (MSE)
Wird für Regressionsprobleme verwendet und misst die Differenz zwischen vorhergesagten Werten und tatsächlichen Werten.
Je kleiner der MSE, desto besser ist die Vorhersageleistung des Regressionsbaums.
Vor- und Nachteile von Entscheidungsbäumen
Vorteile
- Leicht zu verstehen und zu interpretieren: Die Struktur eines Entscheidungsbaums ist intuitiv und leicht zu verstehen und zu interpretieren.
- Umgang mit mehreren Datentypen: Kann numerische und kategoriale Daten verarbeiten.
- Keine Notwendigkeit der Datenstandardisierung: Entscheidungsbäume erfordern keine Standardisierung oder Normalisierung der Daten.
Nachteile
- Anfällig für Overfitting: Entscheidungsbäume neigen zu Overfitting, insbesondere wenn der Datensatz klein oder die Baumtiefe groß ist.
- Empfindlich gegenüber Rauschen: Entscheidungsbäume sind empfindlich gegenüber verrauschten Daten, was die Modellleistung beeinträchtigen kann.
- Instabil: Kleine Änderungen in den Daten können zu einem völlig anderen Baum führen.
Implementierung eines Entscheidungsbaums mit Python
Als Nächstes verwenden wir Pythonsscikit-learnBibliothek zur Implementierung eines einfachen Entscheidungsbaum-Klassifikators.
1. Erforderliche Bibliotheken installieren
Stellen Sie zunächst sicher, dass Sie installiert habenscikit-learnBibliothek. Falls nicht, können Sie sie mit dem folgenden Befehl installieren:
pip install scikit-learn
2. Bibliotheken importieren und Datensatz laden
Wir werdenscikit-learnden integrierten Iris-Datensatz, um die Verwendung von Entscheidungsbäumen zu demonstrieren.
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Teile den Datensatz in Trainings- und Testsets auf
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Trainiere das Entscheidungsbaum-Modell
Als Nächstes verwenden wirDecisionTreeClassifierum das Entscheidungsbaum-Modell zu trainieren.
Beispiel
clf = DecisionTreeClassifier()
# Modell trainieren
clf.fit(X_train, y_train)
4. Vorhersage und Bewertung
Verwende das trainierte Modell, um das Testset vorherzusagen und die Genauigkeit des Modells zu bewerten.
Beispiel
y_pred = clf.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.2f}")
Ausgabeergebnis:
模型准确率: 1.00
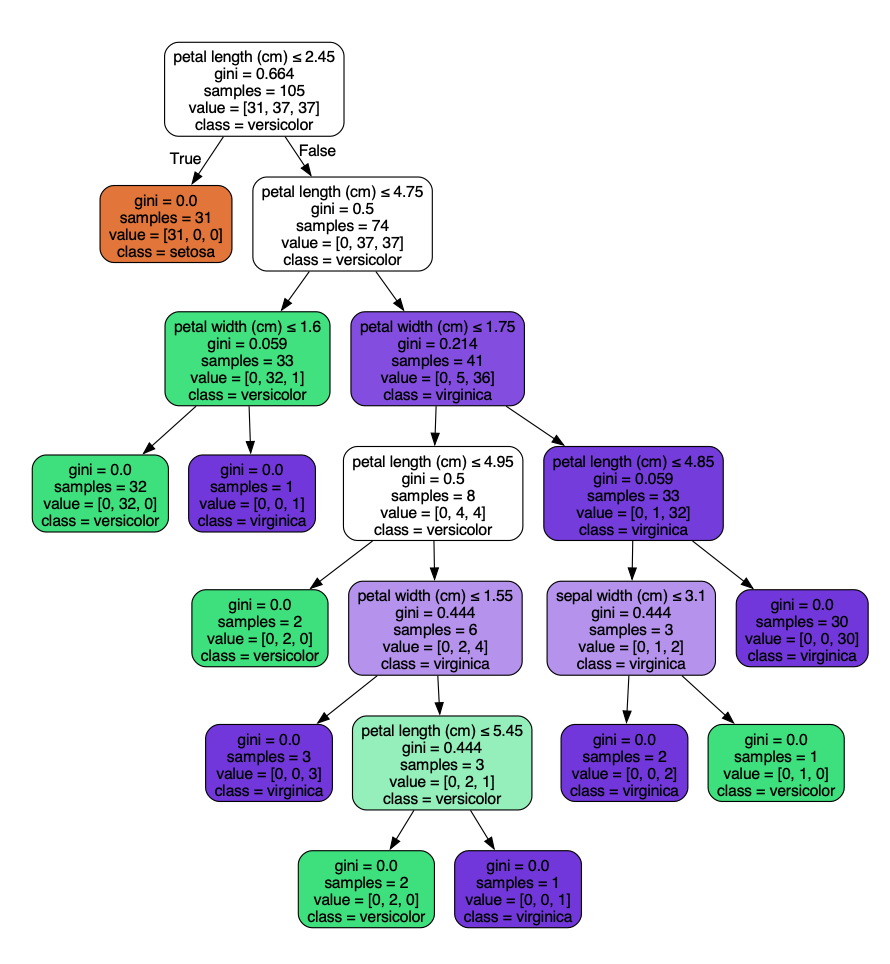
5. Entscheidungsbaum visualisieren
Um die Struktur des Entscheidungsbaums intuitiver zu verstehen, können wirgraphvizdie Bibliothek verwenden, um den Entscheidungsbaum zu visualisieren.
Graphviz-Downloadadresse:https://graphviz.org/download/
- Unter Windows können Sie das Installationspaket für Windows herunterladen (.msi-Datei).
- Unter Linux können Sie es mit dem Paketmanager-Befehl installieren, z. B.apt install graphviz
- macOS-Installationsbefehlbrew install graphviz。
Alternativ können Sie aus dem Quellcode installieren, indem Sie das neueste Quellpaket (.tar.gz-Datei) herunterladen.
tar -zxvf graphviz-<version>.tar.gz
cd graphviz-<version>
./configure
make
sudo make install
Nach der Installation können Sie mit dem folgenden Befehl überprüfen, ob Graphviz erfolgreich installiert wurde:
dot -V
Wenn die Ausgabe wie die folgende aussieht, war die Installation erfolgreich:
dot - graphviz version 12.2.1 (20241206.2353)
InstallationgraphvizBibliothek:
Beispiel
Verwenden Sie dann den folgenden Code, um die Visualisierung des Entscheidungsbaums zu erzeugen:
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import export_graphviz
import graphviz
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Teile den Datensatz in Trainings- und Testsets auf
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Erstelle einen Entscheidungsbaum-Klassifikator
clf = DecisionTreeClassifier()
# Modell trainieren
clf.fit(X_train, y_train)
# Vorhersage auf dem Testset
y_pred = clf.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.2f}")
# Den Entscheidungsbaum in eine dot-Datei exportieren
dot_data = export_graphviz(clf, out_file=None,
feature_names=iris.feature_names,
class_names=iris.target_names,
filled=True, rounded=True,
special_characters=True)
# Den Entscheidungsbaum mit graphviz rendern
graph = graphviz.Source(dot_data)
graph.render("iris_decision_tree") # Als PDF-Datei speichern
graph.view() # Im Browser anzeigen
Wenn Sie den obigen Code ausführen, wird eine Datei iris_decision_tree.pdf erzeugt, die wie folgt angezeigt wird: