Probabilistisches Denken
Stellen Sie sich vor, Sie bringen einem Freund bei, Fotos von Katzen und Hunden zu erkennen. Sie würden nicht sagen: „Dieses Bild ist zu 100% eine Katze“; stattdessen würden Sie vielleicht sagen: „Dieses Bild ist mit 90% Wahrscheinlichkeit eine Katze, weil es spitze Ohren und Schnurrhaare hat.“ Dieser Ausdruck von Wahrscheinlichkeit ist genauDes probabilistischen DenkensKern.
In der realen Welt sind die von Modellen des maschinellen Lernens verarbeiteten Daten fast immer vollerUnsicherheit: Bilder können unscharf sein, Sprache kann Rauschen enthalten, und Nutzerverhalten ist schwer vorherzusagen. Die Wahrscheinlichkeit bietet uns eine rigorose mathematische Sprache, um diese Unsicherheit zu beschreiben, zu quantifizieren und zu handhaben. Sie ist nicht nur die Grundlage fortgeschrittener Modelle (wie Bayes-Netze und Gauß-Prozesse), sondern auch der Schlüssel zum Verständnis von Modellausgaben, zur Bewertung der Vorhersagekonfidenz und zum Treffen robuster Entscheidungen.
Kurz gesagt,probabilistisches Denken ist dieBrücke, dieRatenin quantifizierbare Konfidenz verwandelt,, und es ist ein wichtiger Schritt für das maschinelle Lernen, sich vonfest codierten Regelnhin zuintelligentem Schlussfolgern.
Kurze Einführung in die Kernkonzepte der Wahrscheinlichkeit
Bevor wir in Anwendungen des maschinellen Lernens eintauchen, müssen wir einige grundlegende Wahrscheinlichkeitskonzepte festlegen.
1. Was ist Wahrscheinlichkeit?
Wahrscheinlichkeitist ein Maß für die Wahrscheinlichkeit, dass ein Ereignis eintritt, und reicht von 0 bis 1.
P(A) = 0: Ereignis Akann nichteintreten.P(A) = 1: Ereignis Awird mit Sicherheiteintreten.0 < P(A) < 1: Ereignis A tritt mit einer bestimmtenWahrscheinlichkeit auf..
Im maschinellen Lernen könnte ein Ereignis sein: Dieses Bild ist eine Katze, der Nutzer wird morgen auf diese Anzeige klicken, das nächste Wort ist"hello"。
2. Bedingte Wahrscheinlichkeit: Die Welt ist miteinander verbunden
Bedingte Wahrscheinlichkeit P(A|B)bezeichnet die Wahrscheinlichkeit, dass Ereignis A eintritt, unter der Bedingung, dass Ereignis Bbereits eingetreten ist. Dies ist ein entscheidendes Konzept im maschinellen Lernen.
Eine nachvollziehbare Analogie:
P(下雨): Die allgemeine Wahrscheinlichkeit für Regen heute (A-priori-Wahrscheinlichkeit).P(下雨 | 乌云密布): Die Wahrscheinlichkeit für Regen heute, unter der Bedingung, dass "dunkle Wolken ziehen auf" bereits beobachtet wurde (A-posteriori-Wahrscheinlichkeit). Offensichtlich ist der letztere Wahrscheinlichkeitswert höher.
Formel:
P(A|B) = P(A 且 B) / P(B), was erfordertP(B) > 0。
3. Bayes-Theorem: Von Ergebnissen auf Ursachen schließen
Das Bayes-Theorem ist eine elegante Anwendung der bedingten Wahrscheinlichkeit; es lehrt uns, wie wirneue Evidenz (Daten) nutzen, um unsere Überzeugung von einer Hypothese zu aktualisieren。
Formel:
P(假设 | 数据) = [ P(数据 | 假设) * P(假设) ] / P(数据)
Zerlegen wir diese "magische Formel".:
P(假设):A-priori-Wahrscheinlichkeit. Bevor wir irgendwelche Daten sehen, ist dies unsere anfängliche Überzeugung über die Hypothese.- Zum Beispiel: Bevor wir eine E-Mail erhalten, glauben wir, dass die Wahrscheinlichkeit, dass eine beliebige E-Mail Spam ist, 30% beträgt.
P(数据 | 假设):Likelihood. Wenn die Hypothese gilt, wie wahrscheinlich ist es, dass wir den aktuellen Datenstapel beobachten?- Zum Beispiel: Wenn eine E-Mail tatsächlich Spam ist, wie hoch ist die Wahrscheinlichkeit, dass Wörter wie "free" und "winning" darin vorkommen?
P(数据):Evidenz. Die Gesamtwahrscheinlichkeit der Beobachtung der aktuellen Daten, üblicherweise eine Normalisierungskonstante.P(假设 | 数据):A-posteriori-Wahrscheinlichkeit. Nach Beobachtung der Daten ist dies unsere aktualisierte Überzeugung über die Hypothese.Dies ist das Ziel, das wir letztendlich anstreben!- Zum Beispiel: Nachdem wir gesehen haben, dass die E-Mail Wörter wie "free" und "winning" enthält, beträgt die aktualisierte Wahrscheinlichkeit, dass diese E-Mail Spam ist, 95%.
Das Wesen des Bayes-Theorems: Es bietet einen systematischen Rahmen, der unserVorwissen(P(假设)) mitbeobachteten Daten(P(数据|假设)), um ein genaueresaktualisiertes Verständnis zu erhalten.(P(假设|数据))。
Teil 2: Die drei Rollen der Wahrscheinlichkeit im maschinellen Lernen
Probabilistisches Denken durchdringt jede Phase des maschinellen Lernens und spielt hauptsächlich die folgenden drei Rollen:
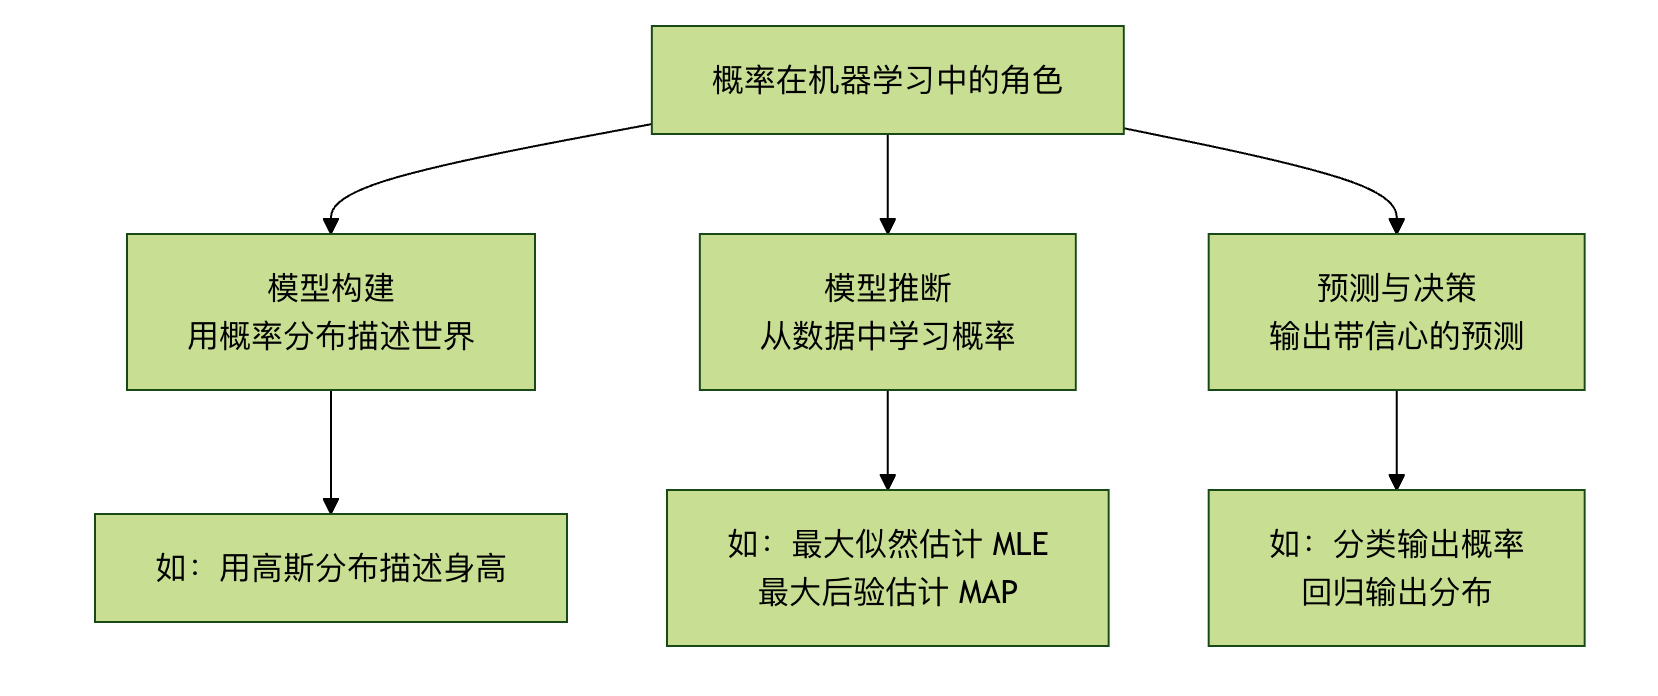
Rolle 1: Modellkonstruktion — Die Welt mit Wahrscheinlichkeit beschreiben
Viele Machine-Learning-Modelle sind im Wesentlichenprobabilistische Modelle. Wir nehmen an, dass die beobachteten Daten durch eine zugrunde liegende Wahrscheinlichkeitsverteilung erzeugt werden.
Beispiel 1: Logistische RegressionEs gibt direkt einen Wahrscheinlichkeitswert aus. Bei einem binären Klassifikationsproblem (Katze/Hund) sagt das logistische Regressionsmodell nicht nur "das ist eine Katze"; stattdessen erfolgt die AusgabeP(类别=猫 | 图像数据)=0.9, was anzeigt, dass das Modell mit 90% Sicherheit davon ausgeht, dass dies eine Katze ist.
Beispiel 2: Naiver-Bayes-KlassifikatorEr wendet den Satz von Bayes direkt zur Klassifikation an. Er nimmt an, dass die Merkmale voneinander unabhängig sind, und berechnetP(垃圾邮件 | 词1, 词2...), und wählt dann die Kategorie mit der höheren Wahrscheinlichkeit aus.
Beispiel
# Angenommen, wir haben die folgenden Wahrscheinlichkeiten aus den Daten geschätzt (Likelihoods und Priors)
P_word_given_spam= {"free": 0.8, "meeting": 0.1} # Die Wahrscheinlichkeit, dass "free" in Spam vorkommt
P_word_given_normal= {"free": 0.1, "meeting": 0.9} # Die Wahrscheinlichkeit, dass "meeting" in normalen E-Mails vorkommt
P_garbage= 0.3 # A-priori-Wahrscheinlichkeit: die Wahrscheinlichkeit, dass eine beliebige E-Mail Spam ist
P_normal= 0.7 # A-priori-Wahrscheinlichkeit: die Wahrscheinlichkeit, dass eine beliebige E-Mail normal ist
# Für eine E-Mail, die "free" und "meeting" enthält, berechne die Posterior-Wahrscheinlichkeit, dass sie Spam ist (vereinfachte Berechnung)
# Nach dem Satz von Bayes (ignoriere den Evidenz-Nenner, da er sich beim Vergleich herauskürzt)
score_spam=P_word_given_spam["free"]* P_word_given_spam["meeting"]* P_spam
score_normal=P_word_given_normal["free"]* P_word_given_normal["meeting"]* P_normal
print(f"Spam-Wert: {score_垃圾:.4f}")
print(fWert für normale E-Mail: {score_normal:.4f})
ifscore_spam>score_normal:
print("Vorhersage: Dies ist eine Spam-E-Mail.")
else:
print("Vorhersage: Dies ist eine normale E-Mail.")
Rolle 2: Modellinferenz und Lernen — Die wahrscheinlichste Erklärung finden
Wie finden wir aus den Daten das probabilistische Modell, das diese Daten am wahrscheinlichsten erzeugt hat (d. h. Modellparameter zu lernen)? Hier sind zwei Kernideen:
1. Maximum-Likelihood-Schätzung Kernidee: Finde die Modellparameter, die dieWahrscheinlichkeit, die aktuellen Daten zu beobachten,(die Likelihood) maximieren.Analogie: Ein Detektiv, der einen Fall löst. Der Detektiv fragt: "Unter welchem Motiv und welcher Methode wäre es am wahrscheinlichsten, alle Tatortspuren zu erzeugen, die wir aktuell sehen?" MLE dreht sich genau darum, diese "wahrscheinlichste" Hypothese zu finden.Vorteile: Datengetrieben, vollständig auf den Daten basierend.Mögliche Nachteile: Wenn die Datenmenge klein ist, kann es überanpassen; es ignoriert Vorwissen.
2. Maximum-A-Posteriori-Schätzung
Kernidee: Aufbauend auf der Maximum-Likelihood-Schätzung bezieht sie unserVorwissen über die Parameter ein(P(假设)) und findet die Parameter, die die A-posteriori-Wahrscheinlichkeit maximieren.Analogie: Ein erfahrener Detektiv, der einen Fall löst. Er untersucht nicht nur die Tatortspuren (Daten), sondern kombiniert auch den bekannten Modus Operandi des Verdächtigen (Prior), um ein umfassendes Urteil zu fällen.Vorteile: Es kann Domänenwissen nutzen, ist bei kleinen Datensätzen robuster und verhindert Overfitting.
| Kriterium | Vollständiger Name | Optimierungsziel | Kernidee | Anschauliche Analogie |
|---|---|---|---|---|
| MLE | Maximum-Likelihood-Schätzung | Maximiere P(data | parameters) | Datengetrieben: Finden Sie anhand der beobachteten Daten die Modellparameter, die diese Daten am wahrscheinlichsten erzeugt haben. | Detektiv, der einen Fall löst: Identifizierung eines Verdächtigen allein anhand von Beweisen vom Tatort |
| MAP | Maximum-a-posteriori-Schätzung | Maximiere P(Parameter | Daten) | Prior + Daten: Kombiniere Vorwissen und beobachtete Daten, berechne die Posterior-Wahrscheinlichkeit der Parameter und nimm das Maximum | Richter, der einen Fall entscheidet: Urteilsfindung auf Grundlage von Rechtsvorschriften (Prior) und Beweisen (Daten) |
Rolle 3: Vorhersage und Entscheidungsfindung — Antworten mit Konfidenz ausgeben
Ein gutes Modell sollte nicht nur Vorhersagen liefern, sondern auchdie Unsicherheit der Vorhersagen angeben。
- Klassifikationsaufgaben: Gib die Wahrscheinlichkeit jeder Kategorie aus (z. B. cat: 0.85, dog: 0.12, rabbit: 0.03). Das enthält mehr Informationen, als einfach "cat" auszugeben. Wir können Entscheidungen anhand von Wahrscheinlichkeitsschwellen treffen (z. B. nur übernehmen, wenn die höchste Wahrscheinlichkeit > 0.8 ist).
- Regressionsaufgaben: Fortgeschrittene Regressionsmodelle (wie probabilistische Regression, Bayesianische lineare Regression) können eineVerteilung(wie eine Gauß-Verteilung) vorhersagen, statt nur eine Punktschätzung. Sie sagen Ihnen: "Der vorhergesagte Preis beträgt 1 Million Yuan, und es besteht 95% Konfidenz, dass der wahre Preis zwischen 950,000 und 1,050,000 yuan liegt."
Teil 3: Praktische Übung — Lösen eines einfachen Problems mit probabilistischem Denken
Szenario: Ein einfacher Krankheitstest. Gegeben:
- Die Prävalenz der Krankheit in der Allgemeinbevölkerung (A-priori-Wahrscheinlichkeit)
P(病) = 0.001。 - Die Genauigkeit des Tests: Wenn die Person wirklich krank ist, die Wahrscheinlichkeit eines positiven Testergebnisses
P(阳|病) = 0.99(Sensitivität). Wenn nicht krank, die Wahrscheinlichkeit eines negativen TestergebnissesP(阴|健康) = 0.99(Spezifität). - Frage: Wenn eine Person positiv getestet wird, ist die Wahrscheinlichkeit, dass sie tatsächlich die Krankheit hat
P(病|阳)wie hoch?
Die Intuitionsfalle: Viele Menschen würden denken, sie sei so hoch wie 99%. Verwenden wir den Satz von Bayes, um dies zu berechnen.
Beispiel
P_disease = 0.001 # P(Krankheit)
P_positive_given_disease = 0.99 # P(positiv|Krankheit)
P_negative_given_healthy = 0.99 # P(negativ|gesund)
# Abgeleitete Wahrscheinlichkeiten berechnen
P_healthy = 1 - P_disease # P(gesund)
P_positive_given_healthy = 1 - P_negative_given_healthy # P(positiv|gesund) = 1 - Spezifität
# Berechne die Gesamtwahrscheinlichkeit P(positiv)
# P(positiv) = P(positiv|Krankheit)*P(Krankheit) + P(positiv|gesund)*P(gesund)
P_positive = (P_positive_given_disease * P_disease) + (P_positive_given_healthy * P_healthy)
# Bayes-Theorem anwenden, um P(Krankheit|positiv) zu berechnen
P_disease_given_positive = (P_positive_given_disease * P_disease) / P_positive
print(f"Selbst wenn der Test positiv ist, beträgt die A-posteriori-Wahrscheinlichkeit, tatsächlich an der Krankheit zu leiden, P(Krankheit|positiv), nur: {P_disease_given_positive:.2%}")
Ausführungsergebnisse und Reflexion:
Sie werden überrascht feststellen, dassP(病|阳)es beträgt nur etwa9%! Das liegt daran, dass die Krankheitsprävalenz sehr niedrig ist (niedrige A-priori-Wahrscheinlichkeit), wodurch weit mehr falsch-positive als richtig-positive Ergebnisse entstehen. Dieses Beispiel zeigt eindrucksvoll:
- Die Bedeutung von Vorwissen: Das Ignorieren der Basisrate kann zu schwerwiegenden Fehleinschätzungen führen.
- Die Kraft des Bayesschen Denkens: Sie zwingt uns, alle relevanten Informationen (Basisrate, Testgenauigkeit) zu berücksichtigen.
- Die Praktikabilität probabilistischen Denkens: Sie kann systematische Verzerrungen in unserer Intuition korrigieren.
Zusammenfassung und weiterführende Richtungen
Wichtigste Erkenntnisse aus dem probabilistischen Denken:
- Unsicherheit akzeptieren: Die Welt ist unsicher, und die Ausgabe von Modellen sollte ebenfalls probabilistisch sein.
- Bayes ist eine Philosophie der Aktualisierung: Durch das
Prior + Data -> PosteriorFramework, überarbeiten Sie die Kognition kontinuierlich mit neuen Belegen. - Entscheidungen erfordern Wahrscheinlichkeit: Eine gute Vorhersage sollte mit einem "Konfidenzwert" einhergehen, um Entscheidungen mit kontrolliertem Risiko zu unterstützen.
Wenn Sie tiefer einsteigen möchten:
- Theoretische Ebene: Studieren Sieprobabilistische grafische Modelle, die komplexe probabilistische Abhängigkeiten zwischen Variablen mithilfe von Graphstrukturen elegant darstellen.
- Algorithmische Ebene: Erkunden SieVariationsinferenzundMarkov-Chain-Monte-CarloMethoden, die leistungsstarke Werkzeuge zur Lösung komplexer Bayes-Modelle sind.
- Anwendungsebene: Recherchieren SieBayessche Optimierung(zur Hyperparameter-Optimierung),Gauß-Prozesse(für Regression und Optimierung), undtiefe generative Modelle(wie Variational Autoencoders (VAE), Diffusionsmodelle).