Lebenszyklus eines Machine-Learning-Projekts
Ein Machine-Learning-Projekt ist wie der Bau eines Hauses; es erfordert einen vollständigen Prozess vom Entwurf über den Bau bis zur Endabnahme. Jeder Schritt ist entscheidend und unverzichtbar.
Die sechs Kernphasen des Machine-Learning-Workflows:
- Problemdefinition: klären, welches Problem gelöst werden soll
- Datenerfassung: relevante Daten beschaffen
- Datenvorbereitung: Daten bereinigen und vorverarbeiten
- Modelltraining: Algorithmen auswählen und Modelle trainieren
- Modellbewertung: Modellleistung bewerten
- Modellbereitstellung: das Modell in Betrieb nehmen
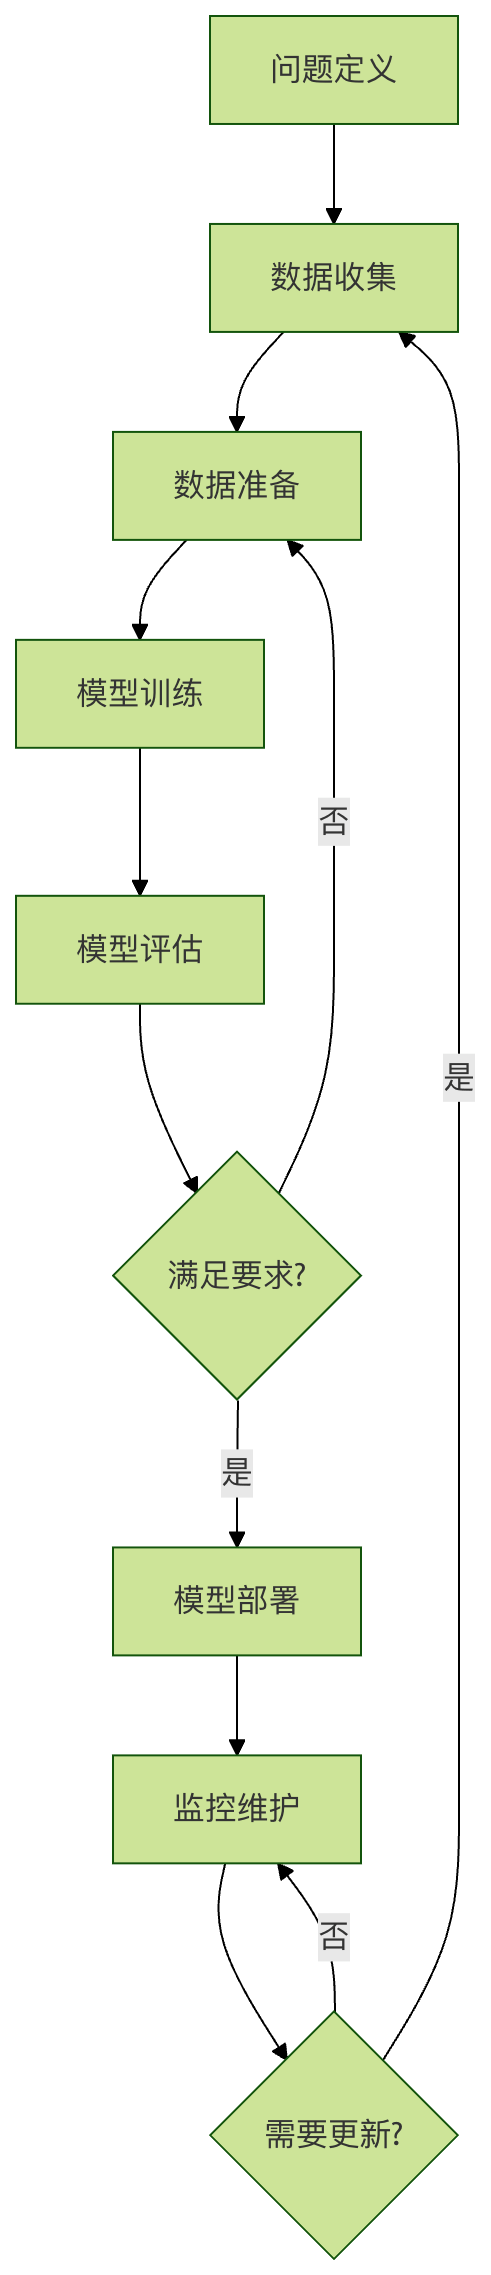
Phase 1: Problemdefinition
Definieren Sie das Geschäftsproblem
Die Problemdefinition ist der wichtigste Ausgangspunkt eines Machine-Learning-Projekts, genauso wie Sie Ihr Ziel kennen müssen, bevor Sie eine Navigation verwenden.
Schlüsselfragen
Welches Problem versuchen wir zu lösen?
- Klassifikation: Bestimmen, ob eine E-Mail Spam ist
- Regression: Hauspreise vorhersagen
- Clustering: Kundensegmentierung
- Anomalieerkennung: Kreditkartenbetrug erkennen
Warum ist dieses Problem wichtig?
- Geschäftlicher Nutzen: Effizienz verbessern, Kosten senken, Umsatz steigern
- Nutzerwert: Nutzererlebnis verbessern, personalisierte Dienste anbieten
Was sind die Kriterien für den Erfolg?
- Quantitative Metriken: Genauigkeit über 90%
- Geschäftsmetriken: Steigerung der Konversionsrate um 20%
Beispiel für Problemdefinition
Beispiel
class ProblemDefinition:
def __init__(self):
# Geschäftsproblem
self.business_problem = "Die Kaufkonversionsrate von Nutzern ist niedrig; die Empfehlungsgenauigkeit muss verbessert werden"
# Technisches Problem
self.technical_problem = "Vorhersage von Produkten, die ein Nutzer wahrscheinlich kauft, basierend auf dem Nutzerverhalten"
# Problemtyp
self.problem_type = "Empfehlungssystem (Klassifikation + Ranking)"
# Erfolgskriterien
self.success_criteria = {
"Verbesserung der Klickrate": "15%",
"Verbesserung der Konversionsrate": "10%",
"Empfehlungsgenauigkeit": "80%"
}
# Einschränkungen
self.constraints = {
"Antwortzeit": "< 100ms",
"Datenschutz": "DSGVO-Anforderungen entsprechen",
"Rechenressourcen": "Bestehende Serverkonfiguration"
}
def define_features_and_labels(self):
"""Merkmale und Labels definieren"""
features = {
"Benutzermerkmale": ["Alter", "Geschlecht", "Kaufhistorie", "Browsing-Verhalten"],
"Produktmerkmale": ["Kategorie", "Preis", "Bewertung", "Bestand"],
"Kontextmerkmale": ["Zeit", "Gerät", "Geografischer Standort"]
}
labels = {
"Primäres Label": "Ob angeklickt",
"Sekundäres Label": "Ob gekauft",
"Hilfslabel": "Verweildauer"
}
return features, labels
def print_definition(self):
"""Problemdefinition ausgeben"""
print("=" * 50)
print("Machine-Learning-Problemdefinition")
print("=" * 50)
print(f"Business-Problem: {self.business_problem}")
print(f"Technisches Problem: {self.technical_problem}")
print(f"Problemtyp: {self.problem_type}")
print("\nErfolgskriterien: ")
for metric, target in self.success_criteria.items():
print(f" {metric}:{target}")
print("\nEinschränkungen: ")
for constraint, limit in self.constraints.items():
print(f" {constraint}:{limit}")
features, labels = self.define_features_and_labels()
print("\nFeature-Definitionen: ")
for category, items in features.items():
print(f" {category}:{', '.join(items)}")
print("\nLabel-Definitionen: ")
for label_type, label_name in labels.items():
print(f" {label_type}:{label_name}")
# Verwendungsbeispiel
problem = ProblemDefinition()
problem.print_definition()
Ausgabe:
==================================================
机器学习问题定义
==================================================
业务问题:用户购买转化率低,需要提高推荐精准度
技术问题:基于用户行为预测用户可能购买的商品
问题类型:推荐系统(分类+排序)

成功标准:
  点击率提升:15%
  转化率提升:10%
  推荐准确率:80%

约束条件:
  响应时间:< 100ms
  数据隐私:符合 GDPR 要求
  计算资源:现有服务器配置

特征定义:
  用户特征:年龄, 性别, 购买历史, 浏览行为
  商品特征:类别, 价格, 评分, 库存
  上下文特征:时间, 设备, 地理位置

标签定义:
  主要标签:是否点击
  次要标签:是否购买
  辅助标签:停留时间
Phase 2: Datenerfassung
Datenquellen
Daten sind der Treibstoff des maschinellen Lernens; ohne geeignete Daten kann kein noch so guter Algorithmus effektiv arbeiten.
Gängige Datenquellen
- Interne Daten: Unternehmensgeschäftsdaten, Nutzerverhaltensdaten
- Externe Daten: öffentliche Datensätze, Datendienste von Drittanbietern
- Web Scraping: Webdaten, Social-Media-Daten
- Sensordaten: IoT-Geräte, Überwachungssysteme
Beispiel zur Datenerfassung
Beispiel
import pandas as pd
import numpy as np
from datetime import datetime, timedelta
class DataCollector:
def __init__(self):
self.collected_data = {}
def collect_user_data(self, n_users=1000):
"""Benutzerdaten sammeln"""
np.random.seed(42)
user_data = {
'user_id': range(1, n_users + 1),
'age': np.random.randint(18, 65, n_users),
'gender': np.random.choice(['Male', 'Female'], n_users),
'city': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen'], n_users),
'registration_date': [
datetime.now() - timedelta(days=np.random.randint(1, 365))
for _ in range(n_users)
]
}
self.collected_data['users'] = pd.DataFrame(user_data)
print(f"Gesammelte {len(user_data['user_id'])} Benutzerdatensätze")
return self.collected_data['users']
def collect_behavior_data(self, n_behaviors=5000):
"""Benutzerverhaltensdaten sammeln"""
np.random.seed(42)
user_ids = np.random.choice(range(1, 1001), n_behaviors)
product_ids = np.random.choice(range(1, 501), n_behaviors)
behavior_data = {
'behavior_id': range(1, n_behaviors + 1),
'user_id': user_ids,
'product_id': product_ids,
'behavior_type': np.random.choice(
['View', 'Click', 'Add to cart', 'Purchase'], n_behaviors,
p=[0.4, 0.3, 0.2, 0.1]
),
'timestamp': [
datetime.now() - timedelta(minutes=np.random.randint(1, 10080))
for _ in range(n_behaviors)
],
'duration': np.random.exponential(30, n_behaviors) # Verweildauer (seconds)
}
self.collected_data['behaviors'] = pd.DataFrame(behavior_data)
print(f"Gesammelte {len(behavior_data['behavior_id'])} Verhaltensdatensätze")
return self.collected_data['behaviors']
def collect_product_data(self, n_products=500):
"""Produktdaten sammeln"""
np.random.seed(42)
categories = ['Elektronik', 'Kleidung', 'Lebensmittel', 'Haushalt', 'Bücher']
product_data = {
'product_id': range(1, n_products + 1),
'category': np.random.choice(categories, n_products),
'price': np.random.uniform(10, 1000, n_products),
'rating': np.random.uniform(3.0, 5.0, n_products),
'stock': np.random.randint(0, 1000, n_products)
}
self.collected_data['products'] = pd.DataFrame(product_data)
print(f"Gesammelte {len(product_data['product_id'])} Produktdatensätze")
return self.collected_data['products']
def get_data_summary(self):
"""Datenzusammenfassung abrufen"""
print("\nZusammenfassung der Datenerfassung: ")
for name, df in self.collected_data.items():
print(f"\n{name} Datensatz: ")
print(f" Form: {df.shape}")
print(f" Spalten: {list(df.columns)}")
print(f" Fehlende Werte: {df.isnull().sum().sum()}")
print(f" Beispieldaten:")
print(df.head(2))
# Verwendungsbeispiel
collector = DataCollector()
collector.collect_user_data()
collector.collect_behavior_data()
collector.collect_product_data()
collector.get_data_summary()
Phase 3: Datenvorbereitung
Bedeutung der Datenvorbereitung
Die Datenvorbereitung macht 60-80% der Zeit in einem Machine-Learning-Projekt aus, genauso wichtig wie die Vorbereitungsarbeit vor dem Kochen.
Hauptaufgaben der Datenvorbereitung
- Datenbereinigung: Umgang mit fehlenden Werten, Ausreißern, doppelten Werten
- Feature-Engineering: neue Merkmale erstellen, wichtige Merkmale auswählen
- Datentransformation: Standardisierung, Normalisierung, Kodierung
- Datenaufteilung: Trainingsset, Validierungsset, Testset
Beispiel zur Datenvorbereitung
Beispiel
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.model_selection import train_test_split
class DataPreparer:
def __init__(self, data):
self.data = data.copy()
self.processed_data = None
def clean_data(self):
"""Datenbereinigung"""
print("Datenbereinigung wird gestartet...")
# 1. Fehlende Werte behandeln
print(f"Fehlende Werte vor der Verarbeitung: {self.data.isnull().sum().sum()}")
# Numerische Spalten mit Mittelwert füllen
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
for col in numeric_columns:
if self.data[col].isnull().sum() > 0:
self.data[col].fillna(self.data[col].mean(), inplace=True)
# Kategorische Spalten mit Modalwert füllen
categorical_columns = self.data.select_dtypes(include=['object']).columns
for col in categorical_columns:
if self.data[col].isnull().sum() > 0:
mode_val = self.data[col].mode()[0]
self.data[col].fillna(mode_val, inplace=True)
print(f"Fehlende Werte nach der Verarbeitung: {self.data.isnull().sum().sum()}")
# 2. Doppelte Werte behandeln
duplicates_before = self.data.duplicated().sum()
self.data.drop_duplicates(inplace=True)
duplicates_after = self.data.duplicated().sum()
print(f"Duplikate entfernt: {duplicates_before - duplicates_after} Zeilen")
# 3. Ausreißer behandeln (einfache Methode: IQR verwenden)
for col in numeric_columns:
Q1 = self.data[col].quantile(0.25)
Q3 = self.data[col].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = ((self.data[col] < lower_bound) |
(self.data[col] > upper_bound)).sum()
if outliers > 0:
# Ausreißer durch Grenzwerte ersetzen
self.data[col] = self.data[col].clip(lower_bound, upper_bound)
print(f"{outliers} Ausreißer in Spalte {col} verarbeitet")
return self.data
def feature_engineering(self):
"""Feature-Engineering"""
print("\nFeature-Engineering wird gestartet...")
# 1. Neue Features erstellen (Beispiel)
if 'price' in self.data.columns and 'rating' in self.data.columns:
# Ein Preis-Leistungs-Verhältnis-Feature erstellen
self.data['price_per_rating'] = self.data['price'] / self.data['rating']
print("Neues Feature erstellt: price_per_rating")
# 2. Feature-Auswahl (einfaches Beispiel: Features mit geringer Varianz entfernen)
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
low_variance_features = []
for col in numeric_columns:
if self.data[col].var() < 0.01: # Varianzschwelle
low_variance_features.append(col)
if low_variance_features:
self.data.drop(columns=low_variance_features, inplace=True)
print(f"Entferne Merkmale mit geringer Varianz: {low_variance_features}")
return self.data
def transform_data(self):
"""Datenumwandlung"""
print("\n"Starte Datenumwandlung...")
# 1. Kategorische Variablen kodieren
categorical_columns = self.data.select_dtypes(include=['object']).columns
label_encoders = {}
for col in categorical_columns:
le = LabelEncoder()
self.data[col] = le.fit_transform(self.data[col])
label_encoders[col] = le
print(f"Kategorische Variable wird kodiert: {col}")
# 2. Numerische Variablen standardisieren
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
scaler = StandardScaler()
if len(numeric_columns) > 0:
self.data[numeric_columns] = scaler.fit_transform(self.data[numeric_columns])
print(f"Numerische Variablen werden standardisiert: {list(numeric_columns)}")
return self.data, label_encoders, scaler
def split_data(self, target_column, test_size=0.2, val_size=0.2):
"""Datenaufteilung"""
print(f"\n"Starte Datenaufteilung (Testset-Anteil: {test_size}, Validierungsset-Anteil: {val_size})...")
X = self.data.drop(columns=[target_column])
y = self.data[target_column]
# Zuerst das Testset abtrennen
X_temp, X_test, y_temp, y_test = train_test_split(
X, y, test_size=test_size, random_state=42
)
# Dann das Validierungsset aus den verbleibenden Daten abtrennen
val_size_adjusted = val_size / (1 - test_size)
X_train, X_val, y_train, y_val = train_test_split(
X_temp, y_temp, test_size=val_size_adjusted, random_state=42
)
print(f"Größe des Trainingssets: {X_train.shape)
print(f"Größe des Validierungssets: {X_val.shape)
print(f"Größe des Testsets: {X_test.shape)
return {
'X_train': X_train, 'y_train': y_train,
'X_val': X_val, 'y_val': y_val,
'X_test': X_test, 'y_test': y_test
}
def prepare_pipeline(self, target_column):
"""Vollständige Datenaufbereitungs-Pipeline"""
print("=" * 50)
print("Datenaufbereitungs-Pipeline")
print("=" * 50)
# 1. Datenbereinigung
self.clean_data()
# 2. Feature-Engineering
self.feature_engineering()
# 3. Datentransformation
processed_data, encoders, scaler = self.transform_data()
# 4. Datenaufteilung
splits = self.split_data(target_column)
self.processed_data = processed_data
return splits, encoders, scaler
# Beispieldaten erstellen und Datenvorbereitung demonstrieren
np.random.seed(42)
sample_data = pd.DataFrame({
'age': np.random.randint(18, 65, 1000),
'income': np.random.normal(50000, 15000, 1000),
'gender': np.random.choice(['Male', 'Female'], 1000),
'city': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou'], 1000),
'target': np.random.choice([0, 1], 1000)
})
# Einige fehlende Werte und Ausreißer hinzufügen
sample_data.loc[np.random.choice(1000, 50), 'income'] = np.nan
sample_data.loc[np.random.choice(1000, 20), 'age'] = np.random.randint(100, 150)
preparer = DataPreparer(sample_data)
splits, encoders, scaler = preparer.prepare_pipeline('target')
Phase 4: Modelltraining
Modellauswahlstrategie
Die Wahl des richtigen Modells ist der Schlüssel zum Erfolg, genau wie die Wahl des richtigen Werkzeugs für die Aufgabe.
Überlegungen zur Modellauswahl
- Problemtyp: Klassifikation, Regression, Clustering usw.
- Datenmerkmale: Datengröße, Anzahl der Merkmale, Datentyp
- Leistungsanforderungen: Genauigkeit, Geschwindigkeit, Interpretierbarkeit
- Ressourcenbeschränkungen: Rechenressourcen, Zeitlimits
Modelltrainingsbeispiel
Beispiel
from sklearn.linear_model import LogisticRegression, LinearRegression
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.svm import SVC, SVR
from sklearn.metrics import accuracy_score, mean_squared_error, classification_report
class ModelTrainer:
def __init__(self):
self.models = {}
self.trained_models = {}
def register_model(self, name, model, problem_type):
"""Modell registrieren"""
self.models[name] = {
'model': model,
'problem_type': problem_type
}
print(f"Modell wird registriert: {name} ({problem_type})")
def train_single_model(self, name, X_train, y_train):
"""Ein einzelnes Modell trainieren"""
if name not in self.models:
raise ValueError(f"Modell {name} ist nicht registriert")
model_info = self.models[name]
model = model_info['model']
print(f"\n"Modell wird trainiert: {name}")
model.fit(X_train, y_train)
self.trained_models[name] = model
print(f"Training für Modell {name} abgeschlossen")
return model
def train_all_models(self, X_train, y_train):
"""Alle registrierten Modelle trainieren"""
print("\n"Beginne mit dem Training aller Modelle...")
for name in self.models.keys():
try:
self.train_single_model(name, X_train, y_train)
except Exception as e:
print(f"Fehler beim Trainieren des Modells {name}: {e}")
return self.trained_models
def evaluate_models(self, X_test, y_test):
"""Alle trainierten Modelle evaluieren"""
print("\n"Ergebnisse der Modellevaluierung:")
print("-" * 50)
results = {}
for name, model in self.trained_models.items():
problem_type = self.models[name]['problem_type']
# Vorhersagen
y_pred = model.predict(X_test)
# Auswahl der Evaluierungsmetriken basierend auf dem Problemtyp
if problem_type == 'classification':
accuracy = accuracy_score(y_test, y_pred)
results[name] = {'accuracy': accuracy}
print(f"{name}: Genauigkeit = {accuracy:.4f}")
# Detaillierter Bericht
print(classification_report(y_test, y_pred))
elif problem_type == 'regression':
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
results[name] = {'mse': mse, 'rmse': rmse}
print(f"{name}: MSE = {mse:.4f}, RMSE = {rmse:.4f}")
print("-" * 50)
return results
def get_best_model(self, results, metric='accuracy'):
"""Bestes Modell ermitteln"""
if not results:
return None
best_model_name = max(results.keys(), key=lambda x: results[x].get(metric, 0))
best_score = results[best_model_name][metric]
print(f"\n"Bestes Modell: {best_model_name} ({metric} = {best_score:.4f})")
return best_model_name, self.trained_models[best_model_name]
# Verwendungsbeispiel
trainer = ModelTrainer()
# Verschiedene Arten von Modellen registrieren
trainer.register_model('Logistic Regression', LogisticRegression(random_state=42), 'classification')
trainer.register_model('Random Forest', RandomForestClassifier(n_estimators=100, random_state=42), 'classification')
trainer.register_model('Support Vector Machine', SVC(random_state=42), 'classification')
# Trainingsdaten erstellen
X_train = splits['X_train']
y_train = splits['y_train']
X_test = splits['X_test']
y_test = splits['y_test']
# Alle Modelle trainieren
trained_models = trainer.train_all_models(X_train, y_train)
# Modelle bewerten
results = trainer.evaluate_models(X_test, y_test)
# Das beste Modell abrufen
best_name, best_model = trainer.get_best_model(results)
Phase 5: Modellbewertung
Auswahl der Bewertungsmetrik
Die richtige Bewertungsmetrik zu wählen ist wie den richtigen Maßstab zu wählen, verschiedene Metriken eignen sich für verschiedene Szenarien.
Häufige Bewertungsmetriken
Klassifikationsprobleme:
- Genauigkeit: der Anteil korrekter Vorhersagen
- Präzision: der Anteil der als positiv vorhergesagten Stichproben, die tatsächlich positiv sind
- Trefferquote: der Anteil der tatsächlich positiven Stichproben, die korrekt als positiv vorhergesagt werden
- F1-Score: das harmonische Mittel von Präzision und Trefferquote
Regressionsprobleme:
- Mittlerer quadratischer Fehler (MSE): der Durchschnitt der quadrierten Differenzen zwischen vorhergesagten und wahren Werten
- Wurzel des mittleren quadratischen Fehlers (RMSE): die Quadratwurzel von MSE
- Mittlerer absoluter Fehler (MAE): der Durchschnitt der absoluten Differenzen zwischen vorhergesagten und wahren Werten
- R²-Wert: der Anteil der durch das Modell erklärten Varianz
Beispiel zur Modellbewertung
Beispiel
import matplotlib.pyplot as plt
from sklearn.metrics import (
accuracy_score, precision_score, recall_score, f1_score,
confusion_matrix, roc_curve, auc
)
class ModelEvaluator:
def __init__(self):
self.evaluation_results = {}
def evaluate_classification(self, y_true, y_pred, y_prob=None, model_name="Modell"):
"""Klassifizierungsmodell bewerten"""
results = {}
# Grundlegende Metriken
results['accuracy'] = accuracy_score(y_true, y_pred)
results['precision'] = precision_score(y_true, y_pred, average='weighted')
results['recall'] = recall_score(y_true, y_pred, average='weighted')
results['f1'] = f1_score(y_true, y_pred, average='weighted')
print(f"\n"{model_name} Ergebnisse der Klassifikationsbewertung:")
print(f"Genauigkeit: {results['accuracy']:.4f}")
print(f"Präzision: {results['precision']:.4f}")
print(f"Trefferquote: {results['recall']:.4f}")
print(f"F1-Wert: {results['f1']:.4f}")
# Konfusionsmatrix
cm = confusion_matrix(y_true, y_pred)
print(f"\n"Konfusionsmatrix:")
print(cm)
# ROC-Kurve (falls Wahrscheinlichkeitsvorhersagen verfügbar sind)
if y_prob is not None and len(np.unique(y_true)) == 2:
fpr, tpr, thresholds = roc_curve(y_true, y_prob[:, 1])
roc_auc = auc(fpr, tpr)
results['roc_auc'] = roc_auc
# ROC-Kurve zeichnen
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color='darkorange', lw=2,
label=f'ROC-Kurve (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('Falsch-Positiv-Rate')
plt.ylabel('Richtig-Positiv-Rate')
plt.title(f'{model_name} ROC-Kurve')
plt.legend(loc="unten rechts")
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def evaluate_regression(self, y_true, y_pred, model_name="Modell"):
"""Regressionsmodell bewerten"""
results = {}
# Grundlegende Metriken
mse = np.mean((y_true - y_pred) ** 2)
rmse = np.sqrt(mse)
mae = np.mean(np.abs(y_true - y_pred))
# R²-Wert
ss_res = np.sum((y_true - y_pred) ** 2)
ss_tot = np.sum((y_true - np.mean(y_true)) ** 2)
r2 = 1 - (ss_res / ss_tot)
results['mse'] = mse
results['rmse'] = rmse
results['mae'] = mae
results['r2'] = r2
print(f"\n"{model_name} Ergebnisse der Regressionsbewertung:")
print(f"Mittlerer quadratischer Fehler (MSE): {mse:.4f}")
print(f"Wurzel des mittleren quadratischen Fehlers (RMSE): {rmse:.4f}")
print(f"Mittlerer absoluter Fehler (MAE): {mae:.4f}")
print(f"R²-Wert: {r2:.4f}")
# Vorhergesagte vs. tatsächliche Werte darstellen
plt.figure(figsize=(8, 6))
plt.scatter(y_true, y_pred, alpha=0.6)
plt.plot([y_true.min(), y_true.max()], [y_true.min(), y_true.max()],
'r--', lw=2)
plt.xlabel('Tatsächliche Werte')
plt.ylabel('Vorhergesagte Werte')
plt.title(f'{model_name} Vorhergesagte vs. tatsächliche Werte')
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def compare_models(self):
"""Alle bewerteten Modelle vergleichen"""
if not self.evaluation_results:
print("Keine vergleichbaren Modellbewertungsergebnisse")
return
print("\n"Modellvergleich:")
print("-" * 50)
# Vergleichstabelle erstellen
comparison_data = []
for model_name, results in self.evaluation_results.items():
row = [model_name]
for metric, value in results.items():
row.append(f"{value:.4f}")
comparison_data.append(row)
# Tabelle ausgeben
headers = ["Modellname"] + list(self.evaluation_results.values())[0].keys()
print("\t".join(headers))
for row in comparison_data:
print("\t".join(row))
# Verwendungsbeispiel
evaluator = ModelEvaluator()
# Klassifikationsmodell bewerten
y_pred_class = best_model.predict(X_test)
y_prob_class = best_model.predict_proba(X_test)
evaluator.evaluate_classification(y_test, y_pred_class, y_prob_class, "Bestes Klassifikationsmodell")
# Alle Modelle vergleichen
evaluator.compare_models()
Phase 6: Modellbereitstellung
Bereitstellungsstrategie
Modell-Deployment ist der Prozess, ein Modell in die praktische Nutzung zu bringen, genau wie man ein entwickeltes Produkt auf den Markt bringt.
Bereitstellungsmethoden
- Batch-Vorhersage: regelmäßig große Datenmengen verarbeiten
- Echtzeit-Vorhersage: Online-Dienst, sofortige Antwort
- Eingebettetes Deployment: das Modell in bestehende Systeme integrieren
- Edge-Deployment: das Modell auf Geräten ausführen
Beispiel für Modell-Deployment
Beispiel
import pickle
import json
from datetime import datetime
class ModelDeployer:
def __init__(self):
self.deployed_models = {}
self.deployment_logs = []
def save_model(self, model, model_name, filepath=Keine):
"""Modell speichern"""
if filepath is None:
"".pkl"" = f"{model_name}.pkl"
with open(filepath, 'wb') as f:
pickle.dump(model, f)
print(f"Modell {model_name} gespeichert unter {filepath}")
# Bereitstellungsprotokoll aufzeichnen
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'save_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return filepath
def load_model(self, model_name, filepath):
"""Modell laden"""
with open(filepath, 'rb') as f:
model = pickle.load(f)
self.deployed_models[model_name] = model
print(f"Modell {model_name} geladen von {filepath}")
# Bereitstellungsprotokoll aufzeichnen
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'load_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return model
def create_prediction_service(self, model_name, encoders=None, scaler=None):
"""Vorhersagedienst erstellen"""
if model_name not in self.deployed_models:
raise ValueError(f"Modell {model_name} ist nicht bereitgestellt")
model = self.deployed_models[model_name]
def predict_service(input_data):
"""Vorhersagedienst-Funktion"""
try:
# Datenvorverarbeitung
if encoders:
for col, encoder in encoders.items():
if col in input_data.columns:
input_data[col] = encoder.transform(input_data[col])
if scaler:
numeric_cols = input_data.select_dtypes(include=['number']).columns
input_data[numeric_cols] = scaler.transform(input_data[numeric_cols])
# Vorhersage
prediction = model.predict(input_data)
# Wenn es sich um ein Klassifikationsmodell handelt, auch Wahrscheinlichkeiten zurückgeben
if hasattr(model, 'predict_proba'):
probability = model.predict_proba(input_data)
return {
'prediction': prediction.tolist(),
'probability': probability.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
else:
return {
'prediction': prediction.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
except Exception as e:
return {
'error': str(e),
'status': 'error',
'timestamp': datetime.now().isoformat()
}
# Service-Erstellungsprotokoll aufzeichnen
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'create_service',
'model_name': model_name
}
self.deployment_logs.append(log_entry)
return predict_service
def monitor_model(self, model_name, input_data, true_labels=Keine):
"""Modellleistung überwachen"""
if model_name not in self.deployed_models:
raise ValueError(f"Modell {model_name} ist nicht bereitgestellt")
predict_service = self.create_prediction_service(model_name)
# Vorhersageergebnisse abrufen
result = predict_service(input_data)
# Monitoring-Informationen
monitoring_info = {
'timestamp': datetime.now().isoformat(),
'model_name': model_name,
'input_shape': input_data.shape,
'prediction_count': len(result.get('prediction', [])),
'status': result.get('status', 'unknown')
}
# Wenn wahre Labels verfügbar sind, Leistungsmetriken berechnen
if true_labels is not None and 'prediction' in result:
predictions = result['prediction']
if len(predictions) == len(true_labels):
accuracy = accuracy_score(true_labels, predictions)
monitoring_info['accuracy'] = accuracy
print("Informationen zur Modellüberwachung:")
for key, value in monitoring_info.items():
print(f" {key}: {value}")
return monitoring_info
def get_deployment_logs(self):
"""Deployment-Logs abrufen"""
return self.deployment_logs
# Verwendungsbeispiel
deployer = ModelDeployer()
# Bestes Modell speichern
model_path = deployer.save_model(best_model, "best_classification_model")
# Modell laden
deployer.load_model("best_classification_model", model_path)
# Vorhersagedienst erstellen
prediction_service = deployer.create_prediction_service(
"best_classification_model", encoders, scaler
)
# Vorhersagedienst verwenden
test_input = X_test.head(5)
prediction_result = prediction_service(test_input)
print("\n"Vorhersageergebnisse:")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
# Modell überwachen
deployer.monitor_model("best_classification_model", test_input, y_test.head(5).values)
Vollständiges Workflow-Beispiel
Beispiel
class MLProjectPipeline:
def __init__(self):
self.data_collector = DataCollector()
self.data_preparer = None
self.model_trainer = ModelTrainer()
self.model_evaluator = ModelEvaluator()
self.model_deployer = ModelDeployer()
def run_complete_pipeline(self, target_column):
"""Führe die vollständige Machine-Learning-Pipeline aus"""
print("=" * 60)
print("Vollständiger Workflow für Machine-Learning-Projekte")
print("=" * 60)
# 1. Datenerfassung
print("\nSchritt 1: Datenerfassung")
print("-" * 30)
user_data = self.data_collector.collect_user_data(1000)
behavior_data = self.data_collector.collect_behavior_data(5000)
# Daten zusammenführen (vereinfachtes Beispiel)
merged_data = pd.merge(user_data, behavior_data, on='user_id', how='inner')
# Zielvariable erstellen (Beispiel: ob gekauft wird)
merged_data['purchased'] = (merged_data[behavior_type'] == 'Purchase').astype(int)
# 2. Datenvorbereitung
print("\nSchritt 2: Datenvorbereitung")
print("-" * 30)
# Feature-Spalten auswählen
feature_columns = ['age', 'gender', 'city', 'duration']
if all(col in merged_data.columns for col in feature_columns):
data_for_ml = merged_data[feature_columns + ['purchased']].copy()
# Kategorische Variablen behandeln
data_for_ml['gender'] = data_for_ml['gender'].map({'Male': 0, 'Female': 1})
data_for_ml['city'] = data_for_ml['city'].map({'Peking': 0, 'Shanghai': 1, 'Guangzhou': 2})
# Datenvorbereitung
self.data_preparer = DataPreparer(data_for_ml)
splits, encoders, scaler = self.data_preparer.prepare_pipeline('purchased')
# 3. Modelltraining
print("\nSchritt 3: Modelltraining")
print("-" * 30)
# Modell registrieren
self.model_trainer.register_model(
'Logistische Regression', LogisticRegression(random_state=42), 'classification'
)
self.model_trainer.register_model(
'Random Forest', RandomForestClassifier(n_estimators=100, random_state=42), 'classification'
)
# Modell trainieren
trained_models = self.model_trainer.train_all_models(
splits['X_train'], splits['y_train']
)
# 4. Modellbewertung
print("\nSchritt 4: Modellbewertung")
print("-" * 30)
results = self.model_trainer.evaluate_models(
splits['X_test'], splits['y_test']
)
best_name, best_model = self.model_trainer.get_best_model(results)
# 5. Modellbereitstellung
print("\nSchritt 5: Modellbereitstellung")
print("-" * 30)
# Modell speichern
model_path = self.model_deployer.save_model(best_model, "production_model")
# Vorhersagedienst erstellen
prediction_service = self.model_deployer.create_prediction_service(
"production_model"
)
# Vorhersagedienst testen
test_input = splits['X_test'].head(3)
prediction_result = prediction_service(test_input)
print("\nVorhersagedienst-Testergebnis:")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
print("\n" + "=" * 60)
print("Workflow des Machine-Learning-Projekts abgeschlossen!")
print("=" * 60)
return {
'data': data_for_ml,
'splits': splits,
'best_model': best_model,
'best_model_name': best_name,
'evaluation_results': results,
'prediction_service': prediction_service
}
else:
print("Die Datenspalten sind unvollständig, der Workflow kann nicht fortgesetzt werden")
return None
# Vollständigen Workflow ausführen
pipeline = MLProjectPipeline()
project_results = pipeline.run_complete_pipeline('purchased')