Datenbereinigung
Im maschinellen Lernen hört man oft den Satz: „Müll rein, Müll raus.“ Das veranschaulicht eindrucksvoll den entscheidenden Einfluss der Datenqualität auf die Modellleistung.
Stellen Sie sich vor, Sie sind ein Koch, der ein köstliches Gericht zubereitet. Selbst wenn Ihre Kochkünste außergewöhnlich sind, wenn die Zutaten nicht frisch sind, Schmutz enthalten oder unvollständig sind, wird das endgültige Gericht unweigerlich stark beeinträchtigt.
Beim maschinellen Lernen sindRohdatenunsere „Zutat“, undDatenbereinigungist dieser entscheidende Prozess der „Vorbereitung“. Sie zielt darauf ab, Fehler, Inkonsistenzen, Duplikate und unvollständige Teile in den Daten zu identifizieren, zu korrigieren oder zu entfernen, um saubere, hochwertige „Zutaten“ für das anschließende „Kochen“ des Modells vorzubereiten.
Dieser Artikel führt Sie systematisch in die Kernkonzepte und gängigen Methoden der Datenbereinigung ein und hilft Ihnen durch klare Codebeispiele, diese unverzichtbare Fähigkeit für Datenwissenschaftler zu beherrschen.
1. Warum ist Datenbereinigung so wichtig?
Bevor wir in technische Details eintauchen, wollen wir zunächst verstehen, warum Datenbereinigung ein unverzichtbarer Bestandteil des Workflows für maschinelles Lernen ist.
1.1 Modellleistung und Genauigkeit verbessern
Schmutzige Daten (wie Ausreißer und fehlerhafte Werte) können das Modell dazu verleiten, falsche Muster zu erlernen. Bereinigte Daten ermöglichen es dem Modell, die wahren Muster in den Daten genauer zu erfassen und dadurch zuverlässigere Vorhersagen zu treffen.
1.2 Zuverlässigkeit der Analyseergebnisse sicherstellen
Ob für explorative Datenanalyse oder abschließende Geschäftsentscheidungen: Schlussfolgerungen aus fehlerhaften Daten sind gefährlich. Datenbereinigung sorgt für eine solide und zuverlässige Grundlage für die Analyse.
1.3 Algorithmus-Stabilität verbessern
Viele Algorithmen des maschinellen Lernens reagieren sehr empfindlich auf die Datenqualität. Beispielsweise werden distanzbasierte Algorithmen (wie KNN und SVM) stark von Ausreißern beeinflusst, und fehlende Werte können eine gesamte Stichprobe unbrauchbar machen.
1.4 Rechenressourcen und Zeit sparen
Das Entfernen irrelevanter und doppelter Daten kann die Größe des Datensatzes reduzieren und dadurch die Rechenkosten und die Zeit für das Modelltraining senken.
Um die Position der Datenbereinigung im gesamten Workflow des maschinellen Lernens anschaulicher zu verstehen, siehe das folgende Flussdiagramm:
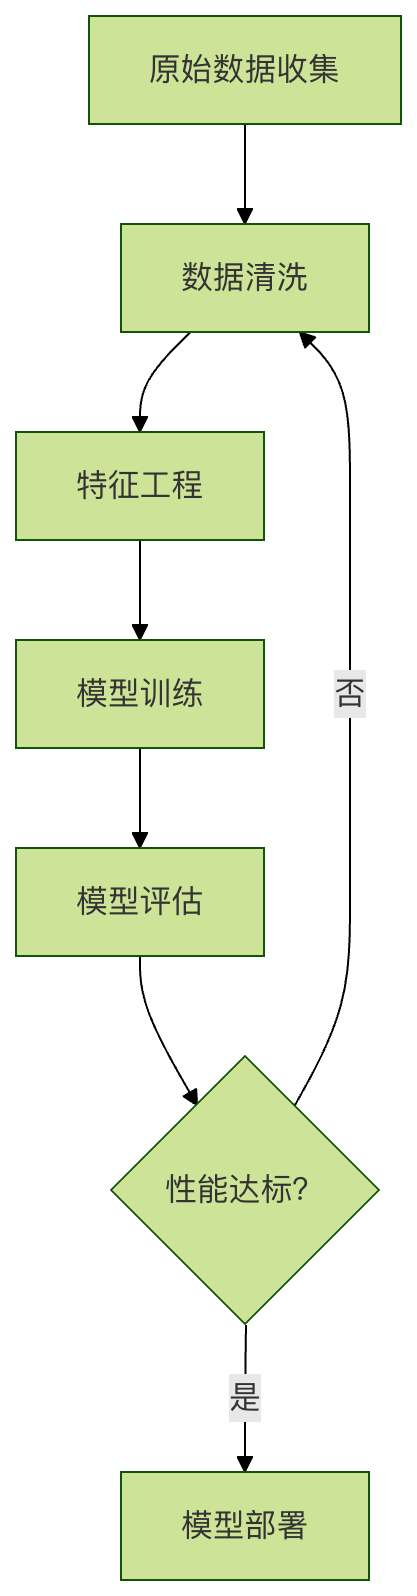
Wie aus der obigen Abbildung ersichtlich ist, ist die Datenbereinigung der erste Schritt der Vorverarbeitung, und bei schlechter Modellleistung müssen wir oft zu diesem Schritt zurückkehren, um die Datenqualität zu prüfen und zu verbessern.
2. Häufige Datenprobleme und Bereinigungsstrategien
Die Datenbereinigung befasst sich typischerweise mit den folgenden häufigen Problemen. Anhand einer einfachen Tabelle können wir sie schnell verstehen:
| Problemtyp | Beschreibung | Mögliche Auswirkung | Gängige Bereinigungsstrategien |
|---|---|---|---|
| Fehlende Werte | Einige Felder in einem Datensatz weisen leere Werte auf (NaN, NULL). | Führt zum Verwerfen von Stichproben, zu Informationsverlust und Berechnungsfehlern. | Löschen, füllen (Mittelwert/Median/Modus/Vorhersage). |
| Ausreißer | Extremwerte, die deutlich vom Großteil der Daten abweichen. | Verzerren statistische Ergebnisse und beeinträchtigen die Modellleistung. | Identifizieren (IQR, Z-Score), dann löschen oder korrigieren. |
| Doppelte Werte | Im Datensatz existieren identische Einträge. | Führt zu einer übermäßigen Verzerrung des Modells hin zu doppelten Stichproben, wodurch die Generalisierungsfähigkeit beeinträchtigt wird. | Duplikate identifizieren und entfernen. |
| Inkonsistenzen | Datenformate, Einheiten oder Kodierungen sind inkonsistent (z. B. "male", "Male", "M"). | Führt zu Gruppierungs- und Analysefehlern. | Standardisieren, normalisieren, zuordnen/konvertieren. |
| Fehlerhafte Werte | Werte, die eindeutig unlogisch sind (z. B. Alter ist -1 oder 300 Jahre alt). | Erzeugt bedeutungslose Analyseergebnisse. | Auf Basis der Geschäftslogik korrigieren oder als fehlend setzen. |
Als Nächstes verwenden wir PythonspandasundnumpyBibliothek, um zu demonstrieren, wie diese Probleme mit konkretem Code gelöst werden.
3. Praxisübung: Datenbereinigung mit Python
Angenommen, wir haben einencustomer_data.csvKundendatensatz, der einige typische Datenqualitätsprobleme enthält.
3.1 Vorbereitung der Umgebung und Laden der Daten
Stellen Sie zunächst sicher, dass Sie die erforderlichen Bibliotheken installiert haben, und laden Sie dann die Daten.
Beispiel
import pandas as pd
import numpy as np
# Datensatz laden
df = pd.read_csv('customer_data.csv') # Ersetzen Sie durch Ihren Dateipfad
# Grundlegende Informationen und die ersten Zeilen der Daten anzeigen
print(Form des Datensatzes (Zeilen, Spalten):, df.shape)
print("\nErste 5 Zeilen der Daten:)
print(df.head())
print("\nGrundlegende Dateninformationen:)
print(df.info())
print("\nStatistische Beschreibung der Daten:)
print(df.describe())
3.2 Umgang mit fehlenden Werten
Das Auffinden fehlender Werte ist der erste Schritt.pandasbietet praktische Methoden.
Beispiel
print(Anzahl fehlender Werte pro Spalte:)
print(df.isnull().sum())
# 2. Fehlende Werte behandeln – Methode 1: Löschen
# Alle Zeilen löschen, die fehlende Werte enthalten (geeignet, wenn nur wenige fehlende Werte vorhanden sind)
df_dropped = df.dropna()
print(f"\nNach dem Entfernen fehlender Werte, Datenform: {df_dropped.shape})
# 3. Fehlende Werte behandeln – Methode 2: Imputation
# Eine gebräuchlichere Methode ist die Imputation basierend auf den Merkmalen der Spalte
df_filled = df.copy()
# Für numerische Spalten (z. B. 'Age') mit dem Median füllen (robuster gegenüber Ausreißern als der Mittelwert)
if 'Age' in df_filled.columns:
df_filled['Age'].fillna(df_filled['Age'].median(), inplace=True)
# Für kategorische Spalten (z. B. 'City'), mit dem Modus füllen (dem am häufigsten vorkommenden Wert)
if 'City' in df_filled.columns:
df_filled['City'].fillna(df_filled['City'].mode()[0], inplace=True)
# Für Spalten, die sich im Laufe der Zeit ändern können (z. B. 'Last Purchase Amount'), ist es manchmal aus geschäftlicher Sicht sinnvoller, mit 0 zu füllen
if 'Last Purchase Amount' in df_filled.columns:
df_filled['Last Purchase Amount'].fillna(0, inplace=True)
print("\nNach der Imputation fehlender Werte, Anzahl fehlender Werte pro Spalte:)
print(df_filled.isnull().sum())
3.3 Identifizierung und Behandlung von Ausreißern
Der Umgang mit Ausreißern erfordert Vorsicht, da sie manchmal wichtige besondere Ereignisse darstellen.
Beispiel
if 'Annual Income' in df_filled.columns:
# Methode 1: Verwende die Interquartilsabstand-Methode (IQR), um zu identifizieren
Q1 = df_filled['Annual Income'].quantile(0.25)
Q3 = df_filled['Annual Income'].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
# Ausreißer finden
outliers = df_filled[(df_filled['Annual Income'] < lower_bound) | (df_filled['Annual Income'] > upper_bound)]
print(f"\nAnzahl der mit der IQR-Methode gefundenen 'Annual Income'-Ausreißer: {len(outliers)})
# Ausreißer behandeln: Hier entscheiden wir uns, sie mithilfe der unteren und oberen Grenzen zu beschneiden (Winsorisierung)
df_filled['Annual Income'] = np.where(df_filled['Annual Income'] > upper_bound, upper_bound,
np.where(df_filled['Annual Income'] < lower_bound, lower_bound, df_filled['Annual Income']))
print(Die Ausreißer in 'Annual Income' wurden gekappt.)
3.4 Umgang mit doppelten Werten
Doppelte Datensätze erhöhen den Rechenaufwand und können zu Verzerrungen führen.
Beispiel
duplicate_rows = df_filled.duplicated()
print(f"\nAnzahl der gefundenen vollständig doppelten Zeilen: {duplicate_rows.sum()})
# Diese doppelten Zeilen entfernen und nur das erste Vorkommen behalten
df_cleaned = df_filled.drop_duplicates()
print(fNach dem Entfernen doppelter Werte, Datenform: {df_cleaned.shape})
3.5 Umgang mit Inkonsistenzen
Stellen Sie die Konsistenz von Datenformaten und Werten sicher.
Beispiel
if 'City' in df_cleaned.columns:
df_cleaned['City'] = df_cleaned['City'].str.title()
# 2. Vereinheitlichte Werte zuordnen: zum Beispiel Geschlechtsinformationen zu 'Male' und 'Female' vereinheitlichen
if 'Gender' in df_cleaned.columns:
gender_mapping = {'male': 'Male', 'female': 'Female', 'M': 'Male', 'F': 'Female'}
df_cleaned['Gender'] = df_cleaned['Gender'].replace(gender_mapping)
# Sie können auch die .map()-Funktion verwenden, aber .replace() ist flexibler, da nicht angegebene Werte unverändert bleiben
# 3. Datentypen konvertieren: Sicherstellen, dass numerische Spalten den numerischen Typ haben
if 'Age' in df_cleaned.columns:
df_cleaned['Age'] = pd.to_numeric(df_cleaned['Age'], errors='coerce') # errors='coerce' wandelt Fehler in NaN um
# Nach der Konvertierung können Sie erneut den Median verwenden, um die durch die Konvertierung erzeugten neuen NaN zu füllen
df_cleaned['Age'].fillna(df_cleaned['Age'].median(), inplace=True)
print("\nDatenbereinigung abgeschlossen! Sehen Sie sich die ersten 5 Zeilen der bereinigten Daten an: ")
print(df_cleaned.head())
4. Zusammenfassung und Best Practices
Durch die oben genannten Schritte haben wir eine Runde grundlegender Datenbereinigung abgeschlossen. Denken Sie daran: Datenbereinigung ist kein einmaliger Schritt, sondern ein iterativer Prozess. Hier sind einige Best Practices:
- Explore first, then clean: Bevor Sie mit der Bereinigung beginnen, sollten Sie unbedingt verwenden
df.describe()、df.info(), Visualisierung (wie Histogramme, Boxplots) und andere Methoden, um Ihre Daten vollständig zu verstehen. - Originaldaten sichern: Bewahren Sie immer eine Kopie der ursprünglichen, unveränderten Daten auf. Alle Bereinigungsvorgänge sollten an der Kopie durchgeführt werden.
- Bereinigungsschritte dokumentieren: Dokumentieren Sie Ihre Bereinigungslogik (z. B. warum Median-Imputation verwendet wird, wie Ausreißergrenzen bestimmt werden). Dies ist entscheidend für die Reproduzierbarkeit von Projekten und die Zusammenarbeit im Team.
- Mit Geschäftslogik kombinieren: Datenbereinigung ist keine rein mathematische Operation. Zum Beispiel ist "age=0" in demografischen Daten ein Fehler, kann aber bei Daten zu Säuglingsprodukten plausibel sein. Halten Sie stets die Kommunikation mit Fachexperten aufrecht.
- Iterativ vorgehen: Nach der Bereinigung treten Sie in die Modellierungsphase ein. Wenn das Modell schlecht abschneidet, gehen Sie zurück und prüfen Sie die Datenqualität; möglicherweise müssen Sie die Bereinigungsstrategie anpassen.
Datenbereinigung kann einen erheblichen Teil der60%-80%Zeit eines Data-Science-Projekts ausmachen. Obwohl mühsam, ist sie der Grundstein für den Aufbau leistungsstarker, zuverlässiger Machine-Learning-Modelle.
Andere Erweiterungen