FFT (Fast Fourier Transform), Transformada Rápida de Fourier, es un algoritmo eficiente de la DFT (Transformada Discreta de Fourier). Tiene un papel insustituible en los métodos de procesamiento digital basados en el análisis de transformaciones tiempo-frecuencia.
Principio de FFT
Derivación de la fórmula
La fórmula de cálculo de la DFT es:
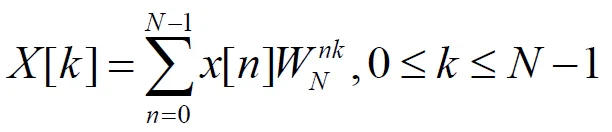
donde,
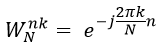
Al dividir la fórmula de la transformada discreta de Fourier en términos pares e impares, los primeros N/2 puntos se pueden expresar como:
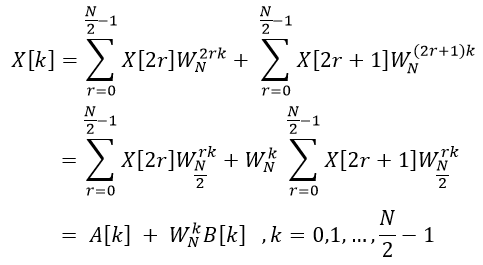
De manera similar, los últimos N/2 puntos se pueden expresar como:
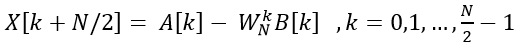
Por lo tanto, los valores de los últimos N/2 puntos pueden determinarse completamente a través de los valores intermedios calculados para los primeros N/2 puntos. Se continúa descomponiendo A[k] y B[k] en partes pares e impares hasta convertirlos en una DFT de 2 puntos, evitando así muchos cálculos repetidos y logrando el proceso de la Transformada Rápida de Fourier (FFT).
Estructura del algoritmo
El diagrama de estructura del cálculo de FFT de 8 puntos es el siguiente.
Como se ve en la figura, solo se necesitan unas pocas multiplicaciones y sumas simples para completar el proceso de DFT, en lugar de realizar tediosas multiplicaciones y acumulaciones para cada dato.

Características importantes
(1) Concepto de etapa
Cada división se denomina una etapa de operación.
Supongamos que el número de puntos de la operación FFT es N, y hay M etapas de operación, entonces cumplen:
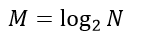
Cada etapa de operación se identifica como m = 0, 1, 2, ..., M-1.
Para facilitar el cálculo por divisiones, el valor de N en FFT suele ser una potencia entera de 2.
(2) Unidad de mariposa
La estructura de cálculo FFT está compuesta por varias unidades de operación de mariposa. El diagrama de cada unidad de operación es el siguiente:
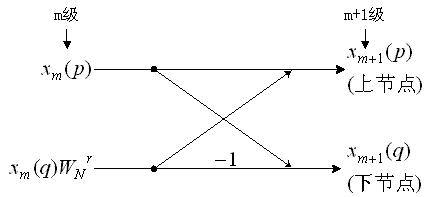
La entrada y salida de la unidad de mariposa satisfacen:
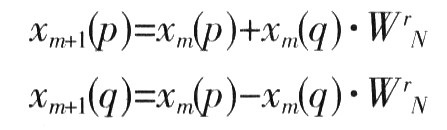
donde,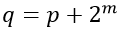
Cada unidad de mariposa realiza una multiplicación y dos sumas en su operación.
En cada etapa, hay N/2 unidades de mariposa.
Por lo tanto, el número de multiplicaciones y sumas necesarias para completar una FFT son respectivamente:
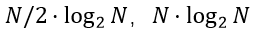
(3) Concepto de grupo
Las N/2 unidades de mariposa de cada etapa se pueden dividir en varios grupos, cada grupo tiene la misma estructura y distribución de factores.
Por ejemplo, cuando m=0, se puede dividir en N/2=4 grupos.
Cuando m=1, se puede dividir en N/4=2 grupos.
Cuando m=M-1, solo se puede dividir en 1 grupo.
(4) Distribución de factores El factor existe en la etapa m, donde
 。
En la segunda etapa de la FFT de 8 puntos, es decir, m=1, los factores de operación de mariposa se pueden simplificar como:
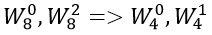
(5) Inversión de bits
Para el cálculo de FFT de N=8 puntos, los códigos binarios correspondientes a las posiciones X(0) ~ X(7) son:
X(000), X(001), X(010), X(011), X(100), X(101), X(110), X(111)
Invierta los códigos binarios de sus posiciones:
X(000), X(100), X(010), X(110), X(001), X(101), X(011), X(111)
El decimal correspondiente a las posiciones en este momento es:
X(0), X(4), X(2), X(6), X(1), X(5), X(3), X(7)
Corresponde exactamente al orden de los datos de entrada de la primera etapa de la FFT.
Esta característica es útil para la implementación de la FFT en programación.
Diseño de FFT
Descripción del diseño
Para explicar el proceso de transformación de la FFT mediante simulación de manera sencilla, se toma un valor pequeño de 8 puntos de datos.
Si los datos se ingresan en serie, primero se requiere almacenarlos en búfer, por lo que en el diseño el método de entrada de datos es paralelo.
La entrada de datos se divide en parte real e imaginaria, 2 partes en total, por lo que el resultado del cálculo también se divide en parte real e imaginaria.
El diseño adopta una estructura de pipeline y por el momento no se considera el consumo de recursos.
Para simplificar la estructura del diseño, aquí se hace una concesión: la multiplicación se realiza directamente con el signo de multiplicar. Si el diseño FFT se aplica en la práctica, es necesario reemplazar la estructura de multiplicación por un multiplicador con pipeline, o utilizar un IP de multiplicador de alta eficiencia proporcionado oficialmente.
Diseño de la unidad de mariposa
La unidad de mariposa es de operación de punto fijo, por lo que es necesario cuantificar en punto fijo el factor twiddle.
Con la ayuda de MATLAB, el factor twiddle se amplía 8192 veces (desplazamiento a la izquierda de 13 bits); consulte el apéndice.
Para evitar que la multiplicación y la suma en la operación de mariposa aumenten el ancho de bits etapa por etapa, después de completar cada etapa, los datos de salida deben truncarse a un ancho de bits fijo; esto también puede eliminar el efecto del aumento del factor twiddle. El código es el siguiente:
Ejemplo
/**************** butter unit *************************
Xm(p) ------------------------> Xm+1(p)
- ->
- -
-
- -
- ->
Xm(q) ------------------------> Xm+1(q)
Wn -1
*//////////////////////////////////////////////////////
module butterfly
(
input clk,
input rstn,
input en,
input signed [23:0] xp_real, // Xm(p)
input signed [23:0] xp_imag,
input signed [23:0] xq_real, // Xm(q)
input signed [23:0] xq_imag,
input signed [15:0] factor_real, // Wnr
input signed [15:0] factor_imag,
output valid,
output signed [23:0] yp_real, //Xm+1(p)
output signed [23:0] yp_imag,
output signed [23:0] yq_real, //Xm+1(q)
output signed [23:0] yq_imag);
reg [4:0] en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 'b0 ;
end
else begin
en_r <= {en_r[3:0], en} ;
end
end
//=====================================================//
//(1.0) Xm(q) mutiply and Xm(p) delay
reg signed [39:0] xq_wnr_real0;
reg signed [39:0] xq_wnr_real1;
reg signed [39:0] xq_wnr_imag0;
reg signed [39:0] xq_wnr_imag1;
reg signed [39:0] xp_real_d;
reg signed [39:0] xp_imag_d;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d <= 'b0;
xp_imag_d <= 'b0;
xq_wnr_real0 <= 'b0;
xq_wnr_real1 <= 'b0;
xq_wnr_imag0 <= 'b0;
xq_wnr_imag1 <= 'b0;
end
else if (en) begin
xq_wnr_real0 <= xq_real * factor_real;
xq_wnr_real1 <= xq_imag * factor_imag;
xq_wnr_imag0 <= xq_real * factor_imag;
xq_wnr_imag1 <= xq_imag * factor_real;
//expanding 8192 times as Wnr
xp_real_d <= {{4{xp_real[23]}}, xp_real[22:0], 13'b0};
xp_imag_d <= {{4{xp_imag[23]}}, xp_imag[22:0], 13'b0};
end
end
//(1.1) get Xm(q) mutiplied-results and Xm(p) delay again
reg signed [39:0] xp_real_d1;
reg signed [39:0] xp_imag_d1;
reg signed [39:0] xq_wnr_real;
reg signed [39:0] xq_wnr_imag;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d1 <= 'b0;
xp_imag_d1 <= 'b0;
xq_wnr_real <= 'b0 ;
xq_wnr_imag <= 'b0 ;
end
else if (en_r[0]) begin
xp_real_d1 <= xp_real_d;
xp_imag_d1 <= xp_imag_d;
//Establezca el margen de ancho de bits con antelación para evitar el desbordamiento de datos
xq_wnr_real <= xq_wnr_real0 - xq_wnr_real1 ;
xq_wnr_imag <= xq_wnr_imag0 + xq_wnr_imag1 ;
end
end
//======================================================//
//(2.0) butter results
reg signed [39:0] yp_real_r;
reg signed [39:0] yp_imag_r;
reg signed [39:0] yq_real_r;
reg signed [39:0] yq_imag_r;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
yp_real_r <= 'b0;
yp_imag_r <= 'b0;
yq_real_r <= 'b0;
yq_imag_r <= 'b0;
end
else if (en_r[1]) begin
yp_real_r <= xp_real_d1 + xq_wnr_real;
yp_imag_r <= xp_imag_d1 + xq_wnr_imag;
yq_real_r <= xp_real_d1 - xq_wnr_real;
yq_imag_r <= xp_imag_d1 - xq_wnr_imag;
end
end
//(3) discard the low 13bits because of Wnr
assign yp_real = {yp_real_r[39], yp_real_r[13+23:13]};
assign yp_imag = {yp_imag_r[39], yp_imag_r[13+23:13]};
assign yq_real = {yq_real_r[39], yq_real_r[13+23:13]};
assign yq_imag = {yq_imag_r[39], yq_imag_r[13+23:13]};
assign valid = en_r[2];
endmodule
Instanciación de nivel superior
De acuerdo con el diagrama de estructura del algoritmo FFT, instancie las unidades de mariposa para completar la función FFT final.
Se pueden instanciar manualmente 12 veces en orden según la correspondencia de entrada y salida de las unidades de mariposa de cada etapa, o utilizar `generate` para la instanciación; en este caso, es necesario conocer muy bien las características de "grupo" y "etapa" en FFT:
-
(1) El diseño de FFT de 8 puntos requiere 3 etapas de operación, cada etapa tiene 4 unidades de mariposa, y el número de grupos en cada etapa es 4, 2, 1 respectivamente.
-
(2) En cada etapa, la distancia entre los dos puertos de entrada de una unidad de mariposa dentro de un grupo es siempre
 (m es el índice de la etapa, correspondiente al desplazamiento a la izquierda 1<<m), y la distancia entre los primeros puertos de entrada de dos unidades de mariposa dentro del grupo es 1.
-
(3) La distancia entre los primeros puertos de entrada de la primera unidad de mariposa de grupos adyacentes en cada etapa es
 (correspondiente al desplazamiento a la izquierda 2<<m).
El código de instanciación es el siguiente.
Entre ellos, las direcciones unidimensional y bidimensional de la señal de matriz xm_real (xm_imag) representan los identificadores de etapa y grupo.
Al determinar la relación de conexión entre los puertos de señal, se utiliza una lógica de decisión aparentemente compleja, e incluso incluye un signo de multiplicación; en realidad, el circuito finalmente generado es exactamente el mismo que el de instanciar manualmente 12 unidades de mariposa en el código. Esto se debe a que las variables en `generate` solo ayudan a generar el circuito real; el cálculo y la determinación de los valores relevantes ya se completan en tiempo de compilación. Estas variables no generan circuitos reales, solo proporcionan un método para una instanciación de módulos más rápida.
Ejemplo
module fft8 (
input clk,
input rstn,
input en,
input signed [23:0] x0_real,
input signed [23:0] x0_imag,
input signed [23:0] x1_real,
input signed [23:0] x1_imag,
input signed [23:0] x2_real,
input signed [23:0] x2_imag,
input signed [23:0] x3_real,
input signed [23:0] x3_imag,
input signed [23:0] x4_real,
input signed [23:0] x4_imag,
input signed [23:0] x5_real,
input signed [23:0] x5_imag,
input signed [23:0] x6_real,
input signed [23:0] x6_imag,
input signed [23:0] x7_real,
input signed [23:0] x7_imag,
output valid,
output signed [23:0] y0_real,
output signed [23:0] y0_imag,
output signed [23:0] y1_real,
output signed [23:0] y1_imag,
output signed [23:0] y2_real,
output signed [23:0] y2_imag,
output signed [23:0] y3_real,
output signed [23:0] y3_imag,
output signed [23:0] y4_real,
output signed [23:0] y4_imag,
output signed [23:0] y5_real,
output signed [23:0] y5_imag,
output signed [23:0] y6_real,
output signed [23:0] y6_imag,
output signed [23:0] y7_real,
output signed [23:0] y7_imag
);
//operating data
wire signed [23:0] xm_real [3:0] [7:0];
wire signed [23:0] xm_imag [3:0] [7:0];
wire en_connect [15:0] ;
assign en_connect[0] = en;
assign en_connect[1] = en;
assign en_connect[2] = en;
assign en_connect[3] = en;
//factor, multiplied by 0x2000
wire signed [15:0] factor_real [3:0] ;
wire signed [15:0] factor_imag [3:0];
assign factor_real[0] = 16'h2000; //1
assign factor_imag[0] = 16'h0000; //0
assign factor_real[1] = 16'h16a0; //sqrt(2)/2
assign factor_imag[1] = 16'he95f; //-sqrt(2)/2
assign factor_real[2] = 16'h0000; //0
assign factor_imag[2] = 16'he000; //-1
assign factor_real[3] = 16'he95f; //-sqrt(2)/2
assign factor_imag[3] = 16'he95f; //-sqrt(2)/2
//Inicialización de entrada, relacionada con la inversión de bits
assign xm_real[0][0] = x0_real;
assign xm_real[0][1] = x4_real;
assign xm_real[0][2] = x2_real;
assign xm_real[0][3] = x6_real;
assign xm_real[0][4] = x1_real;
assign xm_real[0][5] = x5_real;
assign xm_real[0][6] = x3_real;
assign xm_real[0][7] = x7_real;
assign xm_imag[0][0] = x0_imag;
assign xm_imag[0][1] = x4_imag;
assign xm_imag[0][2] = x2_imag;
assign xm_imag[0][3] = x6_imag;
assign xm_imag[0][4] = x1_imag;
assign xm_imag[0][5] = x5_imag;
assign xm_imag[0][6] = x3_imag;
assign xm_imag[0][7] = x7_imag;
//butter instantiaiton
//integer index[11:0] ;
genvar m, k;
generate
//3 stage
for(m=0; m<=2; m=m+1) begin: stage
for (k=0; k<=3; k=k+1) begin: unit
butterfly u_butter(
.clk (clk ) ,
.rstn (rstn ) ,
.en (en_connect[m*4 + k] ) ,
//¿Está dentro del grupo? Número de grupo + número dentro del grupo : número del siguiente grupo + nuevo número dentro del grupo
.xp_real (xm_real[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xp_imag (xm_imag[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xq_real (xm_real[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]), //Aumentar la distancia entre los dos puertos de entrada de la unidad de mariposa
.xq_imag (xm_imag[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.factor_real(factor_real[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
.factor_imag(factor_imag[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
//output data
.valid (en_connect[ (m+1)*4 + k ] ),
.yp_real (xm_real[ m+1 ][k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yp_imag (xm_imag[ m+1 ][(k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yq_real (xm_real[ m+1 ][(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.yq_imag (xm_imag[ m+1 ][((k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ])
);
end
end
endgenerate
assign valid = en_connect[12];
assign y0_real = xm_real[3][0] ;
assign y0_imag = xm_imag[3][0] ;
assign y1_real = xm_real[3][1] ;
assign y1_imag = xm_imag[3][1] ;
assign y2_real = xm_real[3][2] ;
assign y2_imag = xm_imag[3][2] ;
assign y3_real = xm_real[3][3] ;
assign y3_imag = xm_imag[3][3] ;
assign y4_real = xm_real[3][4] ;
assign y4_imag = xm_imag[3][4] ;
assign y5_real = xm_real[3][5] ;
assign y5_imag = xm_imag[3][5] ;
assign y6_real = xm_real[3][6] ;
assign y6_imag = xm_imag[3][6] ;
assign y7_real = xm_real[3][7] ;
assign y7_imag = xm_imag[3][7] ;
endmodule
testbench
El testbench se escribe de la siguiente manera; se utiliza principalmente para la entrada continua de 16 canales de datos reales y complejos. Debido a que cada FFT solo tiene 8 puntos de datos, los datos enviados son bastante arbitrarios, no son datos regulares como ondas sinusoidales.
Ejemplo
module test ;
reg clk;
reg rstn;
reg en ;
reg signed [23:0] x0_real;
reg signed [23:0] x0_imag;
reg signed [23:0] x1_real;
reg signed [23:0] x1_imag;
reg signed [23:0] x2_real;
reg signed [23:0] x2_imag;
reg signed [23:0] x3_real;
reg signed [23:0] x3_imag;
reg signed [23:0] x4_real;
reg signed [23:0] x4_imag;
reg signed [23:0] x5_real;
reg signed [23:0] x5_imag;
reg signed [23:0] x6_real;
reg signed [23:0] x6_imag;
reg signed [23:0] x7_real;
reg signed [23:0] x7_imag;
wire valid;
wire signed [23:0] y0_real;
wire signed [23:0] y0_imag;
wire signed [23:0] y1_real;
wire signed [23:0] y1_imag;
wire signed [23:0] y2_real;
wire signed [23:0] y2_imag;
wire signed [23:0] y3_real;
wire signed [23:0] y3_imag;
wire signed [23:0] y4_real;
wire signed [23:0] y4_imag;
wire signed [23:0] y5_real;
wire signed [23:0] y5_imag;
wire signed [23:0] y6_real;
wire signed [23:0] y6_imag;
wire signed [23:0] y7_real;
wire signed [23:0] y7_imag;
initial begin
clk = 0; //50MHz
rstn = 0 ;
#10 rstn = 1;
forever begin
#10 clk = ~clk; //50MHz
end
end
fft8 u_fft (
.clk (clk ),
.rstn (rstn ),
.en (en ),
.x0_real (x0_real),
.x0_imag (x0_imag),
.x1_real (x1_real),
.x1_imag (x1_imag),
.x2_real (x2_real),
.x2_imag (x2_imag),
.x3_real (x3_real),
.x3_imag (x3_imag),
.x4_real (x4_real),
.x4_imag (x4_imag),
.x5_real (x5_real),
.x5_imag (x5_imag),
.x6_real (x6_real),
.x6_imag (x6_imag),
.x7_real (x7_real),
.x7_imag (x7_imag),
.valid (valid),
.y0_real (y0_real),
.y0_imag (y0_imag),
.y1_real (y1_real),
.y1_imag (y1_imag),
.y2_real (y2_real),
.y2_imag (y2_imag),
.y3_real (y3_real),
.y3_imag (y3_imag),
.y4_real (y4_real),
.y4_imag (y4_imag),
.y5_real (y5_real),
.y5_imag (y5_imag),
.y6_real (y6_real),
.y6_imag (y6_imag),
.y7_real (y7_real),
.y7_imag (y7_imag));
//data input
initial begin
en = 0 ;
x0_real = 24'd10;
x1_real = 24'd20;
x2_real = 24'd30;
x3_real = 24'd40;
x4_real = 24'd10;
x5_real = 24'd20;
x6_real = 24'd30;
x7_real = 24'd40;
x0_imag = 24'd0;
x1_imag = 24'd0;
x2_imag = 24'd0;
x3_imag = 24'd0;
x4_imag = 24'd0;
x5_imag = 24'd0;
x6_imag = 24'd0;
x7_imag = 24'd0;
@(negedge clk) ;
en = 1 ;
forever begin
@(negedge clk) ;
x0_real = (x0_real > 22'h3F_ffff) ? 'b0 : x0_real + 1 ;
x1_real = (x1_real > 22'h3F_ffff) ? 'b0 : x1_real + 1 ;
x2_real = (x2_real > 22'h3F_ffff) ? 'b0 : x2_real + 31 ;
x3_real = (x3_real > 22'h3F_ffff) ? 'b0 : x3_real + 1 ;
x4_real = (x4_real > 22'h3F_ffff) ? 'b0 : x4_real + 23 ;
x5_real = (x5_real > 22'h3F_ffff) ? 'b0 : x5_real + 1 ;
x6_real = (x6_real > 22'h3F_ffff) ? 'b0 : x6_real + 6 ;
x7_real = (x7_real > 22'h3F_ffff) ? 'b0 : x7_real + 1 ;
x0_imag = (x0_imag > 22'h3F_ffff) ? 'b0 : x0_imag + 2 ;
x1_imag = (x1_imag > 22'h3F_ffff) ? 'b0 : x1_imag + 5 ;
x2_imag = (x2_imag > 22'h3F_ffff) ? 'b0 : x2_imag + 3 ;
x3_imag = (x3_imag > 22'h3F_ffff) ? 'b0 : x3_imag + 6 ;
x4_imag = (x4_imag > 22'h3F_ffff) ? 'b0 : x4_imag + 4 ;
x5_imag = (x5_imag > 22'h3F_ffff) ? 'b0 : x5_imag + 8 ;
x6_imag = (x6_imag > 22'h3F_ffff) ? 'b0 : x6_imag + 11 ;
x7_imag = (x7_imag > 22'h3F_ffff) ? 'b0 : x7_imag + 7 ;
end
end
//finish simulation
initial #1000 $finish ;
endmodule
Resultados de la simulación
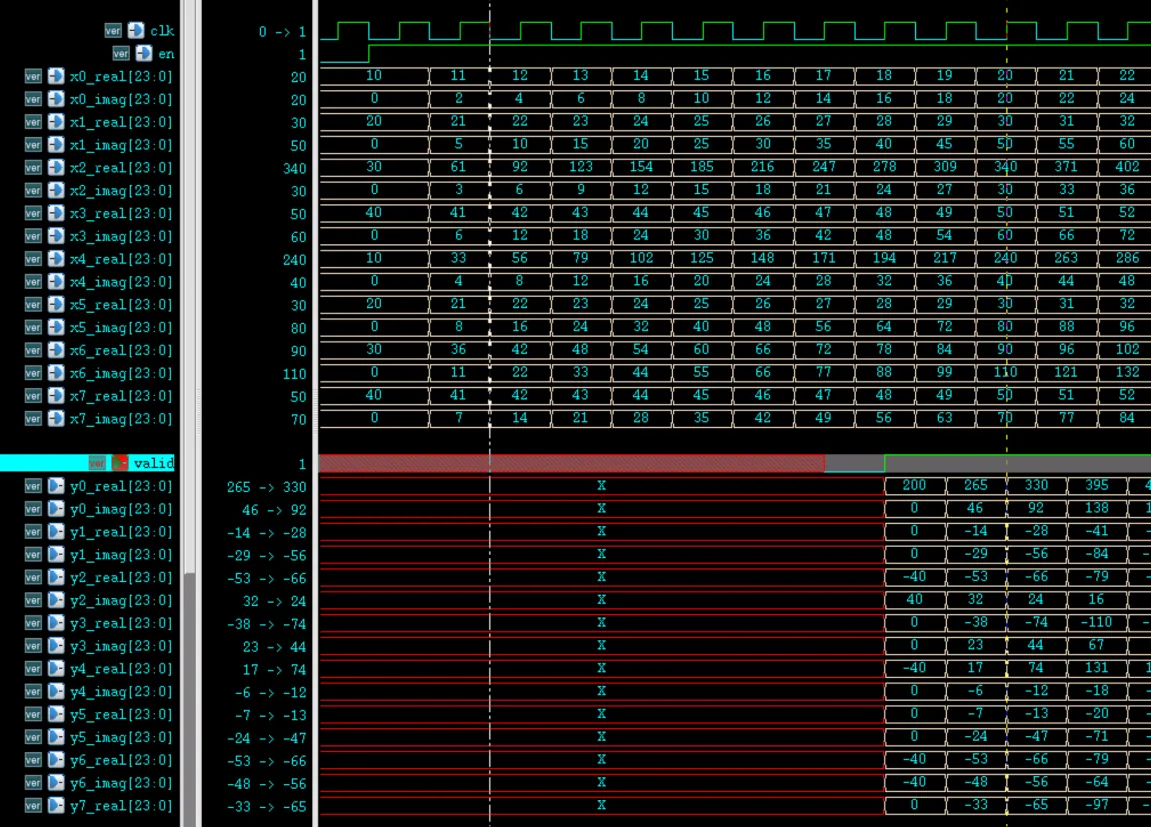
Se puede observar aproximadamente que los resultados de la FFT se pueden generar en pipeline.
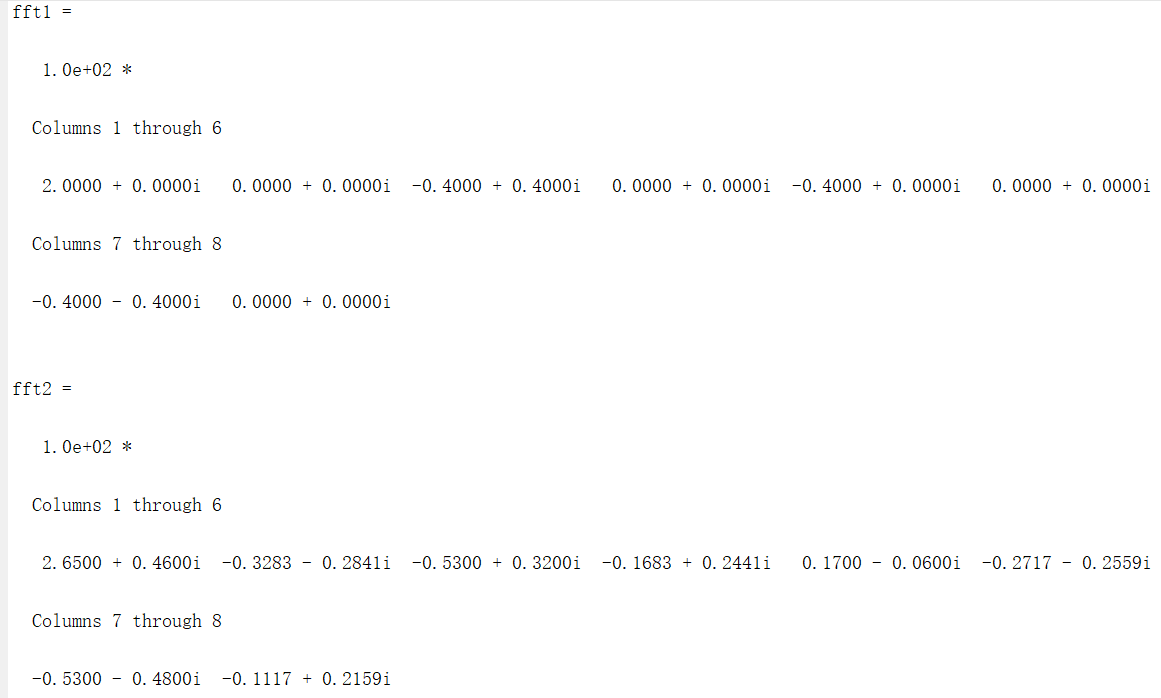
Se utiliza la función FFT incorporada en MATLAB para operar sobre los mismos datos; los resultados FFT de los primeros 2 grupos de datos son los siguientes.
Se puede ver que cuando la primera señal de datos de entrada solo tiene válida la parte real, los resultados de la FFT son exactamente iguales.
Pero en la segunda entrada, la parte compleja de los datos también tiene señal; en este momento, los resultados entre ambos comienzan a tener errores, a veces bastante grandes.
Al simular en MATLAB el proceso FFT implementado en Verilog, se descubre que el resultado FFT de este proceso es básicamente consistente con el resultado de la FFT implementada en Verilog.
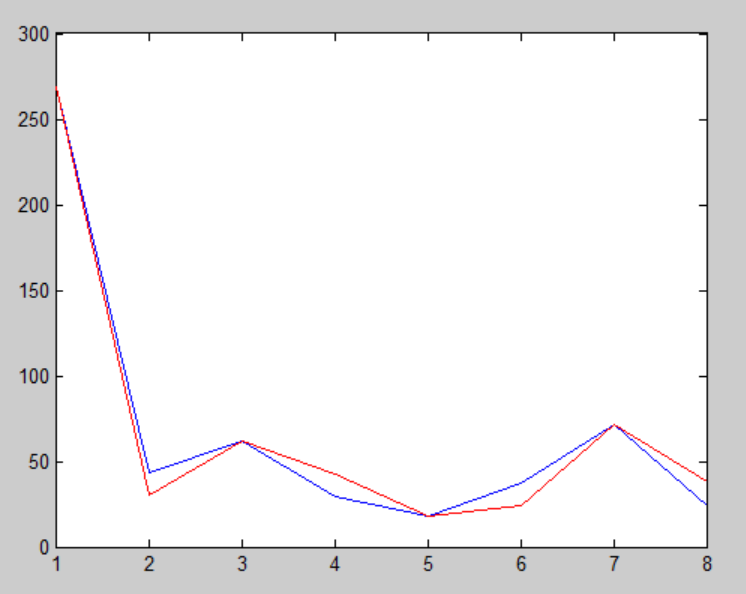
Se comparan los valores absolutos de los dos resultados FFT con errores, como se muestra en la figura.
Se puede ver que la tendencia de los resultados FFT es aproximadamente la misma, pero en algunos puntos hay errores visibles a simple vista.
Resumen del diseño:
Como se mencionó al diseñar la unidad de mariposa, al cuantificar el factor twiddle, la elección del ancho de bits introduce errores.
Además, el resultado de cada unidad de mariposa se trunca, lo que también introduce errores.
MATLAB no necesita considerar el problema de precisión al calcular la FFT; realiza el cálculo FFT de los datos con su máxima precisión.
Todo lo anterior conduce a diferencias en los resultados entre los dos métodos de cálculo FFT.
Los interesados pueden aumentar el factor twiddle y el ancho de bits de los datos de entrada, y también pueden aumentar el número de puntos FFT; luego, al comparar mediante simulación, el error relativo debería disminuir.
Apéndice: uso de MATLAB
Generación del factor twiddle
La FFT de 8 puntos solo necesita 4 factores twiddle. El factor twiddle se amplifica 8192 veces.
Ejemplo
%=======================================================
% Wnr calcuting
%=======================================================
for r = 0:3
Wnr_factor = cos(pi/4*r) - j*sin(pi/4*r) ;
Wnr_integer = floor(Wnr_factor * 2^13) ;
if (real(Wnr_integer)<0)
Wnr_real = real(Wnr_integer) + 2^16 ; %Complemento a dos de números negativos
else
Wnr_real = real(Wnr_integer) ;
end
if (imag(Wnr_integer)<0)
Wnr_imag = imag(Wnr_integer) + 2^16 ;
else
Wnr_imag = imag(Wnr_integer);
end
Wnr(2*r+1,:) = dec2hex(Wnr_real) %Parte real
Wnr(2*r+2,:) = dec2hex(Wnr_imag) %Parte imaginaria
end
Comparación de resultados FFT
El proceso de simulación en MATLAB de la FFT implementada en Verilog es el siguiente; también incluye la comparación de los dos tipos de resultados FFT.
Ejemplo
%=======================================================
% 8dots fft
%=======================================================
for r=0:3
Wnr(r+1) = cos(pi/4*r) - j*sin(pi/4*r) ;
end
x = [10, 20, 30, 40, 10, 20 ,30 ,40];
step = [1+2j, 1+5j, 31+3j, 1+6j, 23+4j, 1+8j, 6+11j, 1+7j];
x2 = x + step;
xm0 = [x2(0+1), x2(4+1), x2(2+1), x2(6+1), x2(1+1), x2(5+1), x2(3+1), x2(7+1)] ;
%% stage1
xm1(1) = xm0(1) + xm0(2)*Wnr(1) ;
xm1(2) = xm0(1) - xm0(2)*Wnr(1) ;
xm1(3) = xm0(3) + xm0(4)*Wnr(1) ;
xm1(4) = xm0(3) - xm0(4)*Wnr(1) ;
xm1(5) = xm0(5) + xm0(6)*Wnr(1) ;
xm1(6) = xm0(5) - xm0(6)*Wnr(1) ;
xm1(7) = xm0(7) + xm0(8)*Wnr(1) ;
xm1(8) = xm0(7) - xm0(8)*Wnr(1) ;
floor(xm1(:))
%% stage2
xm2(1) = xm1(1) + xm1(3)*Wnr(1) ;
xm2(3) = xm1(1) - xm1(3)*Wnr(1) ;
xm2(2) = xm1(2) + xm1(4)*Wnr(2) ;
xm2(4) = xm1(2) - xm1(4)*Wnr(2) ;
xm2(5) = xm1(5) + xm1(7)*Wnr(1) ;
xm2(7) = xm1(5) - xm1(7)*Wnr(1) ;
xm2(6) = xm1(6) + xm1(8)*Wnr(2) ;
xm2(8) = xm1(6) - xm1(8)*Wnr(2) ;
floor(xm2(:))
%% stage3
xm3(1) = xm2(1) + xm2(5)*Wnr(1) ;
xm3(5) = xm2(1) - xm2(5)*Wnr(1) ;
xm3(2) = xm2(2) + xm2(6)*Wnr(2) ;
xm3(6) = xm2(2) - xm2(6)*Wnr(2) ;
xm3(3) = xm2(3) + xm2(7)*Wnr(3) ;
xm3(7) = xm2(3) - xm2(7)*Wnr(3) ;
xm3(4) = xm2(4) + xm2(8)*Wnr(4) ;
xm3(8) = xm2(4) - xm2(8)*Wnr(4) ;
floor(xm3(:))
%% fft
fft1 = fft(x)
fft2 = fft(x2)
plot(1:8, abs(fft2))
hold on
plot(1:8, abs(xm3), 'r')
Descarga del código fuente
Download