Réseau de neurones récurrent (RNN)
Un réseau de neurones récurrent (RNN) est un réseau de neurones spécialement conçu pour le traitement de données séquentielles (telles que le texte, la parole et les séries temporelles).
Contrairement aux réseaux de neurones à propagation avant traditionnels, les RNN possèdent une capacité de « mémoire » qui peut conserver les informations des étapes précédentes.
Les RNN utilisent l'état caché de l'étape précédente pour influencer la sortie de l'étape actuelle, capturant ainsi les dépendances temporelles dans les séquences.
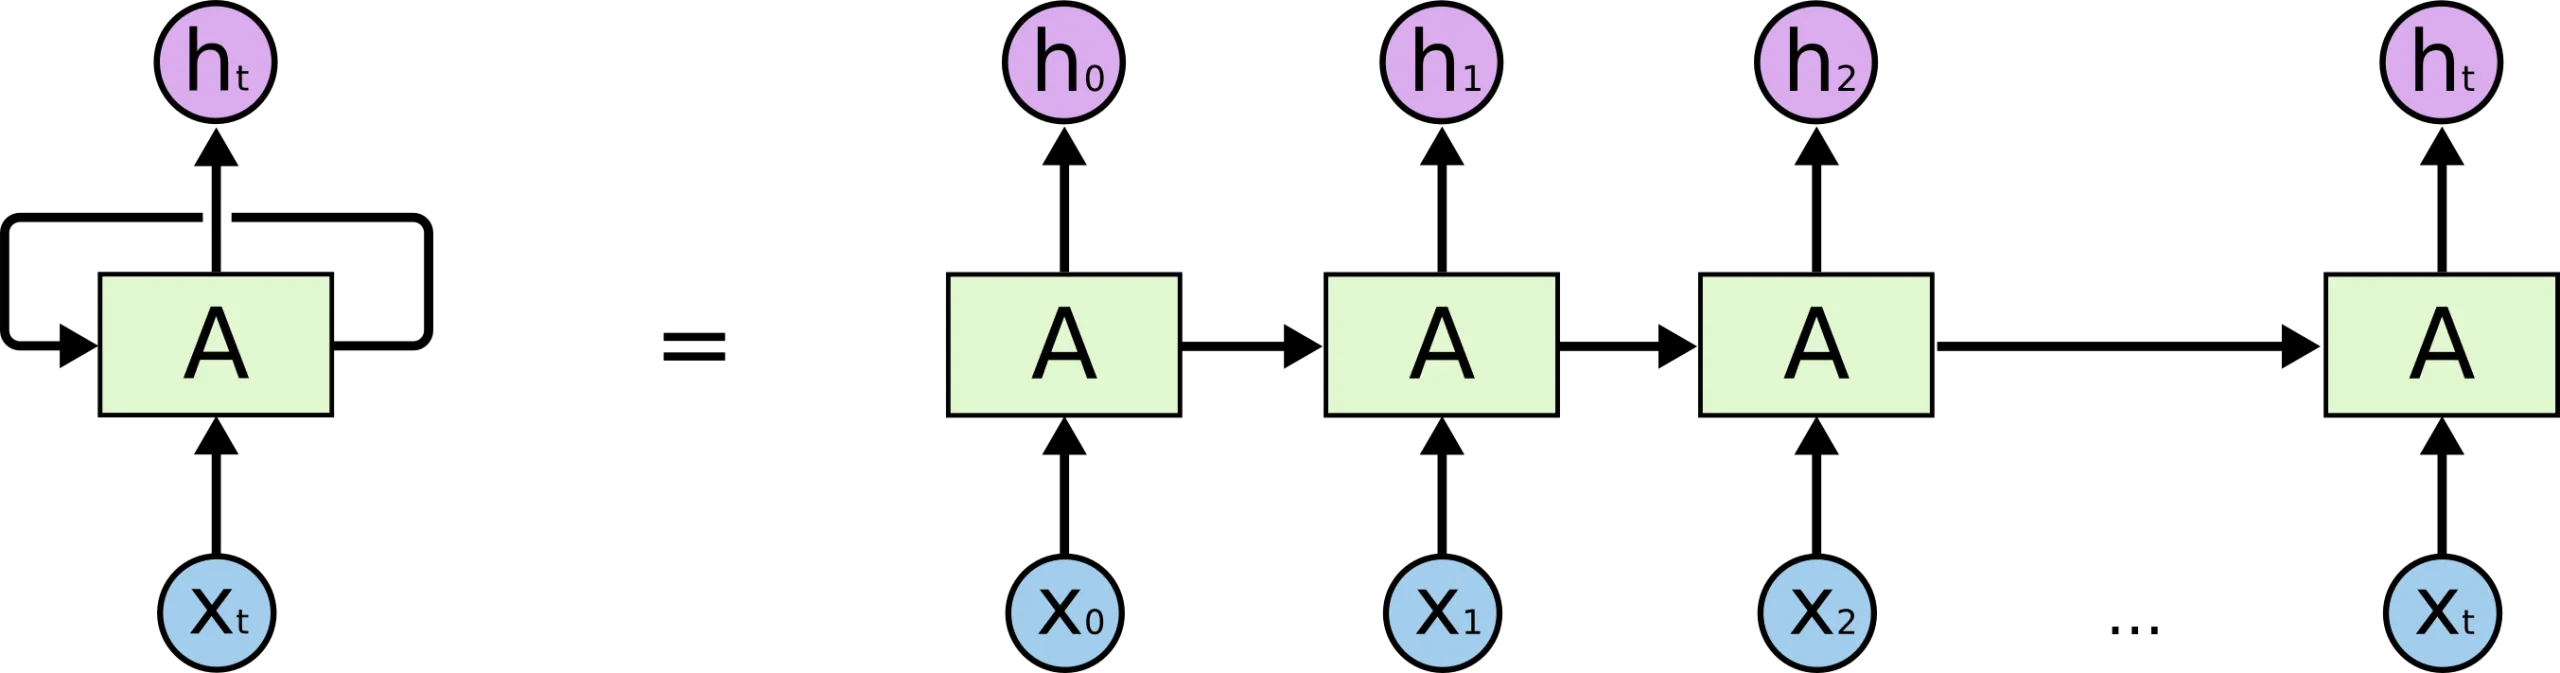
Idée essentielle des RNN
Le cœur des RNN réside dansles connexions récurrentes(Recurrent Connection), ce qui signifie que la sortie du réseau dépend non seulement de l'entrée actuelle, mais aussi des entrées de tous les pas de temps précédents. Cette structure permet aux RNN de traiter des données séquentielles de longueur arbitraire.
Réseaux de neurones traditionnels: les entrées et les sorties sont indépendantes (par exemple, la classification d'images, où les images individuelles ne sont pas liées entre elles).
RNN: grâce auxconnexions récurrentes(Recurrent Connection), l'état caché de l'étape précédente est transmis à l'étape suivante, formant une « mémoire ».
Entrée à chaque étape = données actuelles + état caché de l'étape précédente.
La sortie dépend non seulement de l'entrée actuelle, mais aussi du contexte de toutes les étapes précédentes.
Tout comme lors de la lecture d'une phrase, la compréhension du mot actuel dépend du contenu déjà lu (par exemple, « Il a ouvert __ », vous prédiriez « la porte » ou « le livre »).
Exemple
import numpy as np
class SimpleRNN:
def __init__(self, input_size, hidden_size):
self.Wx = np.random.randn(hidden_size, input_size) # Poids d'entrée
self.Wh = np.random.randn(hidden_size, hidden_size) # Poids de l'état caché
self.b = np.zeros((hidden_size, 1)) # Terme de biais
def forward(self, x, h_prev):
h_next = np.tanh(np.dot(self.Wx, x) + np.dot(self.Wh, h_prev) + self.b)
return h_next
Comment fonctionne un RNN
À chaque pas de temps t, le RNN effectue les calculs suivants :
- Reçoit l'entrée courante xₜ et l'état caché hₜ₋₁ du pas de temps précédent
- Calcule le nouvel état caché hₜ = f(Wₕₕ·hₜ₋₁ + Wₓₕ·xₜ + b)
- Produit la sortie yₜ = g(Wₕᵧ·hₜ + c)
Où f et g sont généralement des fonctions d'activation (telles que tanh ou softmax).
Avantages et inconvénients des RNN
Avantages:
- Peut gérer des séquences de longueur variable
- Peut théoriquement mémoriser des informations historiques de longueur arbitraire
- Partage de paramètres (le même ensemble de poids est utilisé pour tous les pas de temps)
Inconvénients:
- Problème de disparition/explosion du gradient (difficile d'apprendre les dépendances à long terme)
- Faible efficacité de calcul (ne peut pas traiter les pas de temps en parallèle)
Mémoire à long terme et à court terme (LSTM)
LSTM (Long Short-Term Memory) est une architecture améliorée des RNN, spécialement conçue pour résoudre le problème de dépendance à long terme des RNN standard.
2.1 Structure centrale du LSTM
Le LSTM introduit trois mécanismes de portes et une cellule mémoire :
| Composant | Fonction |
|---|---|
| Porte d'entrée | Contrôle le flux de nouvelles informations |
| Porte d'oubli | Décide quelles anciennes informations écarter |
| Porte de sortie | Contrôle la quantité d'informations à sortir |
| Cellule mémoire | Stocke l'état à long terme |
Exemple
class LSTMCell:
def __init__(self, input_size, hidden_size):
# Combiner les poids de toutes les portes
self.W = np.random.randn(4*hidden_size, input_size+hidden_size)
self.b = np.random.randn(4*hidden_size, 1)
def forward(self, x, h_prev, c_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Diviser pour obtenir chaque porte
f_gate = sigmoid(gates[:hidden_size]) # Porte d'oubli
i_gate = sigmoid(gates[hidden_size:2*hidden_size]) # Porte d'entrée
o_gate = sigmoid(gates[2*hidden_size:3*hidden_size]) # Porte de sortie
c_candidate = np.tanh(gates[3*hidden_size:]) # Mémoire candidate
# Mettre à jour la mémoire et l'état caché
c_next = f_gate * c_prev + i_gate * c_candidate
h_next = o_gate * np.tanh(c_next)
return h_next, c_next
Comment LSTM résout le problème de dépendance à long terme
- Mémoire sélective: La porte d'oubli peut décider de conserver ou de supprimer des informations spécifiques
- Chemin du gradient: La cellule mémoire fournit un chemin relativement direct pour la propagation du gradient
- Protection de l'information: Le contenu de mémoire stocké n'est pas directement modifié par les opérations à chaque pas de temps
Unité récurrente à portes (GRU)
GRU (Unité récurrente à portes) est une version simplifiée de LSTM qui réduit le nombre de paramètres tout en conservant des performances similaires.
Structure de base du GRU
GRU fusionne certains composants de LSTM :
| Composant | Fonction |
|---|---|
| Porte de mise à jour | Décide de la quantité d'informations anciennes à conserver |
| Porte de réinitialisation | Décide comment combiner les informations nouvelles et anciennes |
| Activation candidate | Nouvel état calculé à partir de la porte de réinitialisation |
Exemple
class GRUCell:
def __init__(self, input_size, hidden_size):
self.W = np.random.randn(3*hidden_size, input_size+hidden_size)
self.b = np.random.randn(3*hidden_size, 1)
def forward(self, x, h_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Séparation des signaux de porte
z = sigmoid(gates[:hidden_size]) # Porte de mise à jour
r = sigmoid(gates[hidden_size:2*hidden_size]) # Porte de réinitialisation
h_candidate = np.tanh(np.dot(self.W[2*hidden_size:],
np.vstack((r*h_prev, x))) + self.b[2*hidden_size:]
# Mettre à jour l'état caché
h_next = (1-z)*h_prev + z*h_candidate
return h_next
GRU vs LSTM
| Fonctionnalité | GRU | LSTM |
|---|---|---|
| Nombre de paramètres | Moins | Plus |
| Vitesse d'entraînement | Plus rapide | Plus lent |
| Cellule mémoire | Aucune | Oui |
| Nombre de portes | 2 | 3 |
| Performance | Meilleur pour les petits jeux de données | Peut être meilleur pour les grands jeux de données |
RNN bidirectionnel (Bi-RNN)
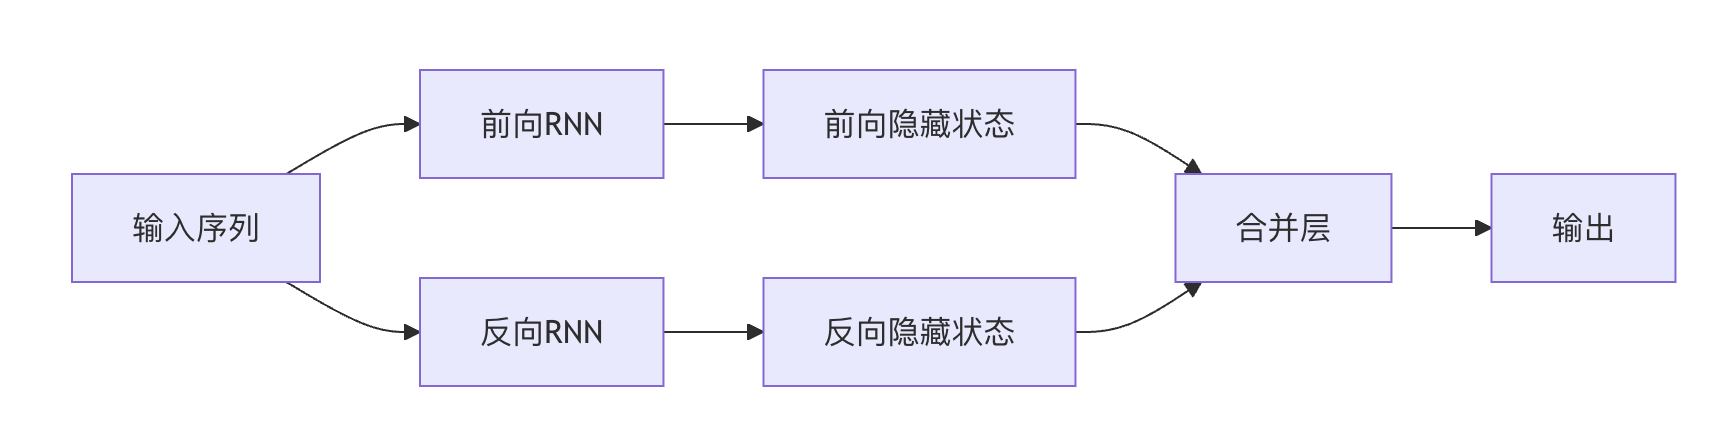
Le RNN bidirectionnel améliore la capacité de modélisation de séquence en considérant simultanément les informations contextuelles passées et futures.
Architecture du RNN bidirectionnel
Le Bi-RNN se compose de deux couches RNN indépendantes :
- Couche avant : traite la séquence dans l'ordre chronologique
- Couche arrière : traite la séquence dans l'ordre chronologique inverse
La sortie finale est une combinaison des sorties des deux directions (généralement une concaténation ou une somme).
Scénarios d'application des RNN bidirectionnels
- Traitement du langage naturel: étiquetage morphosyntaxique, reconnaissance d'entités nommées
- Reconnaissance vocale: utilise le contexte environnant pour améliorer la précision
- Bioinformatique: prédiction de la structure des protéines
- Prévision de séries temporelles: prend en compte les tendances historiques et futures
LSTM/GRU bidirectionnel
Dans les applications modernes, les RNN bidirectionnels utilisent généralement LSTM ou GRU comme unité de base :
Exemple
model.add(Bidirectional(LSTM(64))) # Créer une couche LSTM bidirectionnelle
Exercices pratiques
Exercice 1 : Implémenter un RNN simple
Utilisez Python et NumPy pour implémenter un RNN simple capable de génération de texte au niveau des caractères.
Exercice 2 : Analyse de sentiment avec LSTM
Utilisez Keras pour construire un classifieur de sentiment d'avis de films basé sur LSTM.
Exercice 3 : Reconnaissance d'entités nommées avec GRU bidirectionnel
Implémentez un modèle GRU bidirectionnel pour identifier des entités telles que les noms de personnes et les lieux dans le texte.
Exercice 4 : Expérience comparative
Comparez les différences de performance du RNN vanilla, du LSTM et du GRU sur le même jeu de données.
Résumé et approfondissement
Les RNN et leurs variantes sont des outils puissants pour traiter des données séquentielles. Pour les maîtriser en profondeur :
- Comprendre comment les gradients se propagent dans les RNN
- Apprendre comment le mécanisme d'attention améliore les RNN
- Explorer la relation entre l'architecture Transformer et les RNN
- Pratiquer diverses tâches de modélisation de séquences (traduction automatique, synthèse vocale, etc.)