Arquitectura Transformer
La arquitectura Transformer es un modelo de aprendizaje profundo basado en el mecanismo de autoatención (Self-Attention), propuesto por el equipo de Google en el artículo de 2017《Attention Is All You Need》y presentado por primera vez en dicho artículo.
Transformer ha transformado por completo el campo del procesamiento del lenguaje natural (NLP) y se ha convertido en la base fundamental de los modelos modernos de lenguaje de gran escala (como GPT, BERT, etc.).
Transformer, similar a las redes neuronales recurrentes (RNN), está diseñado para procesar datos de entrada secuenciales como el lenguaje natural, y es adecuado para tareas como la traducción automática y el resumen de texto. Sin embargo, a diferencia de las RNN, Transformer no necesita procesar la secuencia paso a paso, sino que puede procesar toda la entrada en paralelo de una sola vez.
Este capítulo te ayudará a comprender en profundidad la idea central, la composición de la arquitectura y el principio de funcionamiento de Transformer, permitiéndote dominar los conceptos básicos de esta tecnología revolucionaria.
Diagrama de la arquitectura Transformer
A la izquierda está el codificador, a la derecha el decodificador.
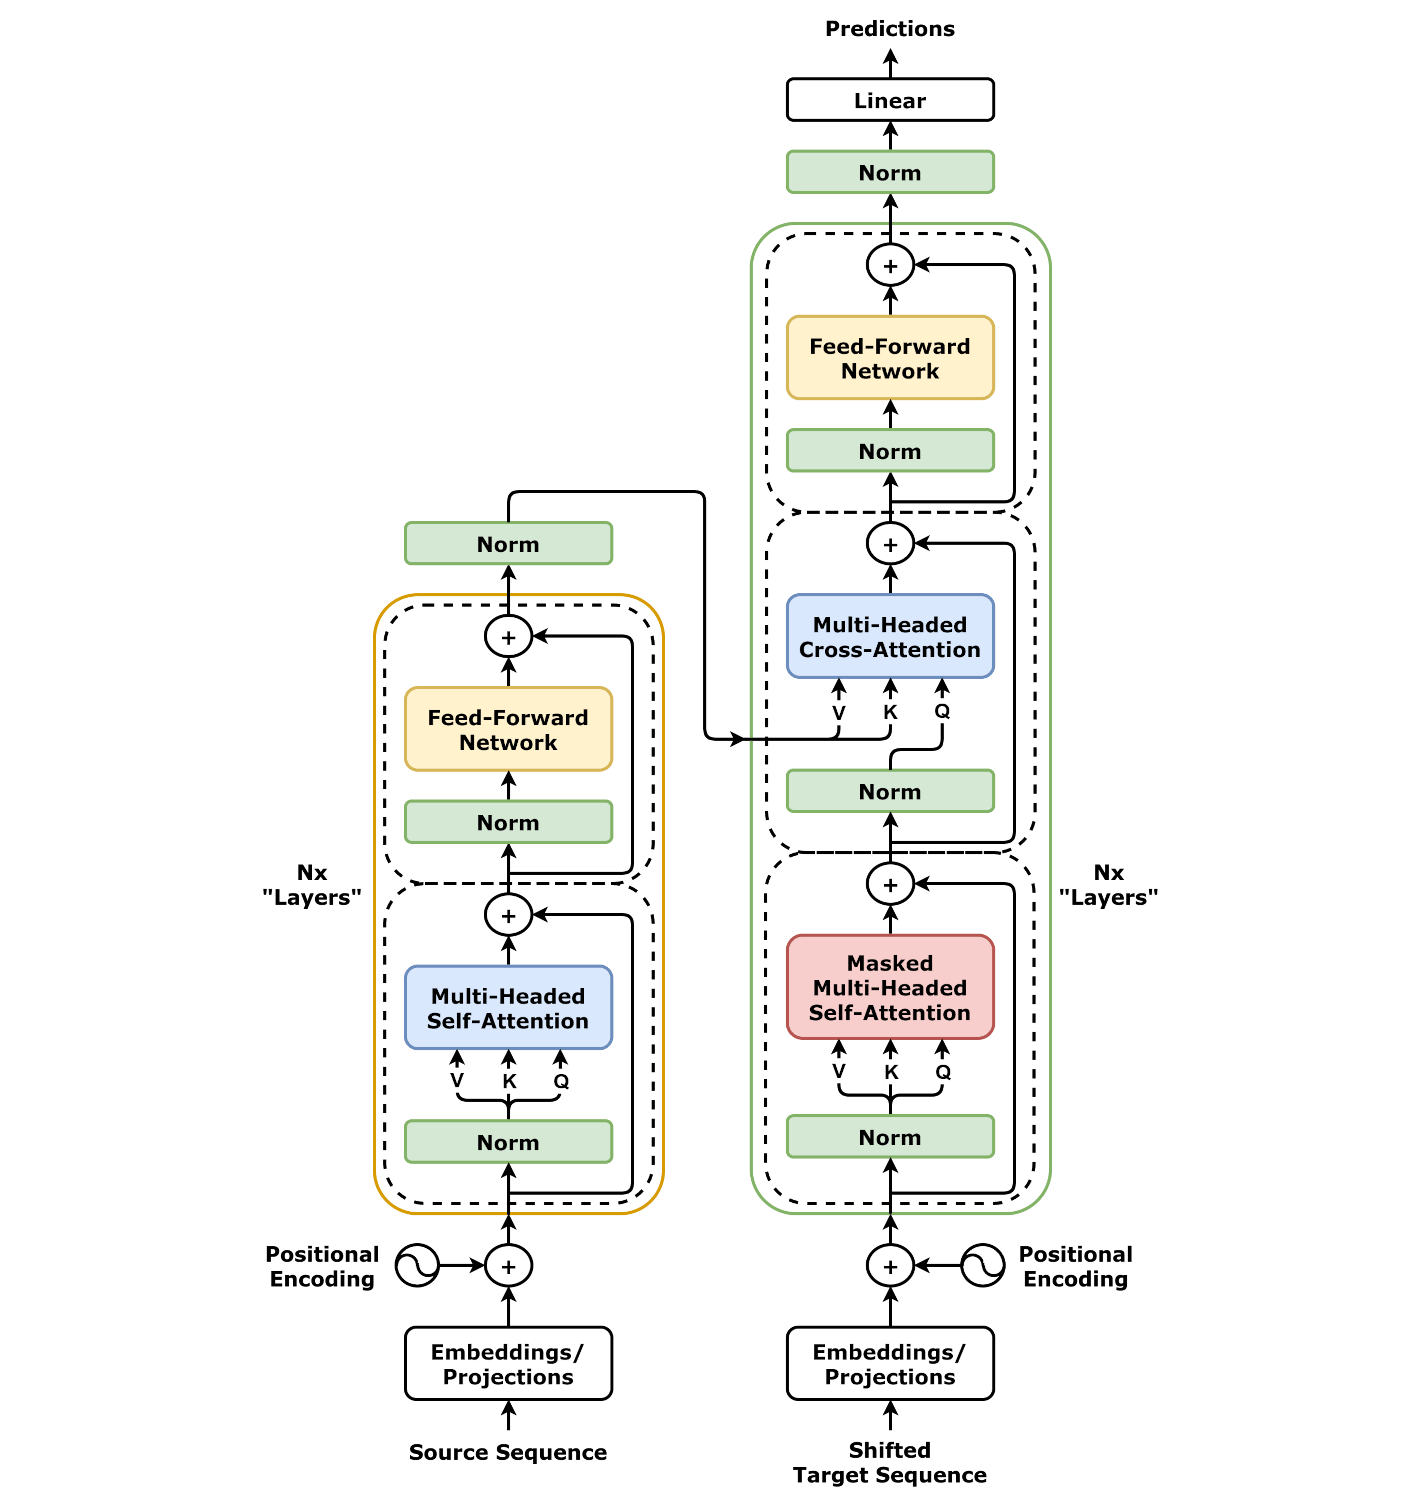
1. Procesamiento de entrada (parte inferior)
- Embeddings/Projections (capas de incrustación/proyección)
- Función: convierte las palabras (o tokens) de entrada en vectores numéricos (por ejemplo, 'gato' → [0.2, -0.5, 0.7…]).
- Analogía: es como asignar a cada palabra un 'número de identificación' único, pero más inteligente (incluye información semántica).
2. Codificador (lado izquierdo)
-
Multi-Headed Self-Attention (autoatención multicabeza)
- Función: permite que el modelo preste atención a todas las palabras de la entrada simultáneamente y calcule las relaciones entre ellas.
- Ejemplo: en la oración 'el gato persigue al ratón', el modelo aprende que la relación entre 'gato' y 'ratón' es más fuerte que entre 'gato' y 'persigue'.
- Clave:Procesa todas las palabras en paralelo, a diferencia de las RNN que requieren cálculo paso a paso.
-
Norm (normalización de capa)
- Función: estabiliza el proceso de entrenamiento y evita que los valores sean demasiado grandes o pequeños (similar a ajustar el 'volumen' al rango adecuado).
-
Feed-Forward Network (red neuronal de avance)
- Función: procesa aún más la representación de cada palabra (por ejemplo, extrae características más complejas).
- Analogía: es como hacer una interpretación profunda del vector de 'gato', añadiendo detalles (por ejemplo, 'el gato es un mamífero').
3. Decodificador (lado derecho)
-
Masked Multi-Headed Self-Attention (autoatención multicabeza con máscara)
- Función: evitar que el modelo 'haga trampa' durante el entrenamiento (solo puede ver las palabras actuales y anteriores, no las futuras).
- Ejemplo: al generar 'yo amo __', el modelo solo puede predecir la siguiente palabra basándose en 'yo' y 'amo', no puede saber de antemano que la respuesta es 'tú'.
-
Multi-Headed Cross-Attention (atención cruzada multicabeza)
- Función: permite que el decodificador pregunte al codificador: '¿En qué parte de la entrada debería centrarme?'
- Escenario: en tareas de traducción, cuando el decodificador genera texto en inglés, consulta la entrada en chino procesada por el codificador.
-
Norm y Feed-Forward Network
- Similar al codificador, normaliza y procesa en profundidad las representaciones del decodificador.
4. Salida (parte superior)
- Linear (capa lineal)
- Función: mapea la salida del decodificador al vocabulario (por ejemplo, predice que la siguiente palabra con mayor probabilidad es 'tú').
- Ejemplo: con la entrada 'yo amo', el modelo puede dar una probabilidad del 80% para 'tú' y del 10% para 'comer'…
Idea central de Transformer
Mecanismo de autoatención (Self-Attention)
La idea central de Transformer es depender completamente del mecanismo de atención (sin necesidad de estructuras recurrentes o convolucionales) para capturar las dependencias globales en la secuencia de entrada, logrando así un cálculo paralelo eficiente y un modelado de dependencias de largo alcance más fuerte.
Ejemplo
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) # Calcular la similitud
weights = torch.softmax(scores, dim=-1) # Convertir a distribución de probabilidad
output = torch.matmul(weights, value) # Suma ponderada
return output
Fórmula:
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
- \(Q\) (Query), \(K\) (Key) y \(V\) (Value) son matrices obtenidas mediante transformaciones lineales de la entrada.
- \(\sqrt{d_k}\) es el factor de escala, que evita que el producto punto sea demasiado grande y cause la desaparición del gradiente.
Atención multicabeza (Multi-Head Attention)
- El mecanismo de autoatención se ejecuta varias veces en paralelo (múltiples 'cabezas'), cada cabeza aprende diferentes patrones de atención y los resultados se concatenan al final.
- Ventaja: captura información contextual más rica (como dependencias locales/globales, características sintácticas/semánticas).
Codificación posicional (Positional Encoding)
- Transformer en sí no tiene estructuras recurrentes ni convolucionales, por lo que no puede percibir directamente el orden de la secuencia; por lo tanto, necesita inyectar explícitamente información posicional.
- Utiliza funciones seno/coseno o codificaciones posicionales aprendibles:
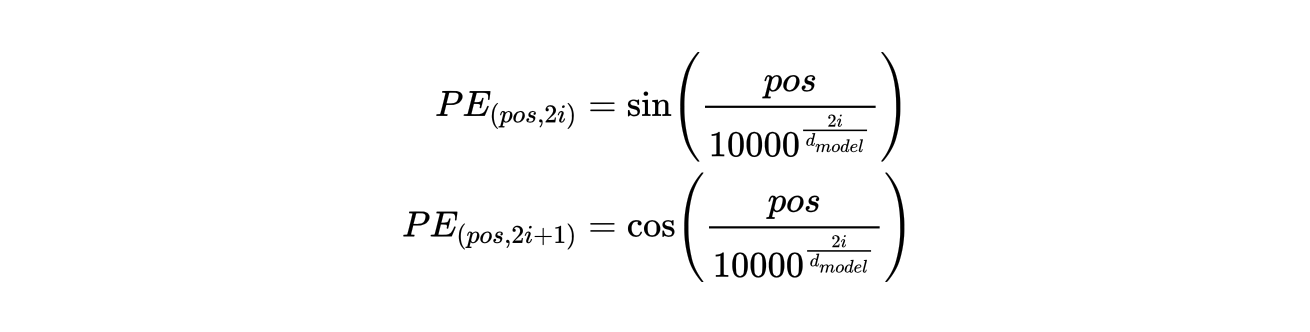
Red neuronal de avance (Feed-Forward Network, FFN)
- La representación de cada posición se transforma aún más mediante una red totalmente conectada de dos capas (con activación no lineal, como ReLU).
- Fórmula: \( \text{FFN}(x) = \max(0, xW_1 + b_1)W_2 + b_2 \).
Conexión residual y normalización de capa (Residual Connection & Layer Norm)
- Conexión residual: suma directamente la entrada a la salida (como \( x + \text{Sublayer}(x) \)), aliviando la desaparición del gradiente.
- Normalización de capa: normaliza la salida de cada capa para acelerar el entrenamiento.
Capacidad de procesamiento en paralelo
A diferencia de las RNN/LSTM tradicionales, Transformer puede procesar toda la secuencia en paralelo, lo que mejora enormemente la eficiencia del entrenamiento.
Modelado de dependencias globales
No importa cuán lejos estén las palabras entre sí, Transformer puede establecer dependencias directamente, resolviendo el problema de las dependencias de largo alcance.
Estructura codificador-decodificador
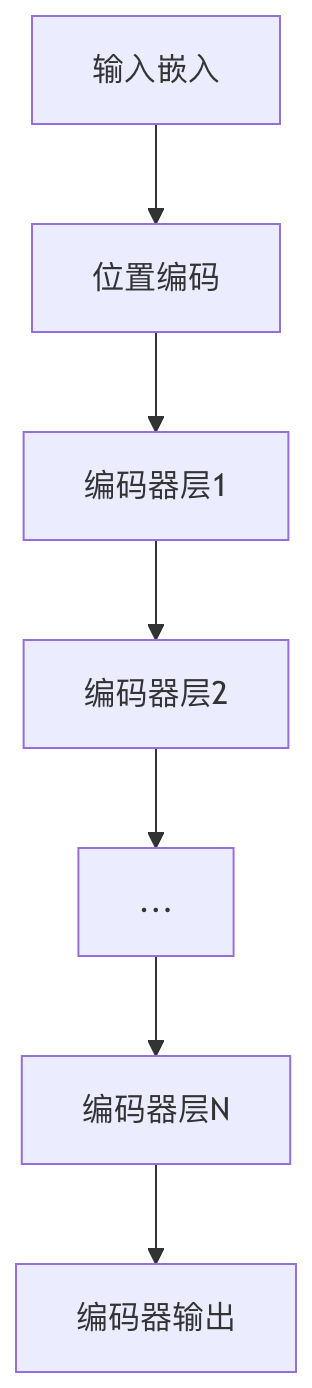
Transformer adopta la arquitectura clásica de codificador-decodificador, pero cada parte está compuesta por múltiples capas de módulos idénticos apilados.
Codificador (Encoder)
| Componente | Descripción de la función | Importancia |
|---|---|---|
| Atención multicabeza | Captura información semántica de diferentes subespacios | ★★★★★ |
| Red de avance | Transformación no lineal y extracción de características | ★★★★ |
| Conexión residual | Alivia el problema de la desaparición del gradiente | ★★★★ |
| Normalización de capa | Estabiliza el proceso de entrenamiento | ★★★★ |
Decodificador (Decoder)
El decodificador añade, sobre la base del codificador:
- Atención multicabeza con máscara: evita que la posición actual preste atención a información futura
- Atención codificador-decodificador: integra información del idioma de origen
Codificación posicional (Positional Encoding)
Debido a que Transformer no tiene estructuras recurrentes, es necesario inyectar explícitamente la información posicional.
Fórmula de codificación posicional sinusoidal
La fórmula se divide en dos partes, correspondientes a las dimensiones pares e impares del vector de codificación posicional:Dimensión par (2i),Dimensión impar (2i+1)。
Descripción de parámetros:
pos: posición de la palabra en la secuencia (por ejemplo, 1.ª palabra, 2.ª palabra, etc.).i: índice de dimensión del vector de codificación posicional (0 ≤ i < d_model/2)。d_model: dimensión de la codificación posicional (normalmente igual a la dimensión del vector de palabras, como 512, 768, etc.).
Características de la codificación posicional
- Sensible a la posición relativa: puede aprender relaciones de posición relativa
- Longitud escalable: puede manejar secuencias más largas que las de entrenamiento
- Determinístico: no necesita aprendizaje, se calcula directamente
Ejemplo
class PositionalEncoding(nn.Module):
def __init__(self, d_model, max_len=5000):
super().__init__()
position = torch.arange(max_len).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
pe = torch.zeros(max_len, d_model)
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe)
Ventajas de Transformer
Comparación con arquitecturas tradicionales
| Característica | Transformer | RNN/LSTM | CNN |
|---|---|---|---|
| Paralelismo | Completamente paralelo | Procesamiento de secuencias | Paralelismo local |
| Dependencia de larga distancia | Modelado directo | Transmisión gradual | Campo receptivo limitado |
| Velocidad de entrenamiento | Rápido | Lento | Media |
| Consumo de memoria | Alto | Medio | bajo |
Ventajas en aplicaciones prácticas
- Rendimiento excepcional: alcanza el estado del arte en la mayoría de las tareas de PLN
- Escalabilidad: el tamaño del modelo puede ampliarse fácilmente (como GPT-3)
- Adaptación multimodal: se puede aplicar a múltiples tipos de datos como texto, imágenes, voz, etc.
- Amigable con el aprendizaje por transferencia: el paradigma de preentrenamiento + ajuste fino es muy efectivo
Ejercicios prácticos
Ejercicio 1: Implementar autoatención básica
Ejemplo
import torch.nn.functional as F
def scaled_dot_product_attention(Q, K, V, mask=None):
d_k = Q.size(-1)
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, V)
Ejercicio 2: Comprender la codificación posicional
- Visualizar los vectores de codificación posicional en diferentes posiciones
- Calcular la similitud entre codificaciones posicionales y observar las relaciones de posición
Preguntas frecuentes
P: ¿Por qué el Transformer es más adecuado que las RNN para textos largos?R: Las RNN necesitan transmitir información paso a paso, y las dependencias de larga distancia se pierden fácilmente; mientras que el Transformer puede establecer directamente la relación entre dos palabras cualesquiera.
P: ¿Por qué se elige la función seno para la codificación posicional?R: La función seno es periódica y puede representar relaciones de posición relativa, además de poder extenderse a longitudes de secuencia no vistas en el entrenamiento.
P: ¿Dónde está el principal cuello de botella computacional del Transformer?R: La complejidad espacial del mecanismo de autoatención es O(n²), y procesar secuencias largas consume una gran cantidad de memoria.
Resumen
La arquitectura Transformer ha revolucionado la forma de modelar secuencias mediante el mecanismo de autoatención; sus ventajas principales son:
- Gran capacidad de cálculo paralelo
- Modelado eficiente de dependencias de largo plazo
- Flexibilidad y escalabilidad
- Excelente rendimiento
Dominar los principios básicos del Transformer es una base importante para aprender las técnicas modernas de PLN, y también es la clave para comprender modelos de vanguardia como BERT y GPT.
Otras extensiones