Calcul de similarité textuelle en NLP
Le calcul de similarité textuelle est une tâche fondamentale du traitement du langage naturel (NLP), visant à quantifier le degré de similarité entre deux segments de texte. Cette technologie est largement utilisée dans divers domaines tels que la recherche d'information, les systèmes de questions-réponses, la détection de plagiat et les systèmes de recommandation.
Concepts fondamentaux
- Similarité sémantique: mesure la proximité de signification des textes
- Similarité littérale: mesure le degré de chevauchement du vocabulaire de surface des textes
- Modèle d'espace vectoriel: Représente les textes sous forme de vecteurs dans un espace de grande dimension
- Métriques de distance: Calcule la distance ou la similarité entre les vecteurs
Méthodes courantes de calcul de similarité textuelle
1. Méthodes basées sur la fréquence des mots
Modèle de sac de mots
Exemple
from sklearn.feature_extraction.text import CountVectorizer
corpus = [
'J'aime le traitement du langage naturel',
'J'adore apprendre la technologie NLP',
'Le calcul de similarité textuelle est très intéressant'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
corpus = [
'J'aime le traitement du langage naturel',
'J'adore apprendre la technologie NLP',
'Le calcul de similarité textuelle est très intéressant'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
Méthode TF-IDF
Exemple
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
2. Méthodes basées sur les vecteurs de mots
Similarité Word2Vec
Exemple
from gensim.models import Word2Vec
sentences = [
['I','like','natural language processing'],
['I','love','learning','NLP','technology'],
['text','similarity','calculation','very','interesting']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['natural language processing'] # Obtenir les vecteurs de mots
sentences = [
['I','like','natural language processing'],
['I','love','learning','NLP','technology'],
['text','similarity','calculation','very','interesting']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['natural language processing'] # Obtenir les vecteurs de mots
Calcul du vecteur de phrase
Exemple
import numpy as np
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['I','like','natural language processing'], model)
sentence_vec2 = sentence_vector(['I','love','NLP'], model)
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['I','like','natural language processing'], model)
sentence_vec2 = sentence_vector(['I','love','NLP'], model)
3. Méthodes basées sur des modèles pré-entraînés
Calcul de similarité BERT
Exemple
from transformers import BertTokenizer, BertModel
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
Métriques de similarité
Métriques de distance courantes
| Nom de la méthode | Formule | Caractéristiques |
|---|---|---|
| Similarité cosinus | cos(θ) = (A·B)/(|A||B|) | Ignore la longueur du vecteur, se concentre sur la direction |
| Distance euclidienne | √Σ(Ai-Bi)² | Considère la position absolue des vecteurs |
| Distance de Manhattan | Σ|Ai-Bi| | Insensible aux valeurs aberrantes |
| Similarité de Jaccard | |A∩B|/|A∪B| | Adapté à la similarité d'ensembles |
Exemples d'implémentation de code
Exemple
from sklearn.metrics.pairwise import cosine_similarity
# Calculer la similarité cosinus
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Similarité du texte : {similarity)
# Calculer la similarité cosinus
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Similarité du texte : {similarity)
Exemples d'applications pratiques
Détection de similarité des titres d'actualités
Exemple
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity
# Exemple de données
titles = [
"Apple sort un nouvel iPhone",
"Apple Inc. lance le dernier smartphone",
"Microsoft annonce son rapport de résultats trimestriels",
"Google annonce un nouveau plan d'intelligence artificielle"
]
# Calculer la matrice de similarité
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Afficher les résultats
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
from sklearn.metrics.pairwise import cosine_similarity
# Exemple de données
titles = [
"Apple sort un nouvel iPhone",
"Apple Inc. lance le dernier smartphone",
"Microsoft annonce son rapport de résultats trimestriels",
"Google annonce un nouveau plan d'intelligence artificielle"
]
# Calculer la matrice de similarité
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Afficher les résultats
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
Analyse des résultats
                         苹果发布新款iPhone手机  苹果公司推出最新智能手机  微软公布季度财报  谷歌宣布新的人工智能计划
苹果发布新款iPhone手机           1.000000         0.723417     0.000000         0.000000
苹果公司推出最新智能手机         0.723417         1.000000     0.000000         0.000000
微软公布季度财报               0.000000         0.000000     1.000000         0.204598
谷歌宣布新的人工智能计划         0.000000         0.000000     0.204598         1.000000
Techniques avancées et défis
1. Traitement des textes ayant une sémantique similaire mais un vocabulaire différent
Exemple
text1 = "J'aime les chats"
text2 = "Je déteste les chiens"
# La similarité de surface est faible, mais tous deux expriment sémantiquement des attitudes envers les animaux
text2 = "Je déteste les chiens"
# La similarité de surface est faible, mais tous deux expriment sémantiquement des attitudes envers les animaux
2. Résoudre le problème de la polysémie
Exemple
# « Apple » peut désigner un fruit ou une entreprise
text1 = "La pomme est très sucrée"
text2 = "La valeur marchande d'Apple atteint un nouveau sommet"
text1 = "La pomme est très sucrée"
text2 = "La valeur marchande d'Apple atteint un nouveau sommet"
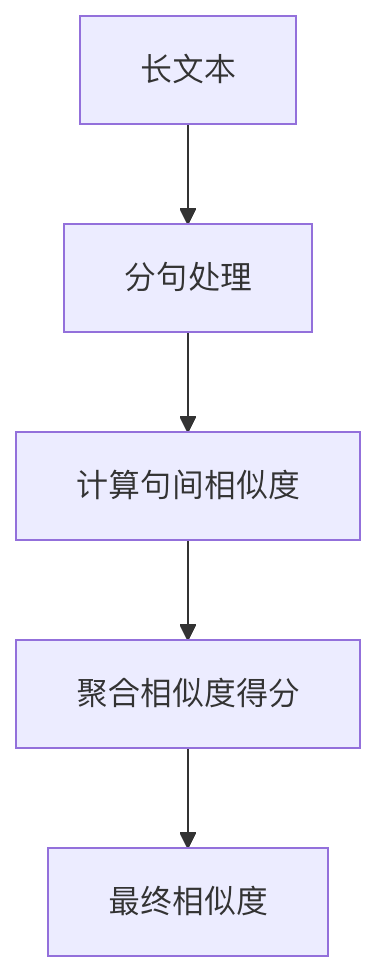
3. Calcul de similarité de textes longs
Recommandations de bonnes pratiques
Le prétraitement des données est important
- Normaliser la casse
- Supprimer les mots vides
- Racinisation / Lemmatisation
Choisir les méthodes en fonction du scénario
- Textes courts : modèles pré-entraînés tels que BERT
- Documents longs : TF-IDF + similarité cosinus
- Systèmes en temps réel : modèles légers tels que Word2Vec
Tenir compte de l'efficacité de calcul
- Utiliser des algorithmes de recherche approximative des plus proches voisins (ANN) pour les données à grande échelle
- Envisager d'utiliser des bibliothèques efficaces de recherche de similarité telles que Faiss
Évaluation et optimisation continues
- Construire un ensemble d'évaluation manuel
- Surveiller les performances dans les environnements de production
- Mettre régulièrement à jour les modèles