Analyse complète des frameworks d'apprentissage profond : de TensorFlow au déploiement de modèles
 Référence des commandes Linux
Vue d'ensemble des frameworks d'apprentissage profond
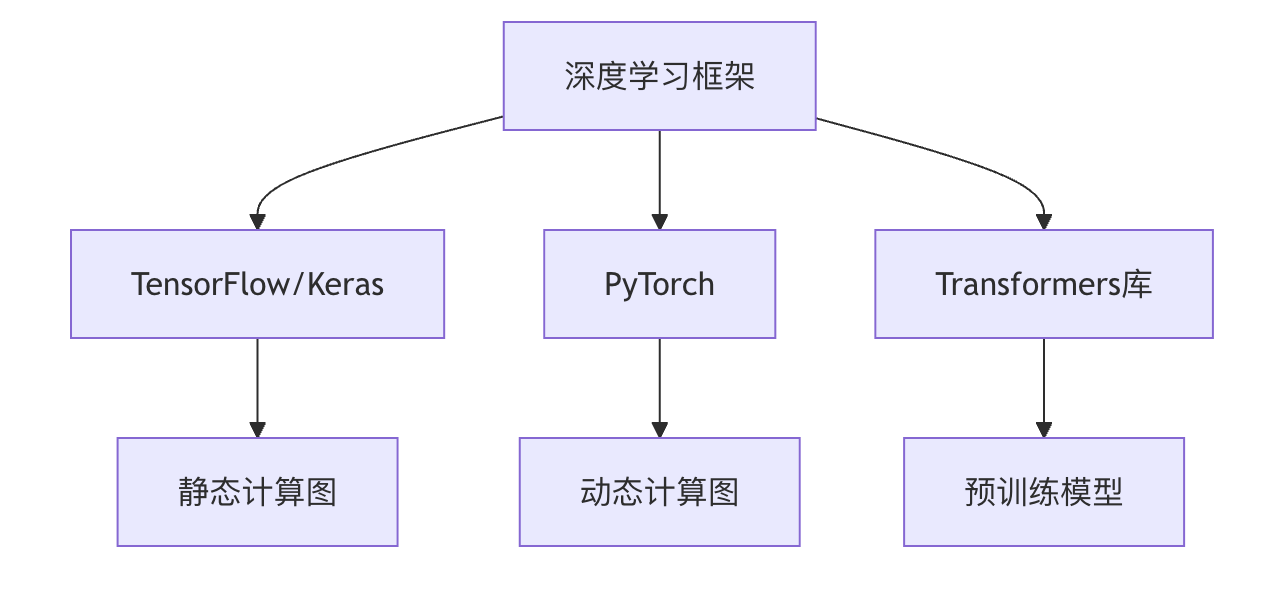
Les frameworks d'apprentissage profond sont la pierre angulaire du développement moderne de l'IA. Ils fournissent une gamme d'outils et d'interfaces qui permettent aux développeurs de construire, entraîner et déployer efficacement des modèles de réseaux de neurones. Les principaux frameworks d'apprentissage profond incluent :
- TensorFlow/Keras: un framework de qualité industrielle développé par Google, adapté aux environnements de production
- PyTorch: un framework orienté recherche dirigé par Facebook, avec des fonctionnalités notables de graphe de calcul dynamique
- Transformers Library: un framework dédié au traitement du langage naturel introduit par HuggingFace
TensorFlow/Keras expliqué
Architecture centrale
TensorFlow adopte une conception en couches :
- API front-end: interfaces pour des langages tels que Python, C++, etc.
- Graphe de calcul: représente les opérations sous forme de graphe orienté acyclique (DAG)
- Runtime distribué: s'exécute sur CPU/GPU/TPU
API de haut niveau Keras
Keras, en tant qu'API de haut niveau officielle de TensorFlow, simplifie le processus de construction de modèles :
Exemples
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(784,)),
layers.Dense(10, activation='softmax')
])
model.compile(optimizer='adam',
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Comparaison des fonctionnalités clés
| Fonctionnalité | TensorFlow | Keras |
|---|---|---|
| Niveau d'abstraction | Bas niveau | Haut niveau |
| Facilité d'utilisation | Relativement complexe | Simple |
| Flexibilité | Élevée | Moyenne |
| Cas d'utilisation typiques | Déploiement en production | Prototypage rapide |
Analyse approfondie de PyTorch
Avantages des graphes de calcul dynamiques
La fonctionnalité principale de PyTorch est legraphe de calcul dynamique(Define-by-Run), ce qui permet :
- Débogage plus intuitif (peut utiliser les outils de débogage Python standard)
- La structure du réseau peut changer dynamiquement
- Plus cohérent avec les conventions de programmation Python
Exemple typique de construction de modèle
Exemple
import torch.nn as nn
import torch.optim as optim
class Net(nn.Module):
def __init__(self):
super(Net, self).__init__()
self.fc1 = nn.Linear(784, 64)
self.fc2 = nn.Linear(64, 10)
def forward(self, x):
x = torch.relu(self.fc1(x))
x = torch.softmax(self.fc2(x), dim=1)
return x
model = Net()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters())
Système de différenciation automatique
Comment fonctionne la différenciation automatique de PyTorch :
- Enregistre le graphe de calcul pendant la propagation avant
- Calcule automatiquement les gradients pendant la rétropropagation
- Via
.backward()déclencher le calcul du gradient
Sujet spécial : Bibliothèque Transformers
Écosystème de modèles pré-entraînés
HuggingFace Transformers propose un large éventail de modèles pré-entraînés :
- BERT (Google)
- GPT (OpenAI)
- RoBERTa (Facebook)
- T5 (Google)
Flux de travail d'utilisation typique
Exemple
# Charger le modèle pré-entraîné et le tokenizer
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
model = AutoModel.from_pretrained("bert-base-uncased")
# Traitement du texte
inputs = tokenizer("Hello world!", return_tensors="pt")
outputs = model(**inputs)
Modes de fine-tuning du modèle
Exemple
training_args = TrainingArguments(
output_dir='./results',
num_train_epochs=3,
per_device_train_batch_size=16
)
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset
)
trainer.train()
Déploiement et optimisation du modèle
Comparaison des solutions de déploiement
| Solution | Scénarios applicables | Chaîne d'outils |
|---|---|---|
| Service sur site | Applications internes d’entreprise | Flask + ONNX |
| Déploiement cloud | Services Internet | AWS SageMaker |
| Informatique en périphérie | Appareils IoT | TensorRT |
| Mobile | Applications mobiles | Core ML |
Techniques d’optimisation des modèles
- **Quantification** :
- Convertir FP32 en INT8
- Réduire l'utilisation de la mémoire de 75%
- Accélérer l'inférence
Exemple
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
**Élagage** :
- Supprimer les connexions neuronales non importantes
- Réduit généralement les paramètres de 60-90%
- Maintient la précision du modèle pratiquement inchangée
Distillation des connaissances:
- Un grand modèle (enseignant) guide un petit modèle (étudiant)
- Préserver les connaissances du grand modèle
- Réduire significativement la taille du modèle
Guide de sélection de framework
Analyse des facteurs de décision
Type de projet:
- Prototype de recherche → PyTorch
- Système de production → TensorFlow
- Tâches NLP → Transformers
Compétences de l'équipe:
- Maîtrise de Python → PyTorch
- Expérience en Java/C++ → TensorFlow Serving
Environnement matériel:
- TPU → TensorFlow
- Plusieurs GPU → PyTorch Distributed
Suggestions de parcours d'apprentissage

Exercices pratiques
Exercice 1 : Comparaison de classification d'images
Implémentez le même modèle CNN en utilisant respectivement TensorFlow et PyTorch, sur le jeu de données CIFAR-10 :
- Comparez la complexité du code
- Enregistrez le temps d'entraînement
- Testez les différences de précision
Exercice 2 : Conversion de modèle
Convertissez un modèle PyTorch en :
- Format ONNX
- Format TensorFlow Lite
- Comparer la vitesse d'inférence avant et après la conversion
Exercice 3 : Pratique de l'optimisation
Choisir un modèle pré-entraîné :
- Appliquer des techniques de quantification
- Implémenter l'élagage
- Mesurer les changements de taille du modèle et de vitesse d'inférence avant et après l'optimisation
À travers ce tutoriel, vous devriez avoir maîtrisé les fonctionnalités principales et les scénarios d'application des principaux frameworks d'apprentissage profond. Il est recommandé de commencer l'apprentissage de la programmation en apprentissage profond avec PyTorch, puis d'étendre à d'autres frameworks en fonction des besoins du projet une fois que vous avez une base solide. N'oubliez pas, les frameworks ne sont que des outils ; la véritable valeur réside dans les problèmes concrets que vous résolvez avec eux.
Autres extensions