Introduction au NLP
Le traitement du langage naturel (NLP)est un domaine interdisciplinaire combinant l'informatique, l'intelligence artificielle et la linguistique, qui vise à permettre aux ordinateurs de comprendre, traiter et générer le langage naturel humain.
Objectifs principaux :
- Compréhension: permettre aux ordinateurs de comprendre le sens du langage humain
- Traitement: analyser, transformer et manipuler du texte et de la parole
- Génération: permettre aux ordinateurs de produire un langage humain naturel et fluide
Caractéristiques du langage naturel
Le langage humain présente les caractéristiques uniques suivantes, qui font du NLP un domaine particulièrement difficile :
1. Ambigüité
- Ambigüité lexicale: un mot possède plusieurs sens
- Exemple : « bank » peut désigner une institution financière ou une rive de rivière
- Ambiguïté syntaxique: la structure grammaticale d'une phrase peut avoir plusieurs interprétations
- Exemple : « J'ai vu la personne avec le télescope » (est-ce que la personne tient le télescope, ou ai-je utilisé le télescope pour voir la personne ?)
- Ambiguïté sémantique: le sens global de la phrase n'est pas clair
- Exemple : « Ils ont acheté des pommes » (s'agit-il du fruit ou des produits d'Apple Inc. ?)
2. Dépendance au contexte
- Un même mot ou une même phrase a des significations différentes selon le contexte
- Exemple : « cool » dans « Cette idée est très cool » signifie génial, tandis que « Il fait frais aujourd'hui » signifie frais (température)
3. Innovation et variabilité
- La langue évolue constamment, avec de nouveaux mots et de nouvelles expressions qui apparaissent successivement
- Diffusion rapide de l'argot Internet et des expressions à la mode
- Exemple : de « Give力 » (geili/génial) à « yyds » (永farof神, signifiant « dieu éternel »)
4. Contexte culturel et social
- La langue porte de profondes connotations culturelles
- Une même langue présente des différences dialectales selon les régions
- Exemple : en chinois, « eatalready吗 ? » (« Avez-vous mangé ? ») n'est pas seulement une question, mais aussi une forme de salutation
5. Non-standardisation
- Expressions familières, abréviations, fautes de frappe
- Grammaire non standard, phrases incomplètes
- Exemple : expressions informelles dans Weibo et les historiques de discussion
Tâches principales du NLP
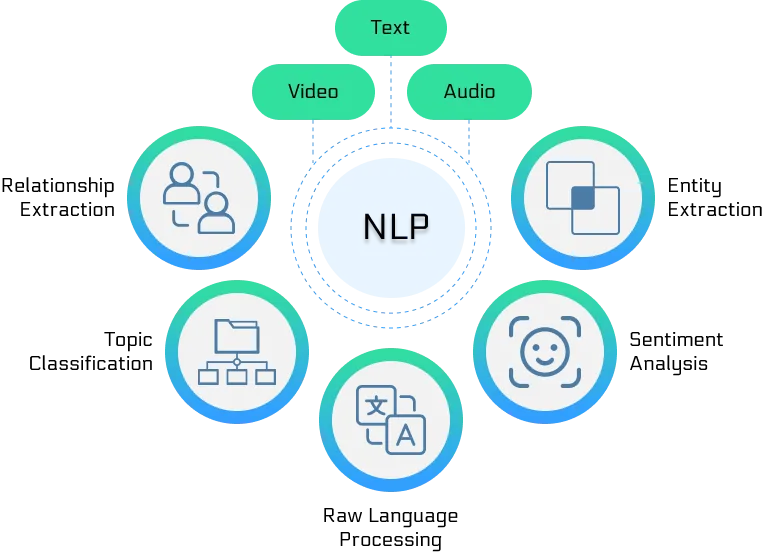
1. Tâches de base
- Tokenisation: découpage du texte en unités de sens
- Étiquetage morphosyntaxique (POS Tagging): identification de la catégorie grammaticale de chaque mot
- Analyse syntaxique (Parsing): analyse de la structure grammaticale des phrases
- Reconnaissance d'entités nommées (NER): identification des noms de personnes, des noms de lieux, des noms d'organisations, etc.
2. Tâches de compréhension
- Étiquetage des rôles sémantiques: identification des relations sémantiques dans les phrases
- Résolution de coréférence: détermination des différentes expressions dans un texte qui renvoient à la même entité
- Extraction de relations: identification des relations sémantiques entre entités
- Extraction d'événements: extraction d'informations sur les événements à partir de texte
3. Tâches d'application
- Classification de texte: catégorisation du texte en catégories prédéfinies
- Analyse de sentiment: détermination de la tendance sentimentale du texte
- Traduction automatique: traduction d'une langue à une autre
- Résumé automatique de texte: génération de résumés concis de texte
- Systèmes de réponse aux questions: récupération ou génération de réponses à partir de questions
L'histoire du développement du TALN
Phase 1 : L'ère des méthodes à base de règles (années 1950-1980)
Caractéristiques :
- Fondées sur des règles grammaticales et des bases de connaissances formulées manuellement
- Les méthodes de systèmes experts étaient dominantes
- Capacités de traitement limitées, mais de bonnes performances dans des domaines spécifiques
Travaux représentatifs :
- 1950- Le test de Turing a été proposé, posant les fondations de l'évaluation de l'intelligence des machines
- 1954- L'expérience Georgetown-IBM, la première tentative de traduction automatique
- 1960s- Le chatbot ELIZA, utilisant la technologie de correspondance de motifs
- 1970s- Le développement d'analyseurs syntaxiques, tels que ATN (Augmented Transition Network)
Systèmes typiques :
- SHRDLU(1970): compréhension et exécution de commandes en langage naturel dans le monde des blocs
- LUNAR(1972): répondre à des questions sur les roches lunaires
Limites :
- Couverture limitée des règles, ce qui rend difficile la gestion de la complexité du langage
- Coûts de maintenance élevés et faible évolutivité
- Incapable de bien gérer l'ambiguïté et les cas exceptionnels
Phase 2 : L'ère des méthodes statistiques (années 1980-2010)
Caractéristiques :
- Méthodes d'apprentissage statistique fondées sur des corpus à grande échelle
- Application généralisée des algorithmes d'apprentissage automatique
- Méthodologie fondée sur les données
Principaux développements technologiques :
Années 1980-1990 : L'essor des méthodes statistiques
- Modèles de Markov cachés (HMM): utilisés pour l'étiquetage morphosyntaxique et la reconnaissance vocale
- Grammaires hors-contexte probabilistes (PCFG): utilisées pour l'analyse syntaxique
- Traduction automatique statistique: fondée sur l'alignement des segments et des phrases
Années 2000 : la maturation des méthodes d'apprentissage automatique
- Machines à vecteurs de support (SVM): excellentes performances en classification de texte
- Champs aléatoires conditionnels (CRF): utilisés pour les tâches d'étiquetage de séquences
- Bayes naïf: une méthode de classification simple et efficace
- Modèles d'entropie maximale: gestion des problèmes multi-caractéristiques
Jalons importants :
- 1988- Le Brown Corpus a été publié, faisant progresser le développement du TAL statistique
- 1993- Le Penn Treebank a été publié, fournissant des données standard pour l'analyse syntaxique
- 2000- WordNet a été publié, fournissant un réseau sémantique lexical à grande échelle
- 2005- Google a publié un système de traduction automatique statistique
Avantages :
- Capable de traiter du texte du monde réel à grande échelle
- Possède un certain degré de capacité de généralisation
- Peut apprendre automatiquement des motifs à partir des données
Limites :
- Nécessite de grandes quantités de données annotées
- Charge de travail importante liée à l'ingénierie des caractéristiques
- Difficile de capturer des informations sémantiques profondes
Phase 3 : L'ère de l'apprentissage profond (années 2010-2020)
Caractéristiques :
- Le renouveau et le développement des modèles de réseaux de neurones
- Méthodes d'apprentissage de bout en bout
- Percées dans l'apprentissage de représentations
Principaux développements technologiques :
Début des années 2010 : Le renouveau des réseaux de neurones
- 2010- L'application des réseaux de neurones récurrents (RNN) à la modélisation du langage
- 2013- Word2Vec a été publié, une percée dans les représentations vectorielles de mots
- 2014- Modèles Sequence-to-Sequence, une révolution dans la traduction automatique
Milieu des années 2010 : le mécanisme d’attention
- 2015- La proposition et l’application du mécanisme d’attention
- 2016- La traduction automatique neuronale a atteint un niveau pratique
- 2017- L’architecture Transformer a été publiée, "Attention is All You Need"
Fin des années 2010 : modèles pré-entraînés
- 2018- BERT est sorti, une percée dans le pré-entraînement bidirectionnel
- 2019- GPT-2 est sorti, modèle génératif à grande échelle
- 2020- GPT-3 est sorti, démontrant des capacités linguistiques étonnantes
Percées clés :
- Technologie des vecteurs de mots:Word2Vec, GloVe, FastText
- Modèles de séquence: LSTM, GRU, RNN bidirectionnel
- Mécanisme d'attention: résout les problèmes de dépendance aux longues séquences
- Architecture Transformer: entraînement parallélisé, performances nettement améliorées
- Modèles pré-entraînés: BERT, série GPT, compréhension générale du langage
Phase 4 : L'ère des grands modèles de langage (années 2020 à aujourd'hui)
Caractéristiques :
- Croissance rapide de l'échelle des modèles
- L'aube de l'intelligence artificielle générale
- Capacités d'apprentissage few-shot et zero-shot
Principaux développements :
- 2020- GPT-3 (175 milliards de paramètres) a démontré de fortes capacités d'apprentissage few-shot
- 2021- PaLM (540 milliards de paramètres) a atteint de nouveaux sommets sur de multiples tâches
- 2022- ChatGPT est sorti, déclenchant un essor des applications d'IA
- 2023- Sortie de GPT-4, capacités multimodales nettement améliorées
- 2024 à aujourd'hui- Essor de concurrents tels que Claude et Gemini
Caractéristiques techniques :
- Effets d'échelle: le nombre de paramètres des modèles est passé de centaines de millions à des billions
- Capacités émergentes: les modèles manifestent des capacités inattendues après avoir atteint une certaine échelle
- Fusion multimodale: traitement unifié du texte, des images et de l'audio
- Suivi des instructions: améliorer la contrôlabilité des modèles via l'affinage sur instructions
Principaux domaines d'application du NLP

Traduction automatique
Historique du développement :
- Traduction automatique statistique (SMT): basée sur l'alignement de phrases et des modèles statistiques
- Traduction automatique neuronale (NMT): approches par réseaux de neurones de bout en bout
- Traduction par grands modèles: capacités de traduction démontrées par de grands modèles comme GPT-3/4
Défis techniques :
- Différences entre les paires de langues
- Compréhension et préservation du contexte
- Traduction de la terminologie dans des domaines spécialisés
- Style linguistique et adaptation culturelle
Exemples d'application :
- Google Translate, Baidu Translate
- Traduction vocale en temps réel
- Services de traduction de documents
- Recherche d'informations interlingues
Moteurs de recherche et recherche d'informations
Technologies clés :
- Compréhension de la requête: compréhension de l'intention de recherche de l'utilisateur
- Classement des documents: classement des résultats de recherche par pertinence
- Correspondance sémantique: calcul de similarité sémantique au-delà des mots-clés
- Recommandation personnalisée: basée sur l'historique et les préférences de l'utilisateur
Développement technologique:
- De la correspondance de mots-clés à la compréhension sémantique
- Du classement statique à la personnalisation dynamique
- De la recherche textuelle à la recherche multimodale
Systèmes représentatifs:
- Algorithme RankBrain dans Google Search
- ERNIE de Baidu appliqué à la recherche
- Recherche conversationnelle de Bing Chat
Service client intelligent et systèmes de dialogue
Types de systèmes :
- Orienté vers les tâches: accomplir des tâches spécifiques (réserver des billets, requêtes, etc.)
- Bavardage: mener une conversation ouverte
- Hybride: combiner l'accomplissement de tâches et les fonctions de bavardage
Technologies clés :
- Reconnaissance d'intention: comprendre la véritable intention de l'utilisateur
- Remplissage de créneaux: extraire les informations clés liées à la tâche
- Gestion du dialogue: contrôler le flux et l'état du dialogue
- Génération de réponses: générer des réponses naturelles et pertinentes
Scénarios d'application :
- Service client intelligent dans les secteurs bancaire et du commerce électronique
- Enceintes connectées (Alexa, Siri)
- Chatbots
- Assistants virtuels
Analyse de texte et analyse des sentiments
Tâches d'analyse de texte :
- Classification thématique: classer des documents en catégories thématiques
- Extraction de mots-clés: identifier le vocabulaire essentiel des documents
- Regroupement de textes: regrouper des documents similaires
- Analyse des tendances: analyser les évolutions temporelles du contenu textuel
Niveaux d'analyse des sentiments :
- Niveau document: sentiment global d'un document entier
- Niveau phrase: orientation sentimentale de chaque phrase
- Niveau aspect: sentiment envers des aspects spécifiques
- À grain fin: intensité et complexité du sentiment
Applications métier :
- Veille des médias sociaux
- Analyse des avis produits
- Gestion de la réputation de marque
- Indicateurs de sentiment du marché boursier
Extraction d'informations
Tâches d'extraction :
- Reconnaissance d'entités nommées: noms de personnes, noms de lieux, noms d'organisations, etc.
- Extraction de relations: relations sémantiques entre entités
- Extraction d'événements: participants, temps, lieu, etc. des événements
- Extraction d'attributs: attributs caractéristiques des entités
Approches techniques :
- Correspondance de motifs à base de règles
- Méthodes d'apprentissage supervisé
- Supervision distante et supervision faible
- Réglage fin des modèles pré-entraînés
Valeur applicative :
- Construction de graphes de connaissances
- Systèmes intelligents de question-réponse
- Surveillance des événements d'actualité
- Analyse des risques financiers
Résumé automatique
Types de résumé :
- Résumé extractif: sélection des phrases importantes du texte original
- Résumé abstractif: génération d'un nouveau texte de résumé
- Résumé hybride: combinaison de méthodes extractives et génératives
Défis techniques :
- Identification des informations importantes
- Cohérence et lisibilité des résumés
- Cohérence dans le résumé multi-documents
- Contrôle de la longueur du résumé
Scénarios d'application :
- Résumé d'actualités
- Résumés d'articles académiques
- Résumé de documents juridiques
- Génération de comptes rendus de réunion
Principaux défis du TAL
Ambiguïté du langage
Ambiguïté lexicale
- Polysémie:
- "打" (dǎ) : frapper, acheter, allumer, etc.
- "行" (xíng/háng) : d'accord / banque / marcher, etc.
- Homophones:
- Chinois : usage de "的, 地, 得"
- Anglais : "there, their, they're"
Ambiguïté syntaxique
- Relations de modification peu claires:
- "美丽of花儿of香味" (La fleur est-elle belle ou le parfum est-il beau ?)
- Analyses structurelles multiples:
- J'ai vu la fille tenant un parapluie
Ambiguïté sémantique
- Référence peu claire:
- "Li Ming a dit à Zhang Hua qu'il était très intelligent" (Qui est intelligent ?)
- Ambiguïté de portée:
- Tous les étudiants n'aiment pas ce professeur
Solutions :
- Utilisation des informations contextuelles
- Jugement probabiliste des modèles de langue
- Assistance des bases de connaissances
- Apprentissage multi-tâches
Compréhension du contexte
Contexte local
- Dépendances sémantiques au sein d'une phrase
- Compréhension des syntagmes et des propositions
- Relations sémantiques entre les mots
Contexte global
- Cohérence sémantique au niveau du paragraphe et du document
- Continuité thématique
- Dépendances sémantiques à longue distance
Contexte de dialogue
- Informations historiques dans un dialogue multi-tours
- Raisonnement sur les informations implicites
- Évolution de l'intention du dialogue
Défis techniques :
- Dépendances à longue distanceLes RNN traditionnels ont du mal à gérer les longues séquences
- Cohérence sémantiqueMaintenir la cohérence logique dans le texte généré
- Raisonnement de sens communNécessite de vastes connaissances de base
Solutions :
- Mécanismes d'attention et Transformers
- Modèles de langage pré-entraînés
- Modèles enrichis par les connaissances
- Fusion d'informations multimodales
Différences culturelles et linguistiques
Défis translinguistiques
- Différences entre familles de langues:
- Sino-tibétain vs indo-européen
- Morphologie riche vs importance de l'ordre des mots
- Différences de systèmes d'écriture:
- Différentes tailles de jeux de caractères
- Différentes méthodes de tokenisation
Contexte culturel
- Expressions idiomatiques et familières:
- « Peindre un serpent avec des pattes » vs « ne pas vendre la peau de l'ours avant de l'avoir tué »
- Expressions propres à une culture:
- Le concept chinois de « face » (mianzi)
- Système honorifique japonais
Facteurs sociolinguistiques
- Différences dialectales:
- Mandarin vs divers dialectes régionaux
- Anglais standard vs anglais dialectal
- Variation de registre:
- Styles de langue formelle et informelle
- Langue parlée et langue écrite
Stratégies de résolution :
- Modèles pré-entraînés multilingues
- Apprentissage par transfert interlingue
- Adaptation culturelle
- Collecte de données localisées
Problèmes de rareté des données
Langues à faibles ressources
- Il existe plus de 7,000 langues dans le monde, mais seules quelques-unes disposent de ressources numériques abondantes
- Préservation et recherche sur les langues menacées
- Dialectes et langues minoritaires
Domaines professionnels
- Terminologie dans des domaines spécialisés tels que la médecine et le droit
- Expressions propres au secteur
- Difficulté à obtenir des données annotées
Domaines émergents
- Nouveau vocabulaire généré par les nouvelles technologies
- Nouvelles expressions sur les réseaux sociaux
- Nouvelles formes de communication interculturelle
Évolution au fil du temps
- Changements historiques de la langue
- Émergence rapide de nouveaux mots
- Glissements sémantiques progressifs
Solutions :
- Apprentissage par transfert: Transfert de langues riches en ressources vers des langues pauvres en ressources
- Augmentation des données: Élargir les données d'entraînement grâce à diverses techniques
- Apprentissage à quelques exemples: Adaptation rapide avec un petit nombre d'échantillons
- Apprentissage non supervisé et auto-supervisé: Réduire la dépendance aux données annotées
- Annotation participative: Utiliser l'intelligence collective pour collecter des données
- Données synthétiques: Générer des données d'entraînement par des règles ou des modèles
Complexité computationnelle
Défis liés à l'échelle des modèles
- Croissance explosive du nombre de paramètres (GPT-3: 175 milliards de paramètres)
- Coûts d'entraînement en forte hausse
- Latence d'inférence et consommation de ressources
Exigences temps réel
- Réponses à l'échelle de la milliseconde pour les moteurs de recherche
- Interaction en temps réel dans les systèmes de dialogue
- Contraintes de ressources sur les appareils mobiles
Problèmes d'évolutivité
- Gestion de requêtes utilisateur massives
- Traitement unifié de plusieurs langues et tâches
- Exigences computationnelles des services personnalisés
Défis d'évaluation et de quantification
Problèmes de subjectivité
- Jugement subjectif de la qualité du texte
- Différences culturelles dans la qualité de la traduction
- Critères d'évaluation pour l'écriture créative
Limites des métriques d'évaluation
- Imperfections des métriques telles que BLEU et ROUGE
- Différences entre l'évaluation automatique et l'évaluation humaine
- Complexité de l'évaluation multidimensionnelle
Jeux de données de référence
- Représentativité des jeux de données
- Écart entre les tâches d'évaluation et les applications du monde réel
- Actualité et mises à jour des jeux de données
Résumé et perspectives
Le traitement du langage naturel, en tant que branche centrale de l'intelligence artificielle, a connu un processus de développement allant de l'approche guidée par les règles à l'approche guidée par les données, puis à celle menée par les grands modèles. Chaque étape possède ses caractéristiques techniques uniques et ses contributions historiques.
État actuel :
- Les grands modèles de langage démontrent des capacités étonnantes de compréhension et de génération du langage
- La fusion multimodale devient une nouvelle direction de développement
- Les domaines d'application continuent de s'élargir et la valeur commerciale est de plus en plus marquée
Tendances futures :
- Intelligence artificielle générale: Vers des systèmes d'IA plus généraux et plus intelligents
- Fusion multimodale: Intégration complète du texte, de la vision et de l'audio
- Services personnalisés: Compréhension et génération linguistiques personnalisées plus précises
- Explicabilité: Améliorer la transparence des processus de prise de décision des modèles
- Optimisation de l'efficacité: Réduire les coûts de calcul tout en maintenant les performances
- Éthique et sécurité: Garantir l'équité, la sécurité et la contrôlabilité des systèmes d'IA
Suggestions d'apprentissage :
Pour les apprenants en NLP, il est recommandé de :
- Bases solides: Comprendre en profondeur les fondamentaux de la linguistique et de l'informatique
- Orienté vers la pratique: Approfondir la compréhension grâce à des projets pratiques
- Suivre les frontières: Prêter attention aux derniers développements technologiques et tendances de la recherche
- Pensée interdisciplinaire: Combiner les connaissances issues de la linguistique, de la psychologie, de la sociologie et d'autres disciplines
- Capacité d'ingénierie: Cultiver la capacité à traduire les résultats de la recherche en applications pratiques
L'avenir du traitement du langage naturel est plein d'opportunités et de défis. Avec les progrès technologiques continus, nous avons des raisons de croire que la capacité des machines à comprendre et à générer le langage humain continuera de s'améliorer, apportant plus de commodité et de valeur à la société humaine.
Extensions supplémentaires