Outils de traitement des données
Le traitement du langage naturel (NLP) est une branche importante de l'intelligence artificielle, et le traitement des données est la clé du succès des projets NLP.
Cet article présentera systématiquement l'ensemble d'outils essentiels pour l'ensemble du flux de travail de traitement des données NLP, couvrant des étapes clés telles que le nettoyage des données, le calcul numérique, l'ingénierie des fonctionnalités, l'apprentissage automatique et la visualisation.
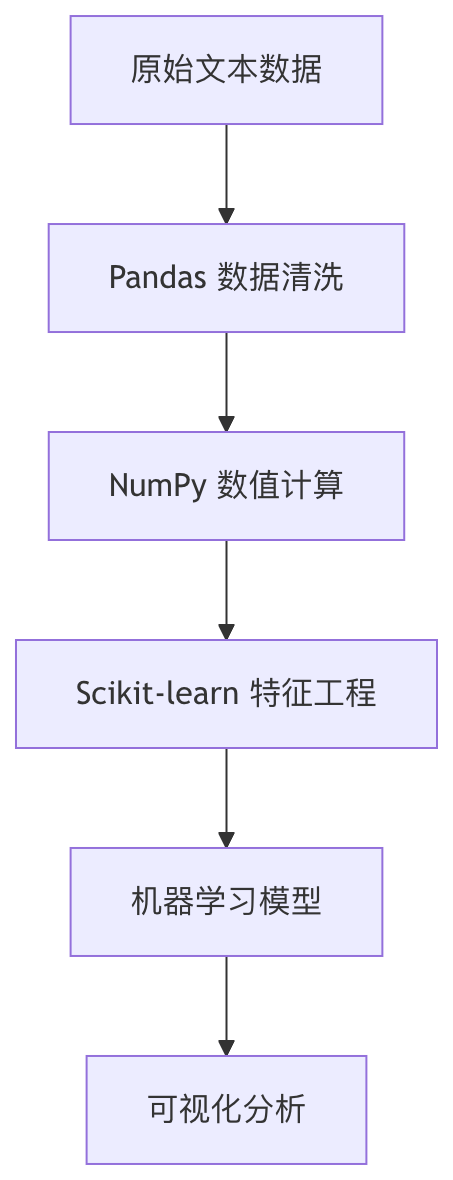
Pandas : nettoyage et prétraitement des données
Structures de données principales de Pandas
Pandas fournit deux structures de données principales, qui sont la pierre angulaire du traitement des données NLP :
| Structure de données | Fonctionnalités | Scénarios d'application du NLP |
|---|---|---|
| Séries | Tableau étiqueté unidimensionnel | Stocker une seule colonne de caractéristiques textuelles |
| DataFrame | Structure tabulaire bidimensionnelle | Stocker l’ensemble du jeu de données textuelles |
Opérations courantes de traitement du texte
Exemple
# Créer des données d'exemple
data = {'text': ['Hello World!', 'NLP is amazing', 'Python 3.8'],
'label': [1, 0, 1]}
df = pd.DataFrame(data)
# 1. Nettoyage du texte
df['clean_text'] = df['text'].str.lower() # Convertir en minuscules
df['clean_text'] = df['clean_text'].str.replace('[^\w\s]', '') # Supprimer la ponctuation
# 2. Tokenisation
df['tokens'] = df['clean_text'].str.split() # Tokeniser par espaces
# 3. Comptage des fréquences des mots
word_counts = df['tokens'].explode().value_counts()
print(word_counts)
Techniques avancées de traitement des textes
- Filtrage par expressions régulières:
df['text'].str.contains(r'\bNLP\b') - Suppression des mots vides: utilisation des bibliothèques NLTK ou spaCy
- Gestion des valeurs manquantes:
df.dropna()oudf.fillna('UNK')
NumPy : calcul numérique efficace
Fonctions principales
NumPy offre des capacités de calcul numérique efficaces pour le NLP:
- Tableaux multidimensionnels: stocker les vecteurs de mots et les matrices de plongement
- Mécanisme de diffusion: effectuer efficacement des opérations élément par élément
- Algèbre linéaire: décomposition matricielle, calcul de similarité
Exemples d'application typiques
Exemple
# Créer une matrice de vecteurs de mots (3 mots, chacun de dimension 5)
word_vectors = np.array([
[0.1, 0.2, 0.3, 0.4, 0.5], # Mot 1
[0.6, 0.7, 0.8, 0.9, 1.0], # Mot 2
[1.1, 1.2, 1.3, 1.4, 1.5] # Mot 3
])
# Calculer la similarité cosinus
def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * (np.linalg.norm(b))
# Calculer la similarité des deux premiers mots
sim = cosine_similarity(word_vectors[0], word_vectors[1])
print(f"Similarité: {sim:.2f}")
Conseils d'optimisation des performances
- Utiliser
np.vectorizepour remplacer les boucles Python - Tirez parti
np.save/np.loadpour un stockage efficace de grandes matrices - Maîtrisez
np.einsumpour des opérations tensorielles complexes
Scikit-learn : Pipeline d'apprentissage automatique
Extraction de caractéristiques NLP
Exemple
corpus = [
'Ceci est le premier document.',
'Ce document est le deuxième document.',
'Et ceci est le troisième.'
]
# Créer un vectoriseur TF-IDF
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(corpus)
print(f"Forme de la matrice de caractéristiques : {X.shape}")
print(f"Vocabulaire des caractéristiques : {vectorizer.get_feature_names_out()}")
Exemple complet de pipeline NLP
Exemple
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Créer un pipeline
nlp_pipeline = Pipeline([
('tfidf', TfidfVectorizer(max_features=1000)),
('clf', RandomForestClassifier(n_estimators=100))
])
# Préparer des données d'exemple
texts = ["bon film", "mauvais film", "excellente histoire"] * 100
labels = [1, 0, 1] * 100
# Séparation entraînement-test
X_train, X_test, y_train, y_test = train_test_split(texts, labels)
# Entraîner le modèle
nlp_pipeline.fit(X_train, y_train)
# Évaluer
print(f"Précision du test : {nlp_pipeline.score(X_test, y_test):.2f}")
Composants NLP courants
| Catégorie de composant | Classes principales | Description |
|---|---|---|
| Extraction de caractéristiques | CountVectorizer | Modèle de sac de mots |
| TfidfVectorizer | Pondération TF-IDF | |
| Prétraitement de texte | HashingVectorizer | Extraction de caractéristiques économe en mémoire |
| Réduction de dimensionnalité | TruncatedSVD | Analyse sémantique latente |
Outils de visualisation
Visualisation de base avec Matplotlib
Exemple
# Exemple de visualisation de fréquence des mots
words = ['nlp', 'python', 'learning']
frequencies = [25, 40, 35]
plt.figure(figsize=(8, 4))
plt.bar(words, frequencies, color=['#3498db', '#2E7DCC', '#e74c3c'])
plt.title('Distribution de fréquence des termes NLP')
plt.xlabel('Termes')
plt.ylabel('Fréquence')
plt.show()
Bibliothèques de visualisation avancées
Seaborn: des graphiques statistiques simplifiés
Exemple
sns.heatmap(tfidf_matrix, annot=True)
WordCloud: générer des nuages de mots
Exemple
wordcloud = WordCloud().generate(' '.join(textes))
plt.imshow(wordcloud)
Plotly: visualisation interactive
Exemple
fig = px.scatter_3d(embeddings, x=0, y=1, z=2)
fig.show()
Projet pratique complet
Workflow complet d'analyse de sentiments
Exemple
df = pd.read_csv('reviews.csv')
# 2. Nettoyage des données
df['clean_text'] = df['text'].str.lower().str.replace('[^\w\s]', '')
# 3. Ingénierie des caractéristiques
vectorizer = TfidfVectorizer(max_features=5000)
X = vectorizer.fit_transform(df['clean_text'])
y = df['sentiment']
# 4. Entraînement du modèle
from sklearn.svm import LinearSVC
model = LinearSVC()
model.fit(X, y)
# 5. Visualisation
import seaborn as sns
from sklearn.metrics import confusion_matrix
y_pred = model.predict(X)
cm = confusion_matrix(y, y_pred)
sns.heatmap(cm, annot=True, fmt='d')
Conseils d'optimisation des performances
- Traitement parallèle: utiliser
n_jobsparamètre - Sélection de caractéristiques:
SelectKBestréduire la dimensionnalité - Mise en cache du pipeline:
memoryLe paramètre met en cache les résultats intermédiaires
Extensions de chaîne d'outils recommandées
- NLTK: boîte à outils NLP classique
- spaCy: traitement NLP de qualité industrielle
- Gensim: modélisation thématique et vecteurs de mots
- HuggingFace Transformers: modèles pré-entraînés
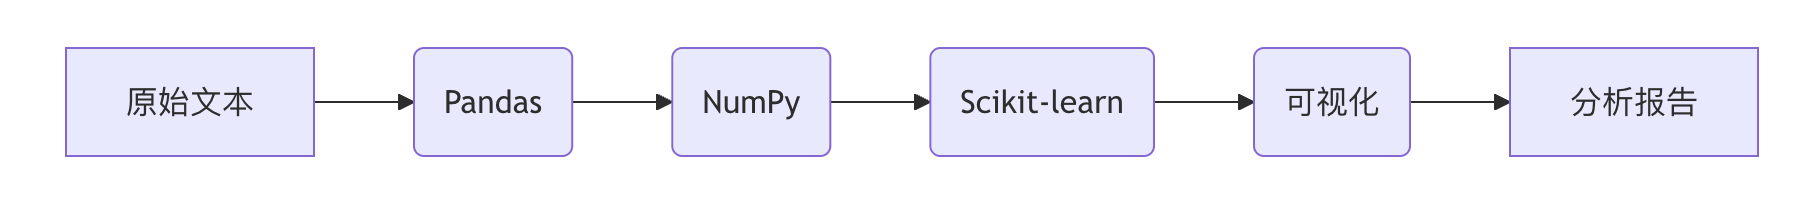
En maîtrisant l'utilisation combinée de ces outils, vous serez en mesure de traiter efficacement la plupart des tâches de traitement des données NLP et de poser une base solide pour des applications NLP plus avancées.
Autres extensions