Datenverarbeitungstools
Die Verarbeitung natürlicher Sprache (NLP) ist ein wichtiger Zweig der künstlichen Intelligenz, und die Datenverarbeitung ist der Schlüssel zum Erfolg von NLP-Projekten.
Dieser Artikel führt systematisch in das unverzichtbare Toolset für den gesamten NLP-Datenverarbeitungs-Workflow ein und behandelt Kernphasen wie Datenbereinigung, numerische Berechnung, Feature Engineering, maschinelles Lernen und Visualisierung.
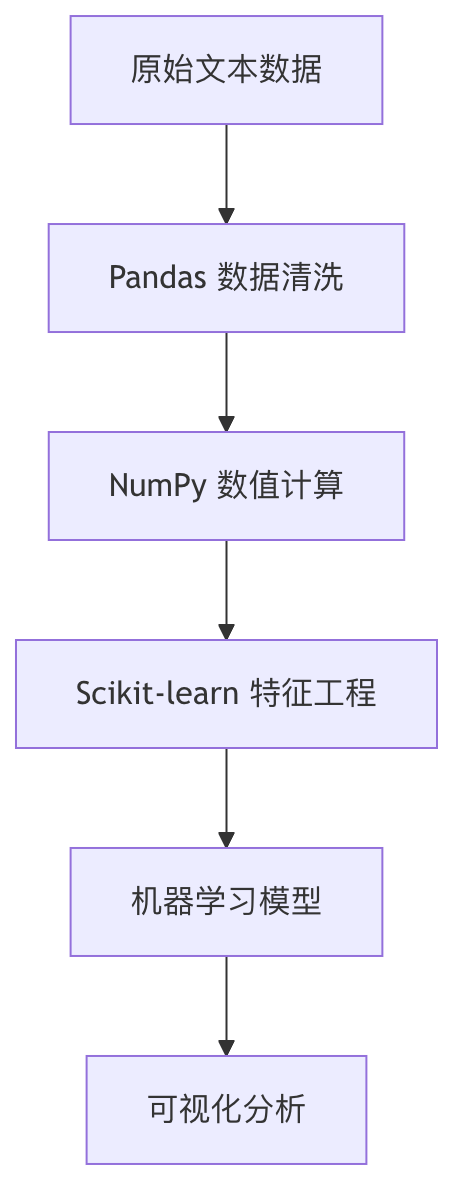
Pandas: Datenbereinigung und Vorverarbeitung
Pandas-Kerndatenstrukturen
Pandas bietet zwei Hauptdatenstrukturen, die den Grundpfeiler der NLP-Datenverarbeitung bilden:
| Datenstruktur | Funktionen | NLP-Anwendungsszenarien |
|---|---|---|
| Serie | Eindimensionales beschriftetes Array | Eine einzelne Textmerkmalsspalte speichern |
| DataFrame | Zweidimensionale tabellarische Struktur | Den gesamten Textdatensatz speichern |
Häufige Textverarbeitungsoperationen
Beispiel
# Beispieldaten erstellen
data = {'text': ['Hello World!', 'NLP is amazing', 'Python 3.8'],
'label': [1, 0, 1]}
df = pd.DataFrame(data)
# 1. Textbereinigung
df['clean_text'] = df['text'].str.lower() # In Kleinbuchstaben umwandeln
df['clean_text'] = df['clean_text'].str.replace('[^\w\s]', '') # Satzzeichen entfernen
# 2. Tokenisierung
df['tokens'] = df['clean_text'].str.split() # Tokenisierung nach Leerzeichen
# 3. Zählung der Worthäufigkeiten
word_counts = df['tokens'].explode().value_counts()
print(word_counts)
Fortgeschrittene Techniken der Textverarbeitung
- Filterung mit regulären Ausdrücken:
df['text'].str.contains(r'\bNLP\b') - Stoppwortentfernung: Verwendung von NLTK- oder spaCy-Bibliotheken
- Umgang mit fehlenden Werten:
df.dropna()oderdf.fillna('UNK')
NumPy: Effiziente numerische Berechnung
Kernfunktionen
NumPy bietet effiziente numerische Berechnungsfunktionen für NLP:
- Mehrdimensionale Arrays: Wortvektoren und Embedding-Matrizen speichern
- Broadcasting-Mechanismus: elementweise Operationen effizient ausführen
- Lineare Algebra: Matrixzerlegung, Ähnlichkeitsberechnung
Typische Anwendungsbeispiele
Beispiel
# Wortvektormatrix erstellen (3 Wörter, jeweils 5-dimensional)
word_vectors = np.array([
[0.1, 0.2, 0.3, 0.4, 0.5], # Wort 1
[0.6, 0.7, 0.8, 0.9, 1.0], # Wort 2
[1.1, 1.2, 1.3, 1.4, 1.5] # Wort 3
])
# Kosinusähnlichkeit berechnen
def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * (np.linalg.norm(b))
# Ähnlichkeit der ersten beiden Wörter berechnen
sim = cosine_similarity(word_vectors[0], word_vectors[1])
print(f"Ähnlichkeit: {sim:.2f}")
Tipps zur Leistungsoptimierung
- Verwenden Sie
np.vectorizeum Python-Schleifen zu ersetzen - Nutzen
np.save/np.loadfür die effiziente Speicherung großer Matrizen - Meistern
np.einsumfür komplexe Tensoroperationen
Scikit-learn: Machine-Learning-Pipeline
NLP-Merkmalsextraktion
Beispiel
Korpus = [
'Dies ist das erste Dokument.',
'Dieses Dokument ist das zweite Dokument.',
'Und dies ist das dritte.'
]
# TF-IDF-Vektorisierer erstellen
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(corpus)
print(f"Form der Feature-Matrix: {X.shape}")
print(f"Feature-Vokabular: {vectorizer.get_feature_names_out()}")
Vollständiges NLP-Pipeline-Beispiel
Beispiel
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Pipeline erstellen
nlp_pipeline = Pipeline([
('tfidf', TfidfVectorizer(max_features=1000)),
('clf', RandomForestClassifier(n_estimators=100))
])
# Beispieldaten vorbereiten
texts = ["guter Film", "schlechter Film", "großartige Geschichte"] * 100
labels = [1, 0, 1] * 100
# Train-Test-Aufteilung
X_train, X_test, y_train, y_test = train_test_split(texts, labels)
# Modell trainieren
nlp_pipeline.fit(X_train, y_train)
# Auswerten
print(f"Testgenauigkeit: {nlp_pipeline.score(X_test, y_test):.2f}")
Gängige NLP-Komponenten
| Komponentenkategorie | Hauptklassen | Beschreibung |
|---|---|---|
| Merkmalsextraktion | CountVectorizer | Bag-of-Words-Modell |
| TfidfVectorizer | TF-IDF-Gewichtung | |
| Textvorverarbeitung | HashingVectorizer | Speicherfreundliche Merkmalsextraktion |
| Dimensionsreduktion | TruncatedSVD | Latente semantische Analyse |
Visualisierungstools
Matplotlib Basisvisualisierung
Beispiel
# Beispiel für Wortfrequenzvisualisierung
words = ['nlp', 'python', 'learning']
frequencies = [25, 40, 35]
plt.figure(figsize=(8, 4))
plt.bar(words, frequencies, color=['#3498db', '#2E7DCC', '#e74c3c'])
plt.title('NLP-Termfrequenzverteilung')
plt.xlabel('Begriffe')
plt.ylabel('Häufigkeit')
plt.show()
Fortgeschrittene Visualisierungsbibliotheken
Seaborn: statistische Grafiken leicht gemacht
Beispiel
sns.heatmap(tfidf_matrix, annot=True)
WordCloud: Wortwolken generieren
Beispiel
wordcloud = WordCloud().generate(' '.join(texts))
plt.imshow(wordcloud)
Plotly: interaktive Visualisierung
Beispiel
fig = px.scatter_3d(embeddings, x=0, y=1, z=2)
fig.show()
Umfassendes Übungsprojekt
Vollständiger Workflow zur Sentimentanalyse
Beispiel
df = pd.read_csv('reviews.csv')
# 2. Datenbereinigung
df['clean_text'] = df['text'].str.lower().str.replace('[^\w\s]', '')
# 3. Feature-Engineering
vectorizer = TfidfVectorizer(max_features=5000)
X = vectorizer.fit_transform(df['clean_text'])
y = df['sentiment']
# 4. Modelltraining
from sklearn.svm import LinearSVC
model = LinearSVC()
model.fit(X, y)
# 5. Visualisierung
import seaborn as sns
from sklearn.metrics import confusion_matrix
y_pred = model.predict(X)
cm = confusion_matrix(y, y_pred)
sns.heatmap(cm, annot=True, fmt='d')
Tipps zur Leistungsoptimierung
- Parallele Verarbeitung: verwenden
n_jobsParameter - Merkmalsauswahl:
SelectKBestDimensionalität reduzieren - Pipeline-Caching:
memoryParameter zwischenspeichert Zwischenergebnisse
Empfohlene Toolchain-Erweiterungen
- NLTK: klassisches NLP-Toolkit
- spaCy: industrielle NLP-Verarbeitung
- Gensim: Themenmodellierung und Wortvektoren
- HuggingFace Transformers: vortrainierte Modelle
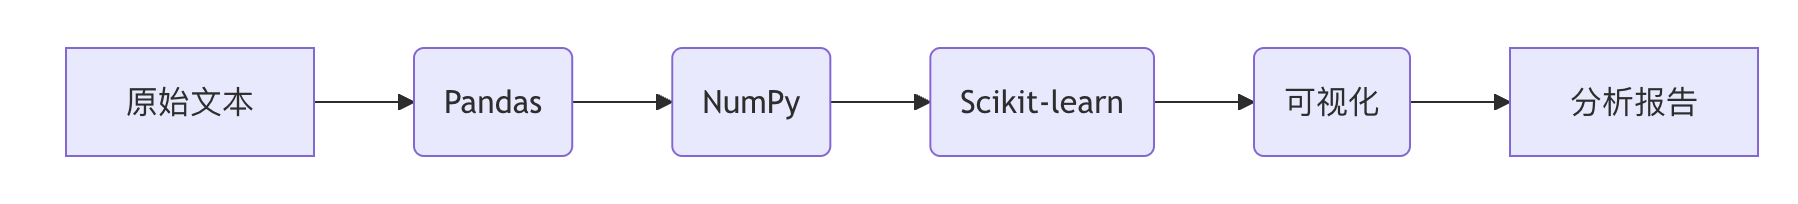
Wenn Sie die kombinierte Nutzung dieser Tools beherrschen, können Sie die meisten NLP-Datenverarbeitungsaufgaben effizient bewältigen und eine solide Grundlage für fortgeschrittenere NLP-Anwendungen legen.
Andere Erweiterungen