Herramientas de procesamiento de datos
El procesamiento del lenguaje natural (NLP) es una rama importante de la inteligencia artificial, y el procesamiento de datos es la clave del éxito de los proyectos de NLP.
Este artículo presentará sistemáticamente el conjunto de herramientas imprescindibles en todo el flujo de procesamiento de datos de NLP, que abarca los enlaces principales como limpieza de datos, cálculo numérico, ingeniería de características, aprendizaje automático y visualización.
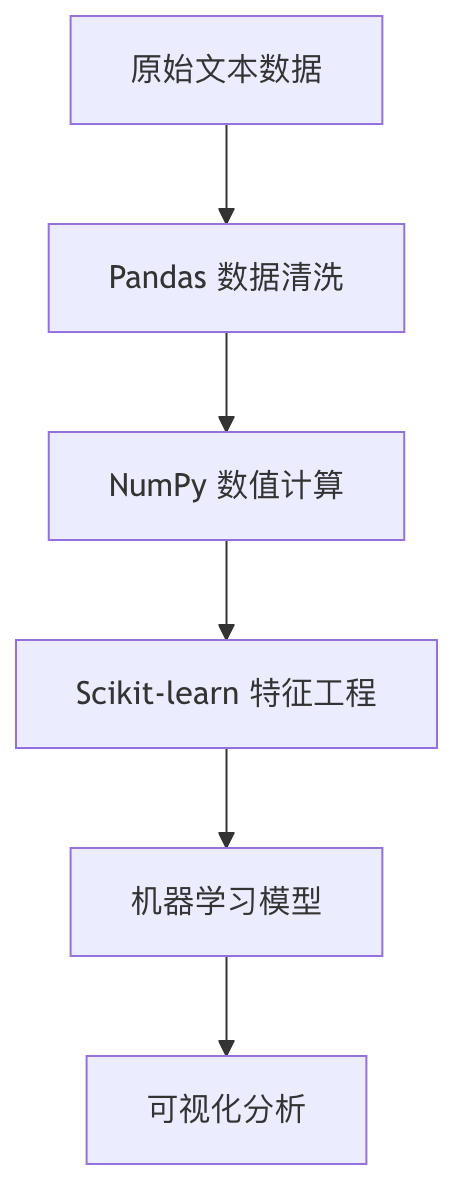
Pandas: limpieza y preprocesamiento de datos
Estructuras de datos principales de Pandas
Pandas proporciona dos estructuras de datos principales, que son la base del procesamiento de datos de NLP:
| Estructura de datos | Características | Escenarios de aplicación de NLP |
|---|---|---|
| Series | Arreglo unidimensional etiquetado | Almacenar una columna de características de texto individual |
| DataFrame | Estructura de tabla bidimensional | Almacenar todo el conjunto de datos de texto |
Operaciones comunes de procesamiento de texto
Ejemplo
# Crear datos de ejemplo
data = {'text': ['Hello World!', 'NLP is amazing', 'Python 3.8'],
'label': [1, 0, 1]}
df = pd.DataFrame(data)
# 1. Limpieza de texto
df['clean_text'] = df['text'].str.lower() # Convertir a minúsculas
df['clean_text'] = df['clean_text'].str.replace('[^\w\s]', '') # Eliminar puntuación
# 2. Segmentación de palabras
df['tokens'] = df['clean_text'].str.split() # Segmentar por espacios
# 3. Conteo de frecuencia de palabras
word_counts = df['tokens'].explode().value_counts()
print(word_counts)
Técnicas avanzadas de procesamiento de texto
- Filtrado con expresiones regulares:
df['text'].str.contains(r'\bNLP\b') - Eliminación de palabras vacías (stopwords): combinando las bibliotecas NLTK o spaCy
- Manejo de valores faltantes:
df.dropna()odf.fillna('UNK')
NumPy: cálculo numérico eficiente
Funciones principales
NumPy proporciona capacidades de cálculo numérico eficientes para NLP:
- Arreglos multidimensionales: almacenar vectores de palabras, matrices de embedding
- Mecanismo de difusión (broadcasting): ejecutar operaciones a nivel de elementos de manera eficiente
- Álgebra lineal: descomposición de matrices, cálculo de similitud
Ejemplos de aplicaciones típicas
Ejemplo
# Crear matriz de vectores de palabras (3 palabras, cada una de 5 dimensiones)
word_vectors = np.array([
[0.1, 0.2, 0.3, 0.4, 0.5], # Palabra 1
[0.6, 0.7, 0.8, 0.9, 1.0], # Palabra 2
[1.1, 1.2, 1.3, 1.4, 1.5] # Palabra 3
])
# Calcular similitud de coseno
def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * (np.linalg.norm(b))
# Calcular la similitud de las dos primeras palabras
sim = cosine_similarity(word_vectors[0], word_vectors[1])
print(f"Similitud: {sim:.2f}")
Técnicas de optimización del rendimiento
- Usar
np.vectorizepara reemplazar bucles de Python - Utilizar
np.save/np.loadpara almacenar eficientemente matrices grandes - Dominar
np.einsumpara realizar operaciones complejas con tensores
Scikit-learn: pipeline de aprendizaje automático
Extracción de características NLP
Ejemplo
corpus = [
'This is the first document.',
'This document is the second document.',
'And this is the third one.'
]
# Crear vectorizador TF-IDF
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(corpus)
print(f"Forma de la matriz de características: {X.shape}")
print(f"Vocabulario de características: {vectorizer.get_feature_names_out()}")
Ejemplo completo de pipeline NLP
Ejemplo
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Crear pipeline
nlp_pipeline = Pipeline([
('tfidf', TfidfVectorizer(max_features=1000)),
('clf', RandomForestClassifier(n_estimators=100))
])
# Preparación de datos de ejemplo
texts = ["good movie", "bad film", "great story"] * 100
labels = [1, 0, 1] * 100
# División entrenamiento-prueba
X_train, X_test, y_train, y_test = train_test_split(texts, labels)
# Entrenar modelo
nlp_pipeline.fit(X_train, y_train)
# Evaluación
print(f"Precisión de prueba: {nlp_pipeline.score(X_test, y_test):.2f}")
Componentes NLP comunes
| Categoría de componente | Clases principales | Descripción de funciones |
|---|---|---|
| Extracción de características | CountVectorizer | Modelo de bolsa de palabras (Bag of Words) |
| TfidfVectorizer | Ponderación TF-IDF | |
| Preprocesamiento de texto | HashingVectorizer | Extracción de características eficiente en memoria |
| Reducción de dimensionalidad | TruncatedSVD | Análisis semántico latente |
Herramientas de visualización
Visualización básica con Matplotlib
Ejemplo
# Ejemplo de visualización de frecuencia de palabras
words = ['nlp', 'python', 'learning']
frequencies = [25, 40, 35]
plt.figure(figsize=(8, 4))
plt.bar(words, frequencies, color=['#3498db', '#2E7DCC', '#e74c3c'])
plt.title('Distribución de frecuencia de términos NLP')
plt.xlabel('Términos')
plt.ylabel('Número de apariciones')
plt.show()
Bibliotecas de visualización avanzadas
Seaborn: gráficos estadísticos más simples
Ejemplo
sns.heatmap(tfidf_matrix, annot=True)
WordCloud: generar nube de palabras
Ejemplo
wordcloud = WordCloud().generate(' '.join(texts))
plt.imshow(wordcloud)
Plotly: visualización interactiva
Ejemplo
fig = px.scatter_3d(embeddings, x=0, y=1, z=2)
fig.show()
Proyecto práctico integral
Flujo completo de análisis de sentimientos
Ejemplo
df = pd.read_csv('reviews.csv')
# 2. Limpieza de datos
df['clean_text'] = df['text'].str.lower().str.replace('[^\w\s]', '')
# 3. Ingeniería de características
vectorizer = TfidfVectorizer(max_features=5000)
X = vectorizer.fit_transform(df['clean_text'])
y = df['sentiment']
# 4. Entrenamiento del modelo
from sklearn.svm import LinearSVC
model = LinearSVC()
model.fit(X, y)
# 5. Visualización
import seaborn as sns
from sklearn.metrics import confusion_matrix
y_pred = model.predict(X)
cm = confusion_matrix(y, y_pred)
sns.heatmap(cm, annot=True, fmt='d')
Técnicas de optimización del rendimiento
- Procesamiento paralelo: usar el
n_jobsparámetro - Selección de características:
SelectKBestpara reducir la dimensionalidad - Caché del pipeline:
memoryel parámetro almacena en caché los resultados intermedios
Recomendaciones de extensiones del conjunto de herramientas
- NLTK: kit de herramientas NLP clásico
- spaCy: procesamiento NLP de nivel industrial
- Gensim: modelado de temas y vectores de palabras
- HuggingFace Transformers: modelos preentrenados
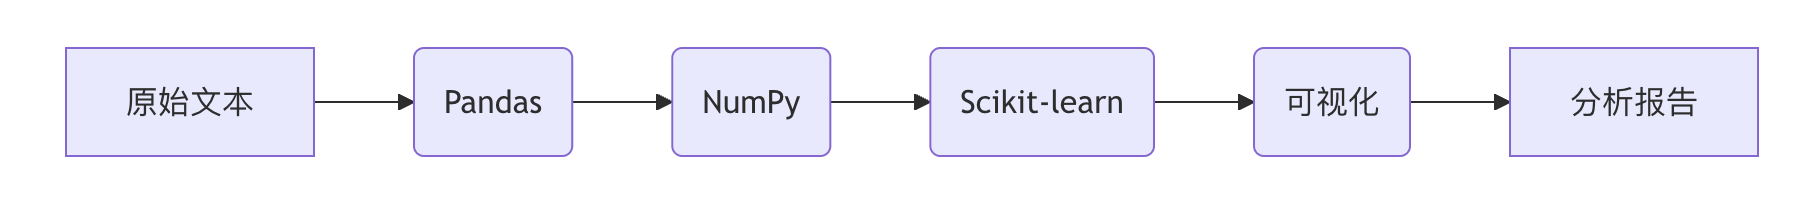
Al dominar el uso combinado de estas herramientas, podrá manejar eficientemente la mayoría de las tareas de procesamiento de datos de NLP, sentando una base sólida para aplicaciones de NLP más avanzadas.
Otras extensiones