Conversión y optimización de modelos TensorFlow
En el desarrollo de proyectos de aprendizaje automático, la conversión y optimización de modelos son pasos importantes antes de la implementación.
TensorFlow proporciona múltiples herramientas y técnicas para ayudar a los desarrolladores a convertir los modelos entrenados a formatos adecuados para diferentes entornos de implementación, y optimizarlos para mejorar el rendimiento.
¿Por qué se necesitan la conversión y optimización de modelos?
- Requisitos de implementación: Los modelos entrenados deben adaptarse a diferentes plataformas (dispositivos móviles, dispositivos embebidos, servidores, etc.)
- Mejora del rendimiento: La optimización puede reducir el tamaño del modelo, disminuir la latencia y aumentar la velocidad de inferencia
- Limitaciones de recursos: Los dispositivos móviles y de computación perimetral suelen tener estrictas limitaciones de memoria y recursos computacionales
- Compatibilidad multiplataforma: Garantizar que el modelo pueda ejecutarse en diferentes arquitecturas de hardware y sistemas operativos
Principales técnicas de conversión y optimización
| Tipo de técnica | Herramienta principal | Escenario de aplicación |
|---|---|---|
| Conversión de formato de modelo | tf.saved_model, TFLiteConverter |
Implementación multiplataforma |
| Cuantización | TFLiteConverter |
Reducir el tamaño del modelo y aumentar la velocidad de inferencia |
| Poda | tfmot |
Reducir el número de parámetros |
| Aceleración por hardware | TensorRT, Core ML | Optimización para hardware específico |
Conversión de formato de modelo
Formato SavedModel
SavedModel es el formato estándar de guardado de modelos de TensorFlow; incluye la arquitectura completa del modelo, los pesos y el grafo de cálculo.
Ejemplo
# Guardar como SavedModel
model.save('my_model', save_format='tf')
# Cargar SavedModel
loaded_model = tf.keras.models.load_model('my_model')
Características clave:
- Incluye el grafo de cálculo y las variables del modelo
- Admite la definición de firmas (especificaciones de entrada/salida)
- Compatibilidad multiplataforma (admite TensorFlow Serving)
Conversión a TensorFlow Lite
TensorFlow Lite es una solución ligera para dispositivos móviles y embebidos.
Ejemplo
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# Guardar el modelo convertido
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
Opciones de conversión:
optimizations: Configurar el nivel de optimización (predeterminado, optimización de tamaño, optimización de latencia)target_spec: Especificar las características del dispositivo de destinorepresentative_dataset: Conjunto de datos para la calibración de la cuantización
Técnicas de optimización de modelos
Cuantización (Quantization)
La cuantización reduce el tamaño del modelo y aumenta la velocidad de inferencia al disminuir la precisión numérica.
Ejemplo
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
Comparación de tipos de cuantización:
| Tipo de cuantización | Precisión de pesos | Precisión de activaciones | Reducción de tamaño | Pérdida de precisión |
|---|---|---|---|---|
| Sin cuantización | FP32 | FP32 | 0% | Ninguno |
| Rango dinámico | INT8 | FP32 | ~75% | Pequeño |
| Entero completo | INT8 | INT8 | ~75% | Medio |
| FP16 | FP16 | FP16 | ~50% | Muy pequeño |
Poda (Pruning)
La poda reduce los parámetros del modelo al eliminar conexiones neuronales no importantes.
Ejemplo
# Definir los parámetros de poda
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# Aplicar la poda
model = tf.keras.Sequential([...]) # Tu modelo
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# Entrenar el modelo podado
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# Quitar el envoltorio de poda
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
Optimización específica de hardware
Optimización TensorRT (GPU NVIDIA)
Ejemplo
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
Conversión Core ML (dispositivos Apple)
Ejemplo
# Convertir desde SavedModel
mlmodel = ct.convert('my_model')
# Guardar el modelo Core ML
mlmodel.save('model.mlmodel')
Mejores prácticas y problemas comunes
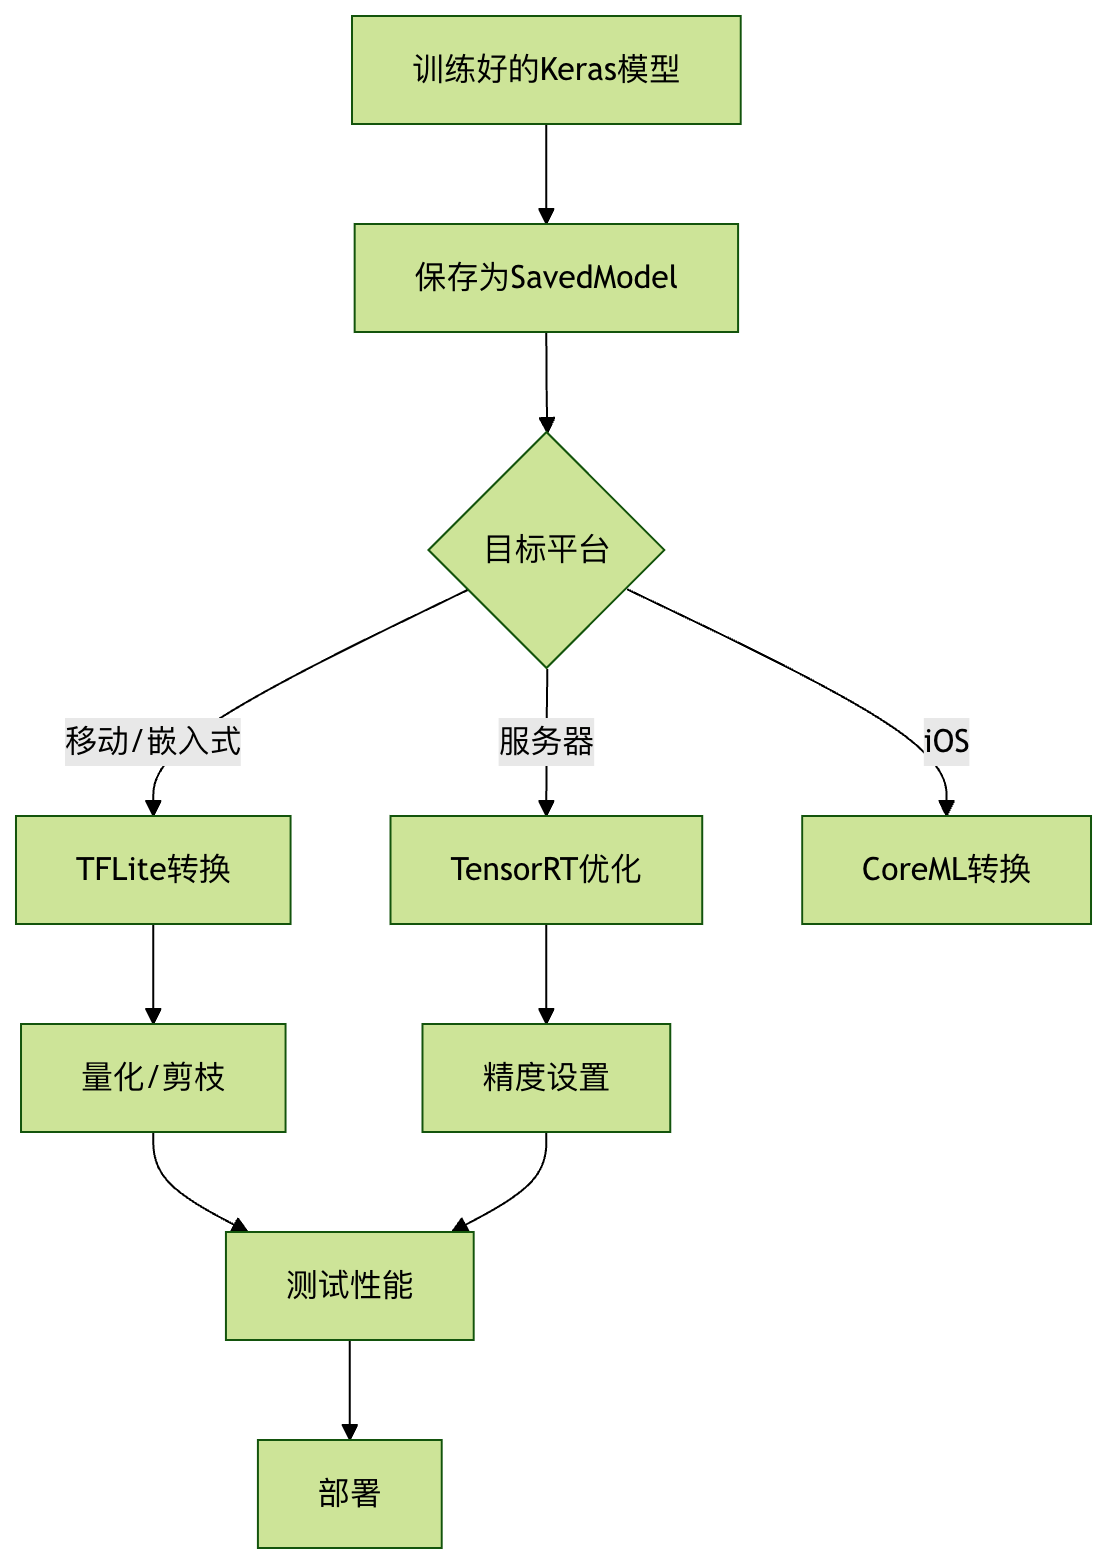
Proceso de conversión y optimización
Solución de problemas comunes
Pérdida excesiva de precisión
- Probar la cuantización mixta (mantener algunas capas en FP32)
- Usar entrenamiento consciente de la cuantización (QAT)
El modelo convertido no se puede ejecutar
- Comprobar la compatibilidad de las operaciones (algunas operaciones pueden no ser compatibles con la plataforma de destino)
- Actualizar TensorFlow y la versión del convertidor
La mejora del rendimiento no es evidente
- Asegurarse de que las opciones de optimización estén configuradas correctamente
- Considerar si la arquitectura del modelo en sí es adecuada para el hardware de destino