Consejos de optimización de modelos TensorFlow
La optimización de modelos es una etapa crucial en el flujo de trabajo del aprendizaje automático, ya que afecta directamente el rendimiento final del modelo. En TensorFlow, podemos utilizar diversas técnicas para mejorar la precisión y la capacidad de generalización del modelo.
¿Por qué se necesita la optimización de modelos?
- El modelo inicial generalmente no es ideal: los modelos entrenados por primera vez suelen presentar problemas de subajuste o sobreajuste
- Optimización del uso de recursos: mediante la optimización se puede obtener un mejor rendimiento con los mismos recursos computacionales
- Coincidencia con los requisitos del negocio: diferentes escenarios de aplicación tienen diferentes requisitos para el modelo (por ejemplo, precisión vs. velocidad)
1.2 Principales direcciones de optimización
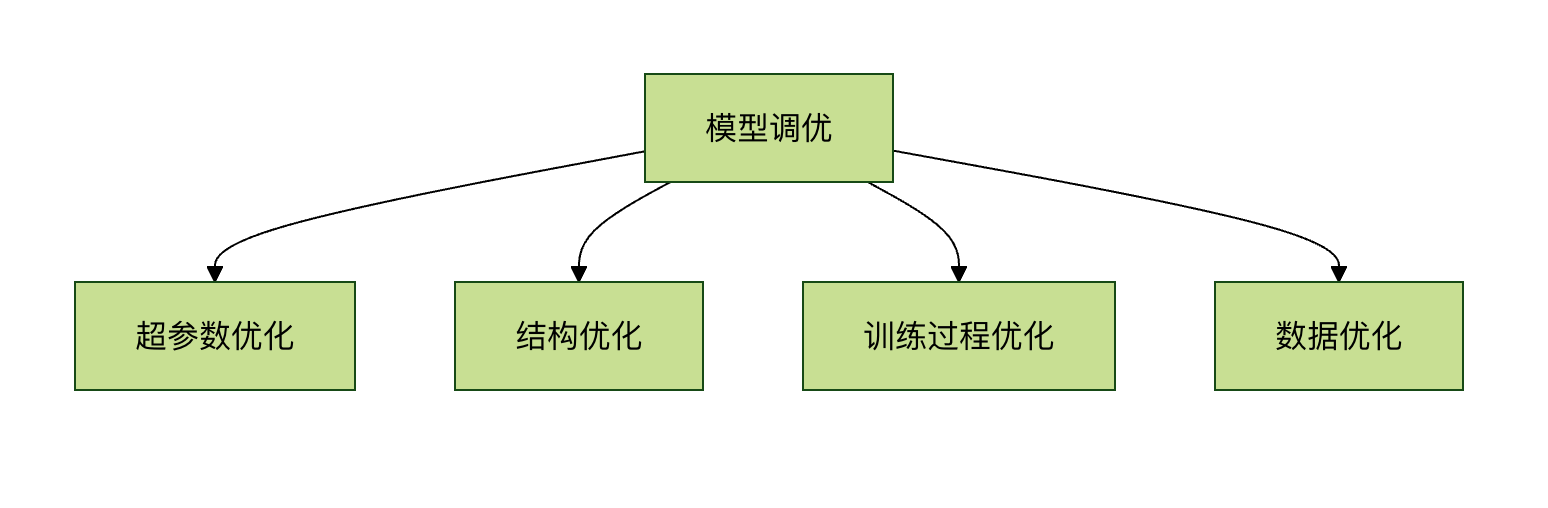
Consejos para la optimización de hiperparámetros
Ajuste de la tasa de aprendizaje
La tasa de aprendizaje es uno de los hiperparámetros más críticos, ya que afecta directamente la velocidad de convergencia y el rendimiento final del modelo.
Configuración de tasa de aprendizaje estática
Ejemplo
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
Estrategia de tasa de aprendizaje dinámica
Ejemplo
initial_learning_rate = 0.1
lr_schedule = tf.keras.optimizers.schedules.ExponentialDecay(
initial_learning_rate,
decay_steps=10000,
decay_rate=0.96,
staircase=True)
optimizer = tf.keras.optimizers.SGD(learning_rate=lr_schedule)
Buscador de tasa de aprendizaje
Ejemplo
import keras_tuner as kt
def build_model(hp):
model = tf.keras.Sequential()
model.add(tf.keras.layers.Dense(10))
# Configurar el rango de búsqueda de la tasa de aprendizaje
hp_learning_rate = hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])
model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=hp_learning_rate),
loss='mse')
return model
tuner = kt.RandomSearch(build_model, objective='val_loss', max_trials=5)
Selección del tamaño de lote
El tamaño de lote afecta la estabilidad del entrenamiento y el uso de memoria:
| Tamaño de lote | Ventajas | Desventajas |
|---|---|---|
| Lote pequeño (16-64) | Convergencia rápida, buena generalización | Entrenamiento inestable |
| Lote mediano (64-256) | Elección equilibrada | Requiere más memoria |
| Lote grande (256+) | Entrenamiento estable | Puede caer en óptimos locales |
Optimización de la estructura del modelo
Ajuste del tamaño y la profundidad de las capas
Consejos para ajustar la anchura
Ejemplo
def build_model(hp):
model = tf.keras.Sequential()
# Buscar el número óptimo de neuronas
hp_units = hp.Int('units', min_value=32, max_value=512, step=32)
model.add(tf.keras.layers.Dense(units=hp_units, activation='relu'))
model.add(tf.keras.layers.Dense(10))
model.compile(optimizer='adam', loss='mse')
return model
Estrategia de ajuste de profundidad
1. Comenzar con una red poco profunda e ir aumentando la profundidad gradualmente
2. Usar conexiones residuales (ResNet) para resolver el problema del desvanecimiento del gradiente en redes profundas
Ejemplo
def residual_block(x, filters):
shortcut = x
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Activation('relu')(x)
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Add()([shortcut, x])
return tf.keras.layers.Activation('relu')(x)
Técnicas de regularización
Dropout
Ejemplo
tf.keras.layers.Dense(128, activation='relu'),
tf.keras.layers.Dropout(0.5), # El 50% de las neuronas se descartan aleatoriamente
tf.keras.layers.Dense(10)
])
Regularización L1/L2
Ejemplo
tf.keras.layers.Dense(64,
activation='relu',
kernel_regularizer=tf.keras.regularizers.l2(0.01))
Detención temprana (Early Stopping)
Ejemplo
monitor='val_loss',
patience=5, # Detener si la pérdida de validación no mejora durante 5 épocas consecutivas
restore_best_weights=True) # Restaurar los mejores pesos
model.fit(x_train, y_train,
validation_data=(x_val, y_val),
epochs=100,
callbacks=[early_stopping])
Optimización del proceso de entrenamiento
Aumento de datos
Ejemplo
data_augmentation = tf.keras.Sequential([
tf.keras.layers.RandomFlip("horizontal"),
tf.keras.layers.RandomRotation(0.1),
tf.keras.layers.RandomZoom(0.1),
])
# Entrenar con datos aumentados
model.fit(data_augmentation(x_train), y_train, epochs=10)
Normalización por lotes (Batch Normalization)
Ejemplo
tf.keras.layers.Dense(64),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.Dense(10)
])
Recorte de gradientes
Ejemplo
optimizer = tf.keras.optimizers.Adam(clipvalue=1.0)
Técnicas avanzadas de optimización
Optimización automatizada de hiperparámetros
Ejemplo
tuner = kt.Hyperband(
build_model,
objective='val_accuracy',
max_epochs=10,
factor=3,
directory='my_dir',
project_name='intro_to_kt')
tuner.search(x_train, y_train, epochs=10, validation_data=(x_val, y_val))
best_model = tuner.get_best_models(num_models=1)[0]
Destilación de modelos
Ejemplo
teacher = tf.keras.models.load_model('teacher_model.h5')
# Definición del modelo estudiante
student = tf.keras.Sequential([...])
# Pérdida de destilación
def distillation_loss(y_true, y_pred, teacher_pred, temp=5.0):
return tf.keras.losses.kl_divergence(
tf.nn.softmax(teacher_pred/temp),
tf.nn.softmax(y_pred/temp))
Recomendaciones prácticas para la optimización
- Establecer una línea base: entrenar primero un modelo simple como referencia
- Ajustar un parámetro a la vez: evitar cambiar varios parámetros al mismo tiempo
- Registrar experimentos: usar TensorBoard o MLflow para realizar un seguimiento de los experimentos
- Uso del conjunto de validación: asegurarse de que el conjunto de validación represente la distribución real de los datos
- Considerar el costo computacional: equilibrar el efecto de la optimización con el consumo de recursos
Ejemplo
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir="./logs")
model.fit(x_train, y_train, epochs=10, callbacks=[tensorboard_callback])
Al aplicar sistemáticamente estos consejos de optimización, puedes mejorar significativamente el rendimiento de los modelos TensorFlow. Recuerda que la optimización de modelos es un proceso iterativo que requiere paciencia y un diseño experimental cuidadoso.
Otras extensiones