Konvertierung und Optimierung von TensorFlow-Modellen
Bei der Entwicklung von Machine-Learning-Projekten sind Modellkonvertierung und -optimierung wichtige Schritte vor der Bereitstellung.
TensorFlow bietet eine Vielzahl von Werkzeugen und Techniken, die Entwicklern helfen, trainierte Modelle in Formate zu konvertieren, die für verschiedene Bereitstellungsumgebungen geeignet sind, und sie zu optimieren, um die Leistung zu verbessern.
Warum sind Modellkonvertierung und -optimierung erforderlich?
- Bereitstellungsanforderungen: Das trainierte Modell muss sich an verschiedene Plattformen anpassen (Mobilgeräte, eingebettete Geräte, Server usw.)
- Leistungsverbesserung: Optimierung kann die Modellgröße reduzieren, die Latenz verringern und die Inferenzgeschwindigkeit erhöhen
- Ressourcenbeschränkungen: Mobile Geräte und Edge-Computing-Geräte haben typischerweise strenge Einschränkungen der Speicher- und Rechenressourcen
- Plattformübergreifende Kompatibilität: Sicherstellen, dass das Modell auf verschiedenen Hardwarearchitekturen und Betriebssystemen ausgeführt werden kann
Wichtigste Konvertierungs- und Optimierungstechniken
| Technologietyp | Wichtigste Tools | Geeignete Szenarien |
|---|---|---|
| Modellformat-Konvertierung | tf.saved_model, TFLiteConverter |
Plattformübergreifende Bereitstellung |
| Quantisierung | TFLiteConverter |
Modellgröße reduzieren und Inferenzgeschwindigkeit verbessern |
| Pruning | tfmot |
Anzahl der Parameter reduzieren |
| Hardwarebeschleunigung | TensorRT, Core ML | Spezifische Hardwareoptimierung |
Modellformat-Konvertierung
SavedModel-Format
SavedModel ist das Standardformat von TensorFlow zum Speichern von Modellen und enthält die vollständige Modellarchitektur, Gewichte und den Berechnungsgraphen.
Beispiel
# Als SavedModel speichern
model.save('my_model', save_format='tf')
# SavedModel laden
loaded_model = tf.keras.models.load_model('my_model')
Hauptmerkmale:
- Enthält den Berechnungsgraphen und die Variablen des Modells
- Unterstützt Signaturdefinitionen (Ein-/Ausgabespezifikationen)
- Plattformübergreifend kompatibel (unterstützt TensorFlow Serving)
TensorFlow-Lite-Konvertierung
TensorFlow Lite ist eine leichtgewichtige Lösung für Mobilgeräte und eingebettete Geräte.
Beispiel
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# Das konvertierte Modell speichern
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
Konvertierungsoptionen:
optimizations: Optimierungsstufe festlegen (Standard, Größenoptimierung, Latenzoptimierung)target_spec: Zielgeräteigenschaften angebenrepresentative_dataset: Für die Quantisierungskalibrierung verwendeter Datensatz
Techniken zur Modelloptimierung
Quantisierung
Quantisierung reduziert die Modellgröße und verbessert die Inferenzgeschwindigkeit, indem sie die numerische Präzision verringert.
Beispiel
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
Vergleich der Quantisierungstypen:
| Quantisierungstyp | Gewichtspräzision | Aktivierungspräzision | Größenreduzierung | Genauigkeitsverlust |
|---|---|---|---|---|
| Keine Quantisierung | FP32 | FP32 | 0% | Keine |
| Dynamischer Bereich | INT8 | FP32 | ~75% | gering |
| Vollständige Ganzzahl | INT8 | INT8 | ~75% | Mittel |
| FP16 | FP16 | FP16 | ~50% | Sehr klein |
Pruning
Pruning reduziert Modellparameter, indem unwichtige neuronale Verbindungen entfernt werden.
Beispiel
# Pruning-Parameter definieren
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# Pruning anwenden
model = tf.keras.Sequential([...]) # Dein Modell
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# Das beschnittene Modell trainieren
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# Den Pruning-Wrapper entfernen
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
Hardwarespezifische Optimierung
TensorRT-Optimierung (NVIDIA GPU)
Beispiel
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
Core ML-Konvertierung (Apple-Geräte)
Beispiel
# Konvertieren von SavedModel
mlmodel = ct.convert('my_model')
# Core ML-Modell speichern
mlmodel.save('model.mlmodel')
Best Practices und häufige Probleme
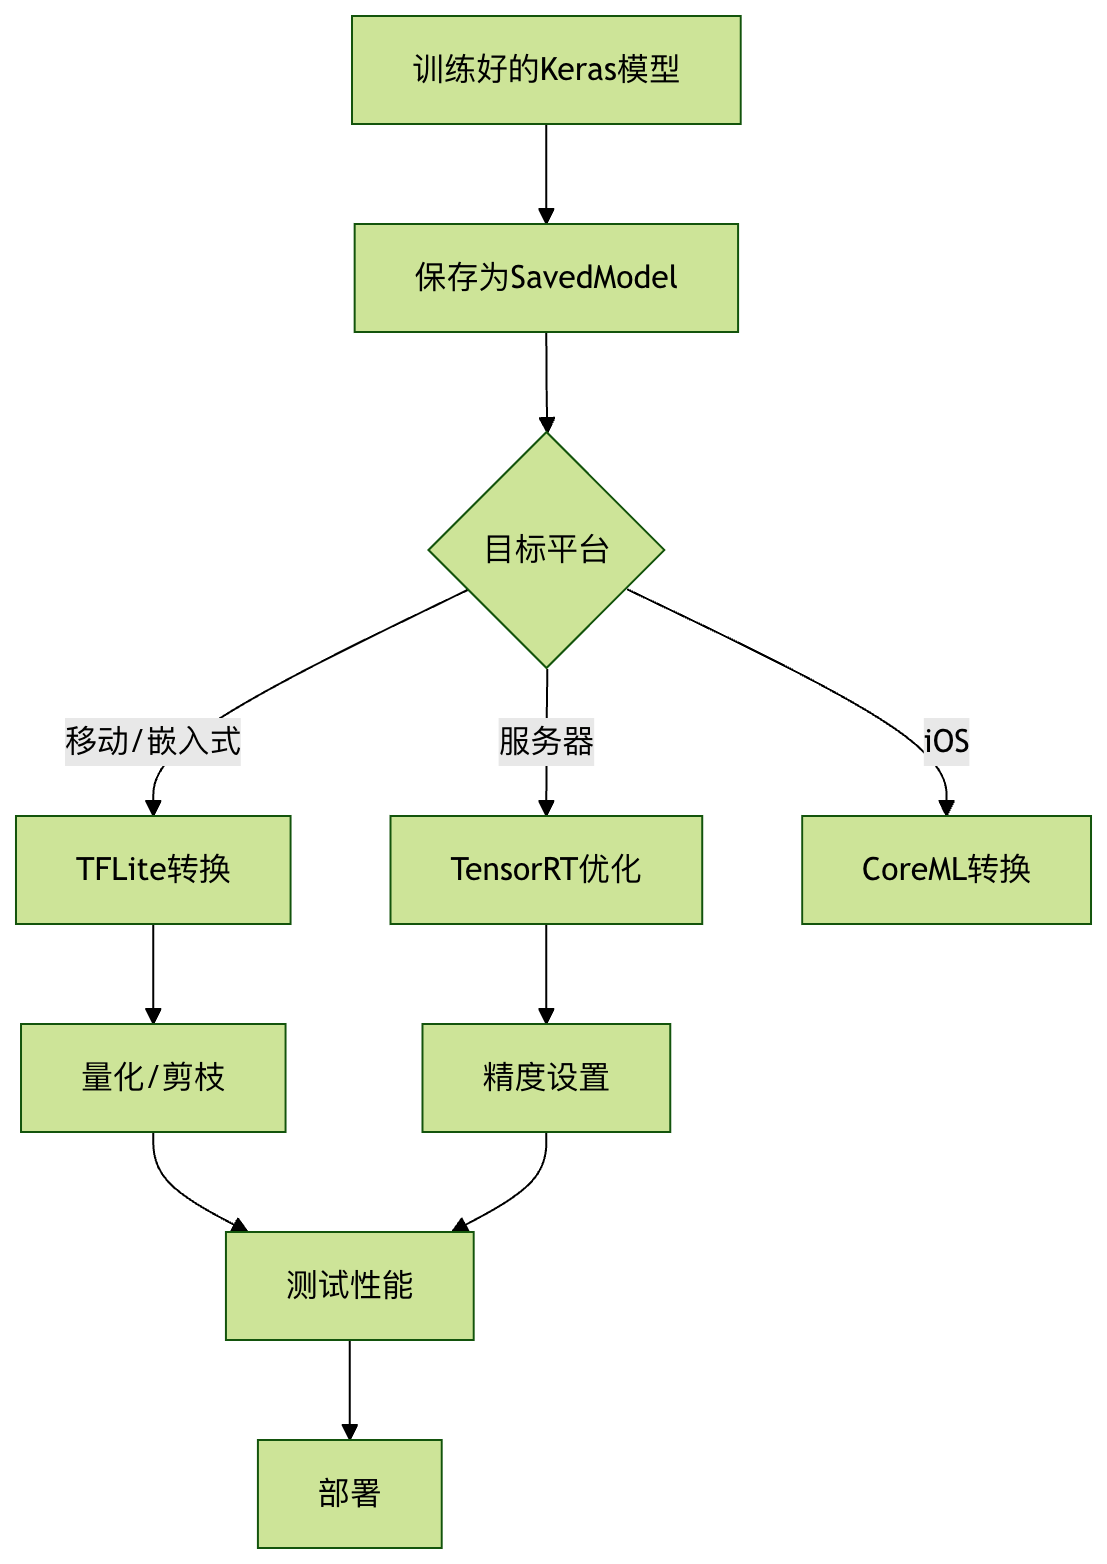
Konvertierungs- und Optimierungsworkflow
Fehlerbehebung bei häufigen Problemen
Genauigkeit sinkt zu stark
- Versuche gemischte Quantisierung (einige Schichten in FP32 behalten)
- Verwende quantisierungsbewusstes Training (QAT)
Konvertiertes Modell kann nicht ausgeführt werden
- Prüfen Sie die Operationskompatibilität (einige Operationen werden von der Zielplattform möglicherweise nicht unterstützt)
- Aktualisieren Sie TensorFlow- und Converter-Versionen
Leistungsverbesserung ist nicht offensichtlich
- Stellen Sie sicher, dass die Optimierungsoptionen korrekt eingestellt sind
- Überlegen Sie, ob die Modellarchitektur selbst für die Zielhardware geeignet ist