TensorFlow モデル変換と最適化
機械学習プロジェクトの開発において、モデル変換と最適化はデプロイ前の重要なステップです。
TensorFlow は、トレーニング済みのモデルをさまざまなデプロイ環境に適した形式に変換し、パフォーマンスを向上させるために最適化するための、多数のツールと技術を開発者に提供しています。
なぜモデル変換と最適化が必要なのか
- デプロイ要件:トレーニング済みモデルはさまざまなプラットフォーム(モバイル端末、組み込みデバイス、サーバーなど)に適合させる必要があります
- パフォーマンス向上:最適化により、モデルサイズの削減、レイテンシの低減、推論速度の向上が可能です
- リソース制約:モバイルデバイスやエッジコンピューティングデバイスには通常、厳しいメモリと計算リソースの制約があります
- クロスプラットフォーム互換性:モデルが異なるハードウェアアーキテクチャやオペレーティングシステム上で動作することを保証します
主な変換と最適化技術
| 技術タイプ | 主なツール | 適用シナリオ |
|---|---|---|
| モデル形式の変換 | tf.saved_model, TFLiteConverter |
クロスプラットフォームデプロイ |
| 量子化 | TFLiteConverter |
モデルサイズの削減、推論速度の向上 |
| 枝刈り | tfmot |
パラメータ数の削減 |
| ハードウェアアクセラレーション | TensorRT, Core ML | 特定ハードウェア向けの最適化 |
モデル形式の変換
SavedModel 形式
SavedModel は TensorFlow の標準的なモデル保存形式であり、完全なモデルアーキテクチャ、重み、計算グラフを含みます。
例
import tensorflow as tf
# SavedModel として保存
model.save('my_model', save_format='tf')
# SavedModel を読み込み
loaded_model = tf.keras.models.load_model('my_model')
# SavedModel として保存
model.save('my_model', save_format='tf')
# SavedModel を読み込み
loaded_model = tf.keras.models.load_model('my_model')
主な特徴:
- モデルの計算グラフと変数を含む
- シグネチャ定義(入力/出力仕様)をサポート
- クロスプラットフォーム互換(TensorFlow Serving をサポート)
TensorFlow Lite 変換
TensorFlow Lite は、モバイルおよび組み込みデバイス向けの軽量ソリューションです。
例
# モデルを TFLite 形式に変換
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# 変換後のモデルを保存
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# 変換後のモデルを保存
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
変換オプション:
optimizations:最適化レベルを設定(デフォルト、サイズ最適化、レイテンシ最適化)target_spec:ターゲットデバイスの特性を指定representative_dataset:量子化キャリブレーション用のデータセット
モデル最適化技術
量子化(Quantization)
量子化は数値精度を下げることで、モデルサイズを縮小し、推論速度を向上させます。
例
# 動的範囲量子化(最も簡単な量子化方法)
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
量子化タイプの比較:
| 量子化タイプ | 重みの精度 | 活性化の精度 | サイズ削減 | 精度の損失 |
|---|---|---|---|---|
| 量子化なし | FP32 | FP32 | 0% | 无 |
| 動的範囲 | INT8 | FP32 | ~75% | 小 |
| 全整数 | INT8 | INT8 | ~75% | 中程度 |
| FP16 | FP16 | FP16 | ~50% | 非常に小さい |
枝刈り(Pruning)
枝刈りは重要でないニューロン間の接続を除去することで、モデルのパラメータを削減します。
例
import tensorflow_model_optimization as tfmot
# 枝刈りパラメータを定義
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# 枝刈りを適用
model = tf.keras.Sequential([...]) # あなたのモデル
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# 枝刈りモデルをトレーニング
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# 枝刈りラッパーを除去
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
# 枝刈りパラメータを定義
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# 枝刈りを適用
model = tf.keras.Sequential([...]) # あなたのモデル
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# 枝刈りモデルをトレーニング
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# 枝刈りラッパーを除去
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
ハードウェア固有の最適化
TensorRT 最適化(NVIDIA GPU)
例
# TF-TRT コンバーターを使用
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
Core ML 変換(Apple デバイス)
例
import coremltools as ct
# SavedModel から変換
mlmodel = ct.convert('my_model')
# Core ML モデルを保存
mlmodel.save('model.mlmodel')
# SavedModel から変換
mlmodel = ct.convert('my_model')
# Core ML モデルを保存
mlmodel.save('model.mlmodel')
ベストプラクティスとよくある問題
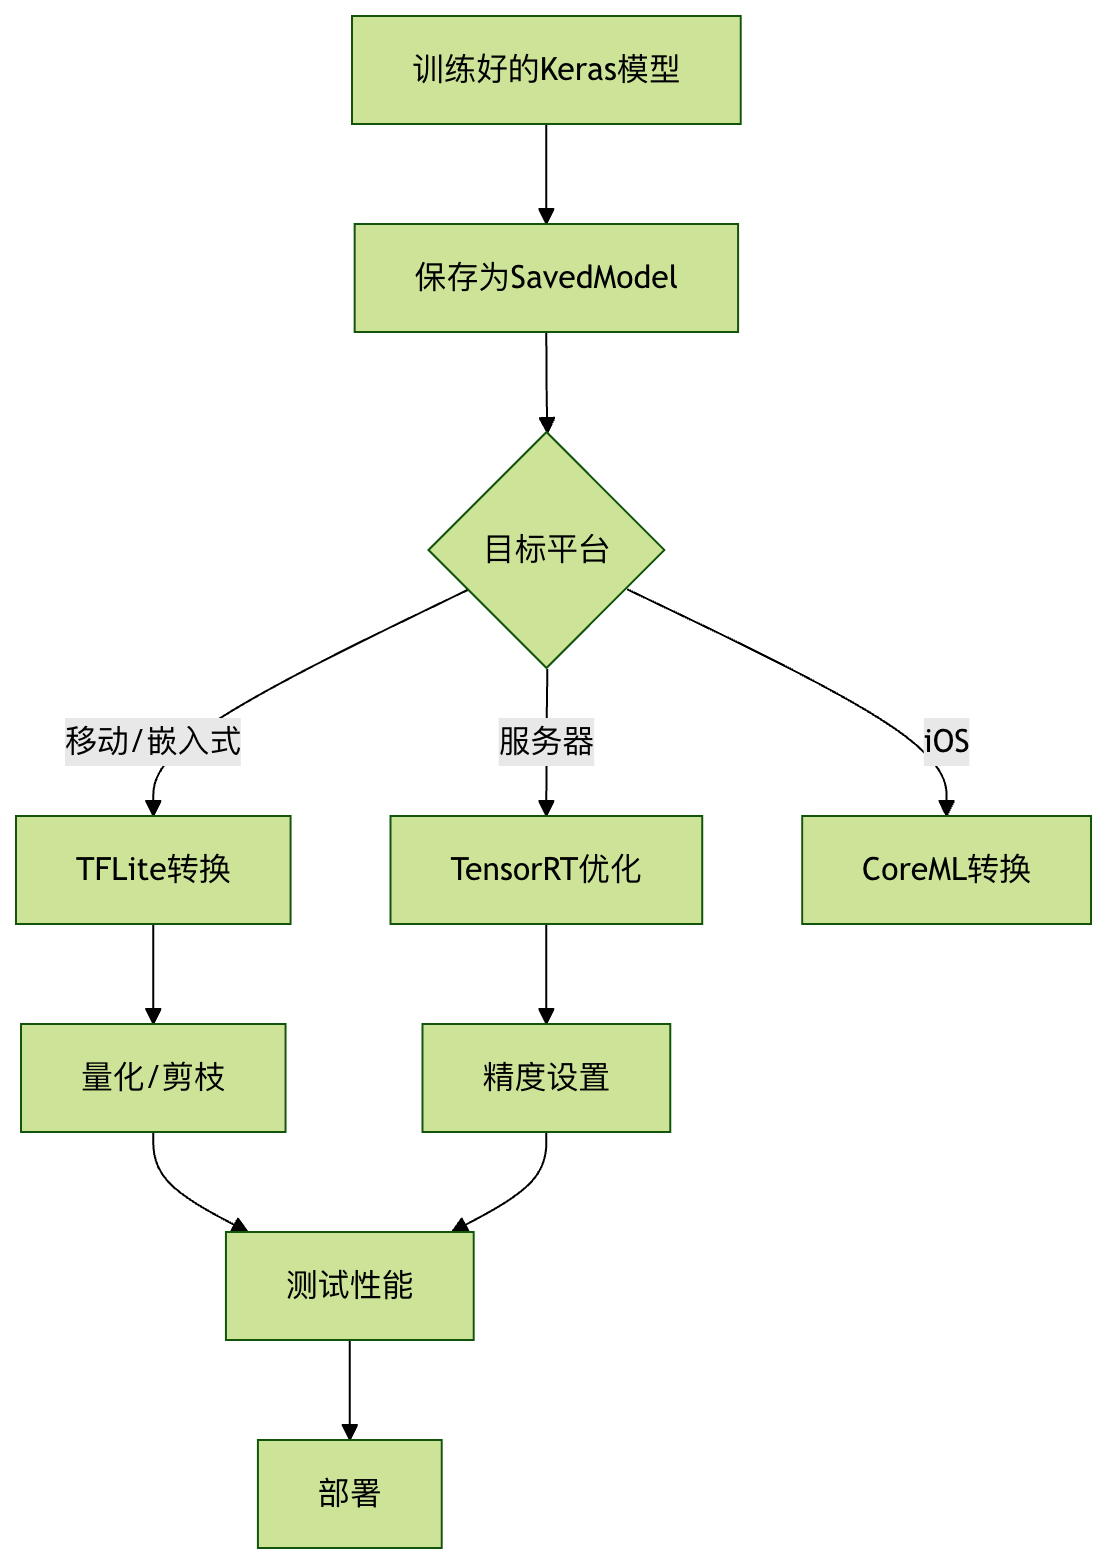
変換・最適化の流れ
よくある問題の解決
精度の低下が大きすぎる
- 混合量子化を試す(一部のレイヤーはFP32を維持)
- 量子化認識トレーニング(QAT)を使用する
変換後のモデルが実行できない
- オペレーションの互換性を確認する(一部のオペレーションはターゲットプラットフォームでサポートされていない場合があります)
- TensorFlow とコンバーターのバージョンを更新する
パフォーマンスの向上が顕著でない
- 最適化オプションが正しく設定されていることを確認する
- モデルアーキテクチャ自体がターゲットハードウェアに適しているかどうかを検討する