TensorFlow Entrenamiento de Modelos
TensorFlow proporciona un conjunto completo de herramientas para construir y entrenar modelos de redes neuronales.
El entrenamiento de modelos es el proceso mediante el cual el modelo ajusta automáticamente sus parámetros a través de los datos para obtener capacidad de predicción.
Elementos clave del entrenamiento de modelos
- Datos: conjunto de entrenamiento, conjunto de validación y conjunto de prueba
- Arquitectura del modelo: estructura de capas y forma de conexión de la red neuronal
- Función de pérdida: métrica que mide la diferencia entre las predicciones del modelo y los valores reales
- Optimizador: algoritmo que ajusta los parámetros del modelo
- Métricas de evaluación: estándar para medir el rendimiento del modelo
Proceso de entrenamiento
1. Preparación de datos
Ejemplo
from tensorflow.keras import datasets
# Cargar el conjunto de datos (por ejemplo, MNIST)
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
# Preprocesamiento de datos
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
# Convertir a TensorFlow Dataset
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
2. Construcción del modelo
Ejemplo
# Construir un modelo Sequential
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
# Ver la estructura del modelo
model.summary()
3. Compilación del modelo
Ejemplo
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Descripción de los parámetros de compilación
| Parámetro | Valores opcionales | Descripción |
|---|---|---|
| optimizer | 'adam', 'sgd', 'rmsprop', etc. | Selección del algoritmo de optimización |
| loss | 'mse', 'categorical_crossentropy', etc. | Tipo de función de pérdida |
| metrics | ['accuracy'], ['mse'], etc. | Lista de métricas de evaluación |
4. Entrenamiento del modelo
Ejemplo
epochs=10,
validation_data=(test_images, test_labels))
Parámetros principales del método fit()
| Parámetro | Tipo | Descripción |
|---|---|---|
| x | Datos de entrada | Datos de entrenamiento |
| y | Datos objetivo | Datos de etiquetas |
| epochs | Entero | Número de épocas (epochs) |
| batch_size | Entero | Tamaño de cada lote (batch) |
| validation_data | Tupla | Conjunto de datos de validación |
| callbacks | Lista | Lista de callbacks |
Visualización del proceso de entrenamiento
Curvas de entrenamiento
Ejemplo
# Dibujar las curvas de precisión del entrenamiento y la validación
plt.plot(history.history['accuracy'], label='Training Accuracy')
plt.plot(history.history['val_accuracy'], label='Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.legend()
plt.show()
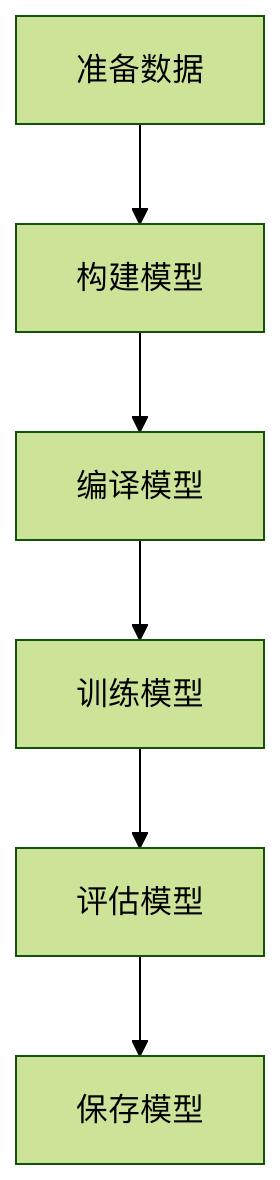
Diagrama de flujo del entrenamiento
Técnicas avanzadas de entrenamiento
Bucle de entrenamiento personalizado
Ejemplo
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
# Personalizar los pasos de entrenamiento
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
# Bucle de entrenamiento personalizado
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Epoch {epoch}, Loss: {loss.numpy()}')
Uso de callbacks
Ejemplo
# Crear callbacks
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
# Entrenar usando callbacks
model.fit(train_dataset,
epochs=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
Problemas comunes y soluciones
Tabla de resolución de problemas de entrenamiento
| Síntoma del problema | Causa posible | Solución |
|---|---|---|
| La pérdida no disminuye | Tasa de aprendizaje demasiado alta/baja | Ajustar la tasa de aprendizaje |
| La precisión fluctúa mucho | Tamaño de lote inadecuado | Ajustar el batch_size |
| Sobreajuste (overfitting) | Modelo demasiado complejo | Añadir regularización o Dropout |
| Velocidad de entrenamiento lenta | Limitaciones de hardware | Usar aceleración por GPU o reducir el modelo |
Consejos de optimización del rendimiento
Optimización de la canalización de datos (data pipeline):
Ejemplo
# Usar prefetch y cache para acelerar la carga de datos
train_dataset = train_dataset.cache().prefetch(buffer_size=tf.data.AUTOTUNE)
Entrenamiento de precisión mixta:
Ejemplo
policy = tf.keras.mixed_precision.Policy('mixed_float16')
tf.keras.mixed_precision.set_global_policy(policy)
Entrenamiento distribuido:
Ejemplo
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
model = create_model()
model.compile(...)
Ejercicios prácticos
Ejercicio 1: Entrenamiento básico
Usa el conjunto de datos Fashion MNIST, construye un modelo CNN y completa el entrenamiento. Requisitos:
- Incluir al menos 2 capas convolucionales
- Entrenar durante 10 épocas
- Registrar los cambios de precisión y pérdida durante el entrenamiento
Ejercicio 2: Técnicas avanzadas
Sobre la base del Ejercicio 1:
- Añadir el callback EarlyStopping
- Implementar la disminución de la tasa de aprendizaje
- Usar ModelCheckpoint para guardar el mejor modelo
Ejercicio 3: Entrenamiento personalizado
Intenta usar un bucle de entrenamiento personalizado para realizar la tarea del Ejercicio 1 y compara las diferencias con el método fit().
A través de este artículo, deberías haber dominado el flujo central y las técnicas clave del entrenamiento de modelos con TensorFlow. En la práctica, es necesario ajustar la estrategia de entrenamiento según el problema específico y las características de los datos. Se recomienda comenzar con modelos simples, aumentar la complejidad gradualmente y encontrar la mejor configuración de entrenamiento mediante experimentos.
Otras extensiones