TensorFlow Ejemplo - Proyecto de Clasificación de Imágenes
La clasificación de imágenes es una de las tareas más básicas e importantes en visión por computadora. Este proyecto utilizará el framework TensorFlow para construir un modelo de aprendizaje profundo capaz de reconocer imágenes de diferentes categorías.
¿Qué es la clasificación de imágenes?
La clasificación de imágenes es la tecnología que permite a la computadora identificar automáticamente la categoría del objeto principal en una imagen. Por ejemplo:
- Identificar si en una foto hay un gato o un perro
- Distinguir diferentes tipos de flores
- Determinar el tipo de lesión en imágenes médicas
Selección de tecnología
Usaremos la siguiente pila tecnológica:
- TensorFlow: el framework de aprendizaje profundo principal desarrollado por Google
- Keras: API de alto nivel de TensorFlow, simplifica la construcción de modelos
- Matplotlib: se utiliza para visualizar el proceso de entrenamiento y los resultados
Preparación del entorno
Instalar bibliotecas necesarias
pip install tensorflow matplotlib numpy
Verificar instalación
import tensorflow as tf
print(f"TensorFlow 版本: {tf.__version__}")
Preparación del conjunto de datos
Usaremos el clásico conjunto de datos CIFAR-10, que contiene 60,000 imágenes en color de 32x32 en 10 categorías.
Cargar el conjunto de datos
Ejemplo
# Cargar datos
(train_images, train_labels), (test_images, test_labels) = cifar10.load_data()
# Nombres de categorías
class_names = ['avión', 'coche', 'pájaro', 'gato', 'ciervo',
'perro', 'rana', 'caballo', 'barco', 'camión']
3.2 Preprocesamiento de datos
Ejemplo
train_images = train_images / 255.0
test_images = test_images / 255.0
# Ver la forma de los datos
print("Forma de las imágenes del conjunto de entrenamiento:", train_images.shape)
print("Forma de las etiquetas del conjunto de entrenamiento:", train_labels.shape)
4. Construcción del modelo
4.1 Arquitectura del modelo
Construiremos una red neuronal convolucional (CNN), que es la estructura clásica para tareas de imágenes.
Ejemplo
model = models.Sequential([
# Capa convolucional 1
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(32, 32, 3)),
layers.MaxPooling2D((2, 2)),
# Capa convolucional 2
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
# Capa convolucional 3
layers.Conv2D(64, (3, 3), activation='relu'),
# Capa totalmente conectada
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10) # Capa de salida, 10 categorías
])
Visualización de la estructura del modelo
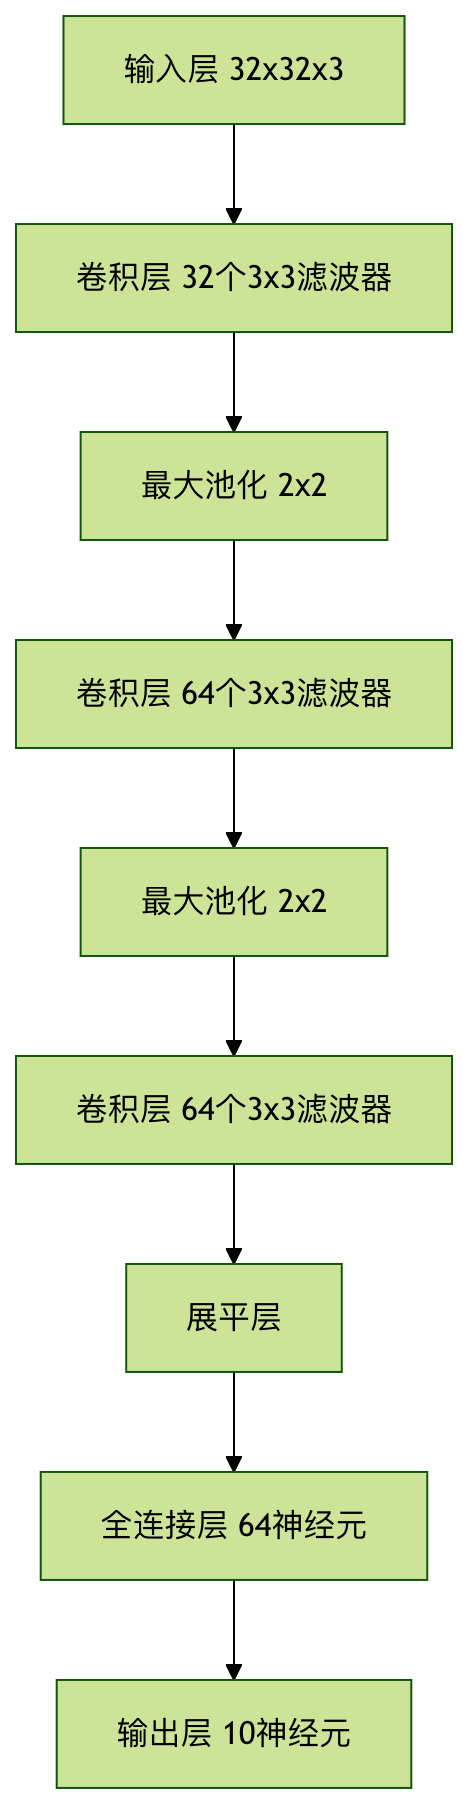
Entrenamiento del modelo
Compilación del modelo
Ejemplo
loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
metrics=['accuracy'])
Comenzar el entrenamiento
Ejemplo
validation_data=(test_images, test_labels))
Visualización del proceso de entrenamiento
Ejemplo
plt.plot(history.history['accuracy'], label='Precisión de entrenamiento')
plt.plot(history.history['val_accuracy'], label='Precisión de validación')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.ylim([0, 1])
plt.legend(loc='lower right')
plt.show()
Evaluación y predicción del modelo
Evaluar rendimiento en el conjunto de prueba
Ejemplo
print(f'\nPrecisión de prueba: {test_acc}')
Realizar predicciones
Ejemplo
# Agregar capa softmax para que la salida sea probabilidad
probability_model = tf.keras.Sequential([model, layers.Softmax()])
# Realizar predicciones en las primeras 5 imágenes del conjunto de prueba
predictions = probability_model.predict(test_images[:5])
# Mostrar resultados de predicción
for i in range(5):
predicted_label = np.argmax(predictions[i])
true_label = test_labels[i][0]
print(f"Predicción: {class_names[predicted_label]} | Real: {class_names[true_label]}")
Sugerencias de ampliación del proyecto
Métodos para mejorar el rendimiento del modelo
- Aumentar la profundidad de la red (más capas convolucionales)
- Usar técnicas de aumento de datos
- Probar diferentes optimizadores y tasas de aprendizaje
- Agregar capas de normalización por lotes
Direcciones de aplicación práctica
- Análisis de imágenes médicas
- Reconocimiento de objetos en conducción autónoma
- Sistemas de inspección de calidad industrial
- Sistemas de vigilancia de seguridad
8. Preguntas frecuentes
Q1: ¿Por qué elegir CNN en lugar de una red neuronal común?
R: La CNN puede capturar mejor las características espaciales de las imágenes mediante conexiones locales y pesos compartidos, y tiene menos parámetros.
Q2: ¿Cómo elegir el número adecuado de épocas?
R: Observa la precisión del conjunto de validación; cuando deje de mejorar, detén el entrenamiento para evitar el sobreajuste.
Q3: ¿Qué hacer si se produce un error de memoria insuficiente?
R: Puedes reducir el tamaño del lote (batch size) o usar un tamaño de imagen más pequeño.
Otras extensiones