Преобразование и оптимизация модели TensorFlow
При разработке проектов машинного обучения конвертация и оптимизация моделей — важные этапы перед развёртыванием.
TensorFlow предоставляет множество инструментов и методов, помогающих разработчикам преобразовывать обученные модели в форматы, подходящие для различных сред развёртывания, и оптимизировать их для повышения производительности.
Зачем нужны конвертация и оптимизация моделей?
- Требования к развёртыванию: обученная модель должна адаптироваться к различным платформам (мобильные устройства, встраиваемые устройства, серверы и т. д.)
- Повышение производительности: оптимизация позволяет уменьшить размер модели, снизить задержку и повысить скорость инференса
- Ограничения ресурсов: Мобильные устройства и устройства периферийных вычислений обычно имеют строгие ограничения памяти и вычислительных ресурсов
- Кроссплатформенная совместимость: Обеспечить возможность запуска модели на различных аппаратных архитектурах и операционных системах
Основные методы преобразования и оптимизации
| Тип технологии | Основные инструменты | Применимые сценарии |
|---|---|---|
| Преобразование формата модели | tf.saved_model, TFLiteConverter |
Кроссплатформенное развертывание |
| Квантование | TFLiteConverter |
Уменьшить размер модели и повысить скорость инференса |
| Прунинг | tfmot |
Уменьшить количество параметров |
| Аппаратное ускорение | TensorRT, Core ML | Оптимизация под конкретное оборудование |
Преобразование формата модели
Формат SavedModel
SavedModel — это стандартный формат сохранения моделей в TensorFlow, содержащий полную архитектуру модели, веса и вычислительный граф.
Пример
# Сохранить как SavedModel
model.save('my_model', save_format='tf')
# Загрузить SavedModel
loaded_model = tf.keras.models.load_model('my_model')
Ключевые особенности:
- Содержит вычислительный граф и переменные модели
- Поддерживает определения сигнатур (спецификации входов/выходов)
- Кроссплатформенная совместимость (поддерживает TensorFlow Serving)
Преобразование в TensorFlow Lite
TensorFlow Lite — это легковесное решение для мобильных и встраиваемых устройств.
Пример
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# Сохранить преобразованную модель
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
Параметры преобразования:
optimizations: Задать уровень оптимизации (по умолчанию, оптимизация размера, оптимизация задержки)target_spec: Указать характеристики целевого устройстваrepresentative_dataset: Набор данных, используемый для калибровки квантования
Методы оптимизации моделей
Квантование
Квантование уменьшает размер модели и повышает скорость вывода за счёт снижения числовой точности.
Пример
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
Сравнение типов квантования:
| Тип квантования | Точность весов | Точность активаций | Уменьшение размера | Потеря точности |
|---|---|---|---|---|
| Без квантования | FP32 | FP32 | 0% | Отсутствует |
| Динамический диапазон | INT8 | FP32 | ~75% | малый |
| Полноцелочисленный | INT8 | INT8 | ~75% | Средняя |
| FP16 | FP16 | FP16 | ~50% | Очень маленькая |
Прунинг
Прунинг уменьшает количество параметров модели, удаляя неважные нейронные связи.
Пример
# Определить параметры прунинга
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# Применить прунинг
model = tf.keras.Sequential([...]) # Ваша модель
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# Обучить прунингованную модель
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# Удалите обёртку прунинга
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
Аппаратно-зависимая оптимизация
Оптимизация TensorRT (NVIDIA GPU)
Пример
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
Конвертация Core ML (устройства Apple)
Пример
# Конвертация из SavedModel
mlmodel = ct.convert('my_model')
# Сохранить модель Core ML
mlmodel.save('model.mlmodel')
Лучшие практики и типичные проблемы
Рабочий процесс конвертации и оптимизации
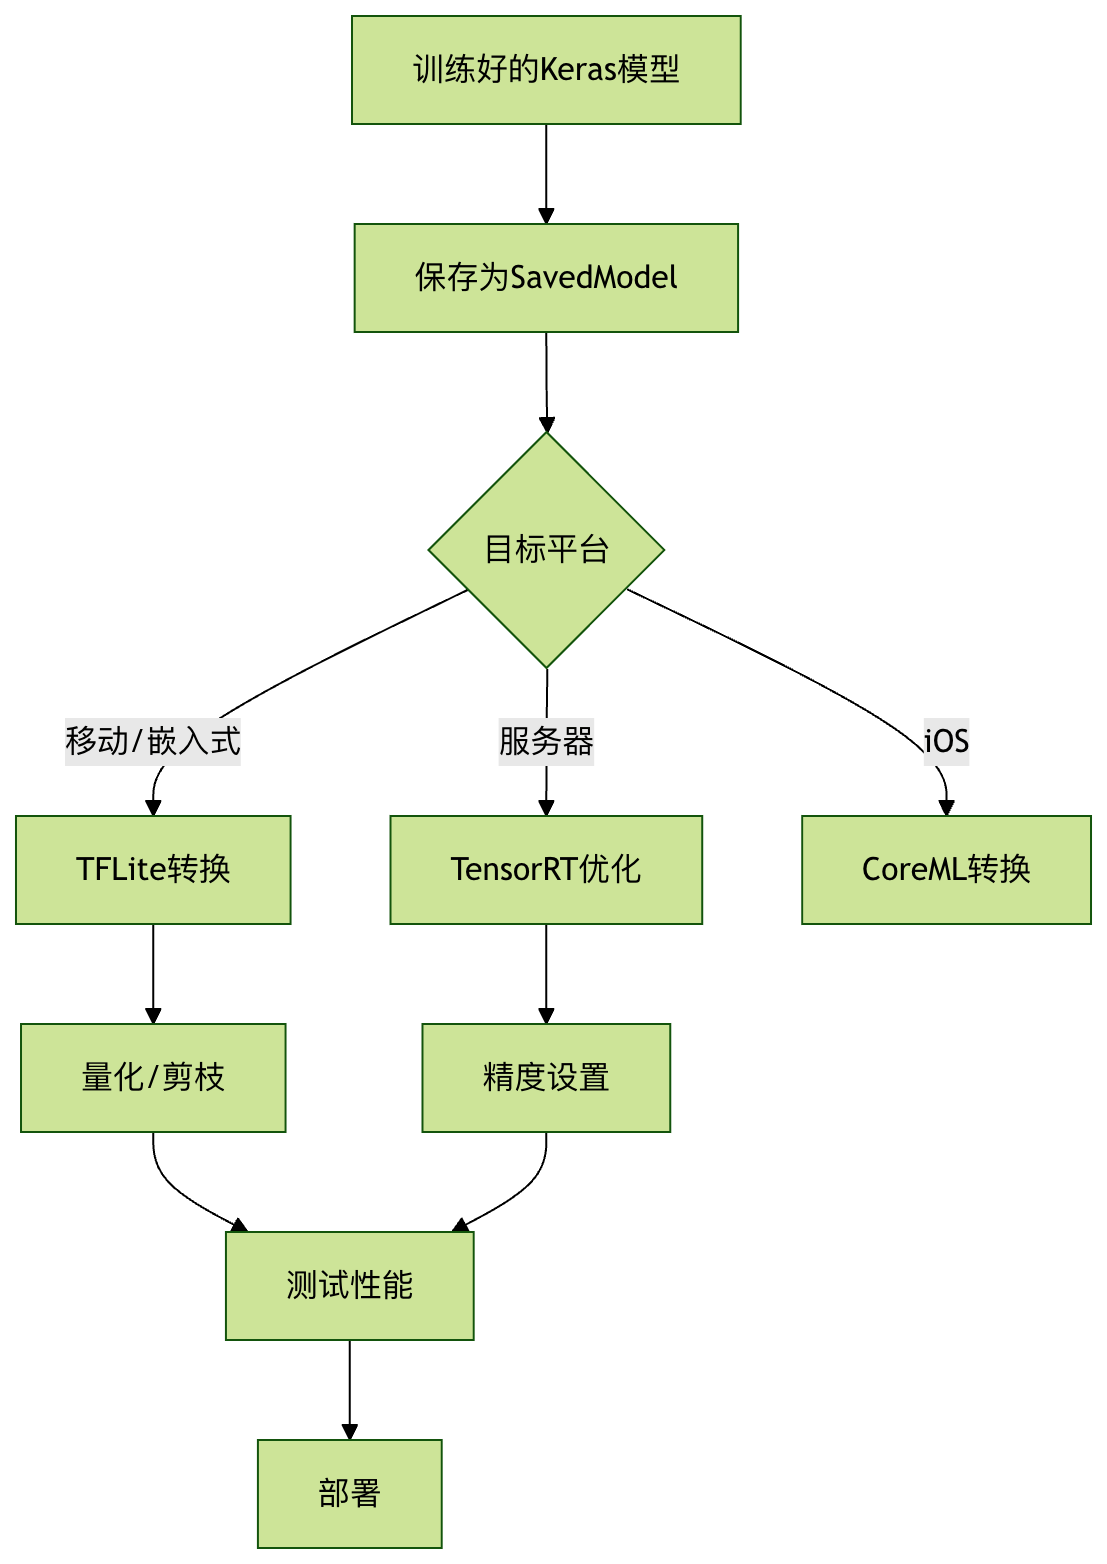
Устранение распространённых проблем
Точность падает слишком сильно
- Попробуйте смешанное квантование (оставьте некоторые слои в FP32)
- Используйте обучение с учётом квантования (QAT)
Преобразованная модель не может запуститься
- Проверьте совместимость операций (некоторые операции могут не поддерживаться целевой платформой)
- Обновите версии TensorFlow и конвертера
Улучшение производительности неочевидно
- Убедитесь, что параметры оптимизации заданы правильно
- Рассмотрите, подходит ли сама архитектура модели для целевого оборудования