Conversion et optimisation de modèle TensorFlow
Dans le développement de projets d'apprentissage automatique, la conversion et l'optimisation de modèle sont des étapes importantes avant le déploiement.
TensorFlow fournit une variété d'outils et de techniques pour aider les développeurs à convertir des modèles entraînés dans des formats adaptés à différents environnements de déploiement, et à les optimiser pour améliorer les performances.
Pourquoi la conversion et l'optimisation de modèle sont-elles nécessaires ?
- Exigences de déploiement: Le modèle entraîné doit s'adapter à différentes plateformes (mobile, appareils embarqués, serveurs, etc.)
- Amélioration des performances: L'optimisation peut réduire la taille du modèle, diminuer la latence et améliorer la vitesse d'inférence.
- Contraintes de ressources: Les appareils mobiles et les appareils d'informatique en périphérie ont généralement des limitations strictes en mémoire et en ressources de calcul
- Compatibilité multiplateforme: Veiller à ce que le modèle puisse s'exécuter sur différentes architectures matérielles et différents systèmes d'exploitation
Principales techniques de conversion et d'optimisation
| Type de technologie | Principaux outils | Scénarios applicables |
|---|---|---|
| Conversion de format de modèle | tf.saved_model, TFLiteConverter |
Déploiement multiplateforme |
| Quantification | TFLiteConverter |
Réduire la taille du modèle et améliorer la vitesse d'inférence |
| Élagage | tfmot |
Réduire le nombre de paramètres |
| Accélération matérielle | TensorRT, Core ML | Optimisation matérielle spécifique |
Conversion de format de modèle
Format SavedModel
SavedModel est le format standard de sauvegarde de modèle de TensorFlow, contenant l'architecture complète du modèle, les poids et le graphe de calcul.
Exemple
# Enregistrer au format SavedModel
model.save('my_model', save_format='tf')
# Charger le SavedModel
loaded_model = tf.keras.models.load_model('my_model')
Fonctionnalités clés :
- Contient le graphe de calcul et les variables du modèle
- Prend en charge les définitions de signature (spécifications d'entrée/sortie)
- Compatible multiplateforme (prend en charge TensorFlow Serving)
Conversion TensorFlow Lite
TensorFlow Lite est une solution légère pour les appareils mobiles et embarqués.
Exemple
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
tflite_model = converter.convert()
# Enregistrer le modèle converti
with open('model.tflite', 'wb') as f:
f.write(tflite_model)
Options de conversion:
optimizations: Définir le niveau d'optimisation (par défaut, optimisation de la taille, optimisation de la latence)target_spec: Spécifier les caractéristiques de l'appareil ciblerepresentative_dataset: Jeu de données utilisé pour la calibration de quantification
Techniques d’optimisation des modèles
Quantification
La quantification réduit la taille du modèle et améliore la vitesse d'inférence en abaissant la précision numérique.
Exemple
converter = tf.lite.TFLiteConverter.from_saved_model('my_model')
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
Comparaison des types de quantification :
| Type de quantification | Précision des poids | Précision des activations | Réduction de taille | Perte de précision |
|---|---|---|---|---|
| Aucune quantification | FP32 | FP32 | 0% | Aucune |
| Plage dynamique | INT8 | FP32 | ~75% | petit |
| Entier complet | INT8 | INT8 | ~75% | Moyenne |
| FP16 | FP16 | FP16 | ~50% | Très minime |
Élagage
L'élagage réduit les paramètres du modèle en supprimant les connexions neuronales non importantes.
Exemple
# Définir les paramètres d'élagage
prune_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=1000
)
}
# Appliquer l'élagage
model = tf.keras.Sequential([...]) # Votre modèle
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(model, **prune_params)
# Entraîner le modèle élagué
model_for_pruning.compile(...)
model_for_pruning.fit(...)
# Supprimer le wrapper d'élagage
model_for_export = tfmot.sparsity.keras.strip_pruning(model_for_pruning)
Optimisation spécifique au matériel
Optimisation TensorRT (GPU NVIDIA)
Exemple
from tensorflow.python.compiler.tensorrt import trt_convert as trt
converter = trt.TrtGraphConverterV2(
input_saved_model_dir='my_model',
precision_mode=trt.TrtPrecisionMode.FP16
)
converter.convert()
converter.save('trt_optimized_model')
Conversion Core ML (appareils Apple)
Exemple
# Convertir depuis SavedModel
mlmodel = ct.convert('my_model')
# Enregistrer le modèle Core ML
mlmodel.save('model.mlmodel')
Bonnes pratiques et problèmes courants
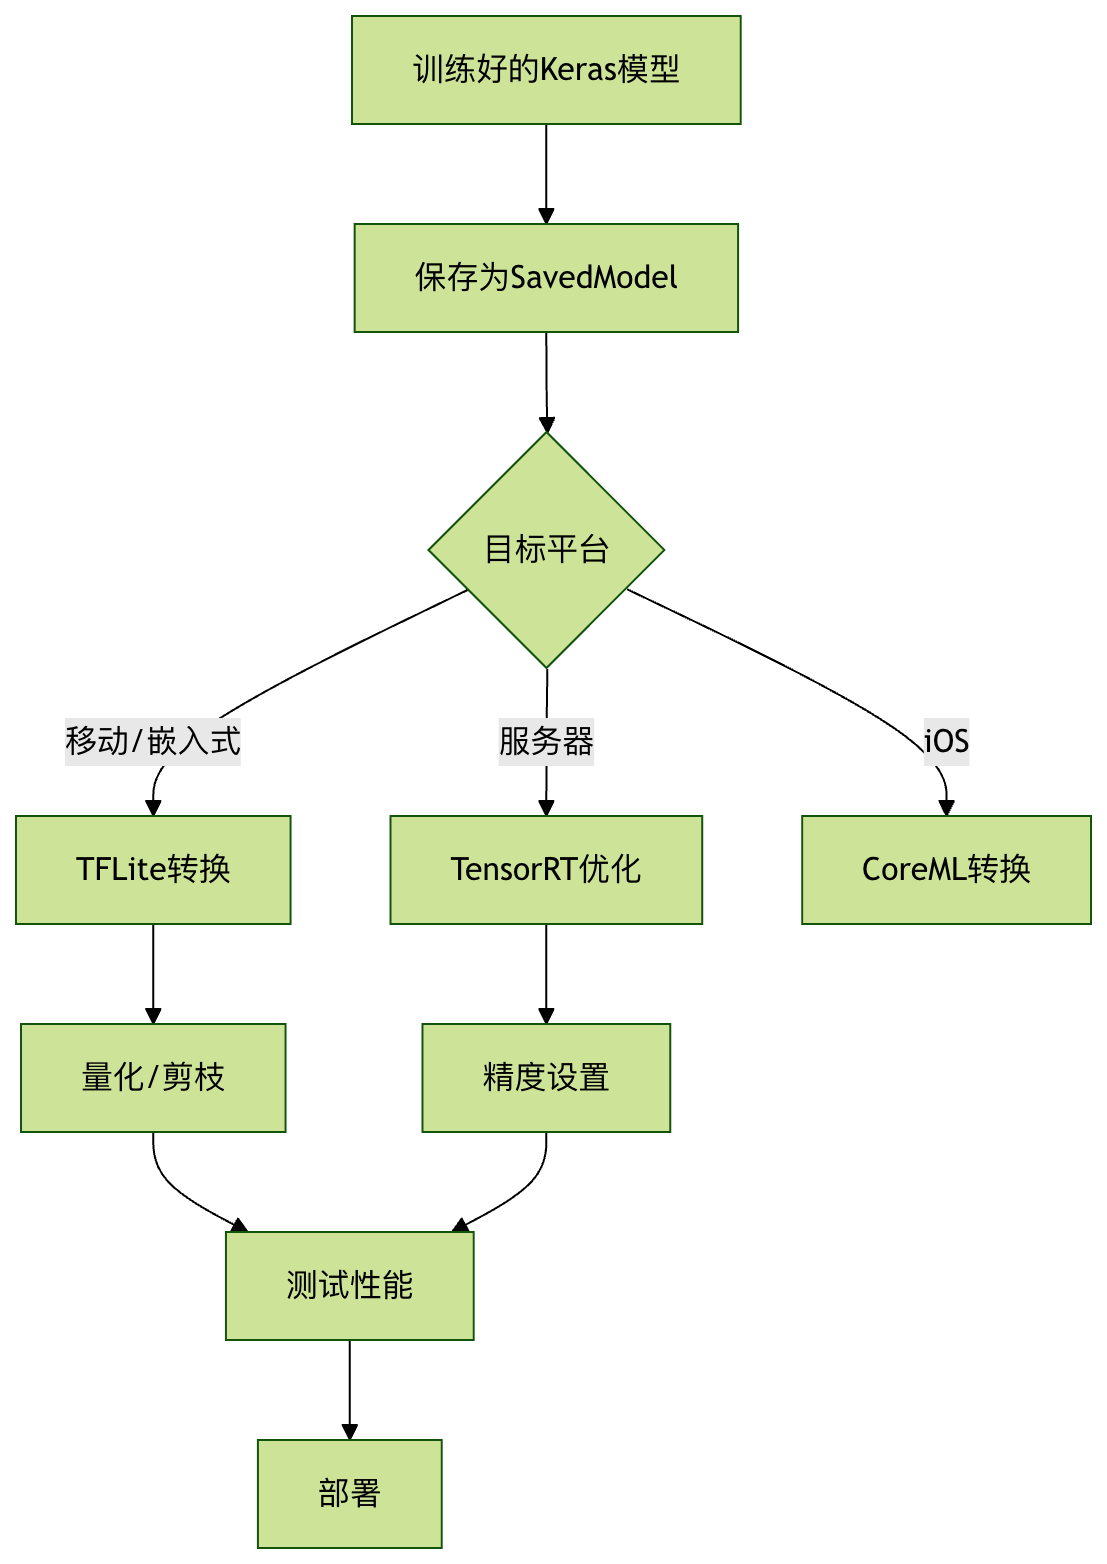
Flux de conversion et d'optimisation
Dépannage des problèmes courants
La précision chute trop
- Essayez la quantification mixte (conservez certaines couches en FP32)
- Utilisez l'entraînement prenant en compte la quantification (QAT)
Le modèle converti ne peut pas s'exécuter
- Vérifiez la compatibilité des opérations (certaines opérations peuvent ne pas être prises en charge par la plateforme cible)
- Mettez à jour les versions de TensorFlow et du convertisseur
L'amélioration des performances n'est pas évidente
- Assurez-vous que les options d'optimisation sont correctement définies
- Demandez-vous si l'architecture du modèle elle-même convient au matériel cible