TensorFlow tf.data API
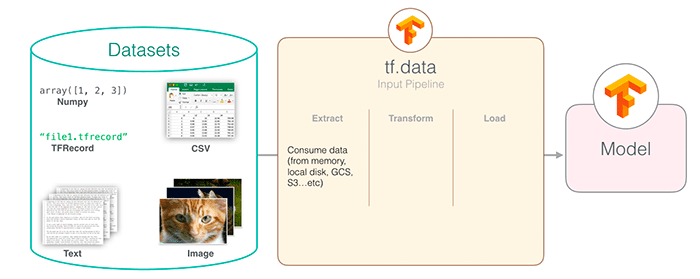
TensorFlow tf.data API es una herramienta eficiente de construcción de canalizaciones de entrada de datos proporcionada por TensorFlow, especialmente diseñada para manejar conjuntos de datos a gran escala.
La API tf.data resuelve los problemas de cuellos de botella de rendimiento en los métodos tradicionales de carga de datos, permitiendo que el preprocesamiento de datos y el entrenamiento del modelo se ejecuten en paralelo.
¿Por qué necesitas tf.data API?
- Ventajas de rendimiento: 10-100 veces más rápido que los métodos tradicionales
- Eficiencia de memoria: admite procesamiento en streaming de conjuntos de datos muy grandes
- Flexibilidad: operaciones de transformación de datos componibles
- Facilidad de uso: interfaz sencilla de llamadas encadenadas
Conceptos clave
Objeto Dataset
Dataset es la abstracción central de la API tf.data, que representa una secuencia de elementos, donde cada elemento contiene uno o más tensores.
Tres formas principales de crear un Dataset
1. Crear desde datos en memoria
Ejemplo
2. Crear desde archivos
Ejemplo
3. Crear desde un generador
Ejemplo
for i in range(10):
yield i
dataset = tf.data.Dataset.from_generator(gen, output_types=tf.int32)
Operaciones de transformación de datos
| Tipo de operación | Métodos comunes | Descripción |
|---|---|---|
| Transformación de un solo elemento | map, filter |
Procesa cada elemento individualmente |
| Transformación de múltiples elementos | batch, window |
Operaciones que involucran múltiples elementos |
| Transformación global | shuffle, repeat |
Afecta el comportamiento de todo el conjunto de datos |
Explicación detallada de operaciones clave
1. Operación map
mapEs la operación de transformación más utilizada, se usa para aplicar una función personalizada a cada elemento.
Ejemplo
dataset = dataset.map(lambda x: x**2)
# Uso típico para procesar datos de imágenes
def process_image(image_path):
img = tf.io.read_file(image_path)
img = tf.image.decode_jpeg(img, channels=3)
img = tf.image.resize(img, [256, 256])
return img
image_dataset = image_dataset.map(process_image)
Mejores prácticas:
- Usar el
num_parallel_callsparámetro para habilitar el procesamiento en paralelo - Para operaciones intensivas en CPU, establezca
tf.data.experimental.AUTOTUNE
2. Operación batch
Combina múltiples elementos en un lote.
Ejemplo
batched_dataset = dataset.batch(32)
# Relleno de lotes para secuencias de longitud variable
padded_batch = dataset.padded_batch(
32,
padded_shapes=([None], []),
padding_values=(0.0, 0)
)
3. Operación shuffle
Baraja el orden de los datos, es crucial para el entrenamiento.
Ejemplo
shuffled = dataset.shuffle(buffer_size=10000)
# Mejor práctica: buffer_size debe ser >= tamaño del conjunto de datos
full_shuffle = dataset.shuffle(buffer_size=len(dataset))
Consejos de optimización de rendimiento
Prefech (Prebúsqueda)
Permite que la carga de datos y la ejecución del modelo se superpongan:
Ejemplo
Procesamiento en paralelo
Ejemplo
process_func,
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
Mecanismo de caché
Ejemplo
dataset = dataset.cache()
# Caché en archivo
dataset = dataset.cache(filename='/tmp/cache')
Ejemplo completo
Canalización de datos para clasificación de imágenes
Ejemplo
dataset = tf.data.Dataset.list_files(file_pattern)
if is_training:
dataset = dataset.shuffle(10000)
dataset = dataset.map(
lambda x: load_and_preprocess_image(x),
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
dataset = dataset.batch(batch_size)
if is_training:
dataset = dataset.repeat()
return dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)
def load_and_preprocess_image(path):
image = tf.io.read_file(path)
image = tf.image.decode_jpeg(image, channels=3)
image = tf.image.resize(image, [224, 224])
image = tf.cast(image, tf.float32) / 255.0 # Normalización
return image
Preguntas frecuentes
Q1: ¿Cómo manejar conjuntos de datos muy grandes?
Solución:
- Usar
tf.data.Dataset.list_filespara crear conjuntos de datos de archivos - Usar lectura entrelazada (
interleave) para procesar múltiples archivos en paralelo - Considerar usar el formato TFRecord para almacenar datos
Q2: ¿Por qué mi canalización de datos es tan lenta?
Pasos de solución de problemas:
- Comprobar si se está usando prefetch (
prefetch) - Asegurarse de que la operación map tenga configurado
num_parallel_calls - Verificar si el buffer_size de shuffle es lo suficientemente grande
- Considerar usar
tf.data.experimental.snapshotel almacenamiento en caché de resultados intermedios
Resumen de mejores prácticas
- Aplicar shuffle temprano: aplicar shuffle en las primeras etapas de la canalización de datos
- Retrasar el agrupamiento en lotes: realizar el agrupamiento en lotes después de aplicar map
- Aprovechar el paralelismo: usar operaciones paralelas siempre que sea posible
- Ejecución superpuesta: usar prefetch para superponer la carga de datos y la ejecución del modelo
- Cachear de forma razonable: cachear los datos que no cambian
Siguiendo estos principios, puede construir canalizaciones de entrada de datos eficientes, aprovechar al máximo la capacidad de cómputo de la GPU y mejorar significativamente la eficiencia del entrenamiento del modelo.
Otras extensiones