Ejemplo de TensorFlow - Problema de regresión
¿Qué es un problema de regresión?
El problema de regresión es una clase importante de problemas en el aprendizaje automático, cuyo objetivo es predecir salidas de valores continuos. A diferencia de los problemas de clasificación (que predicen categorías discretas), los problemas de regresión predicen valores numéricos en el rango de los números reales.
Ejemplos comunes de problemas de regresión
- Predicción de precios de vivienda: predecir el precio según características como el área y la ubicación de la casa
- Predicción de acciones: predecir el precio futuro de las acciones según datos históricos
- Predicción de temperatura: predecir la temperatura futura según datos meteorológicos
Flujo básico de TensorFlow para resolver problemas de regresión
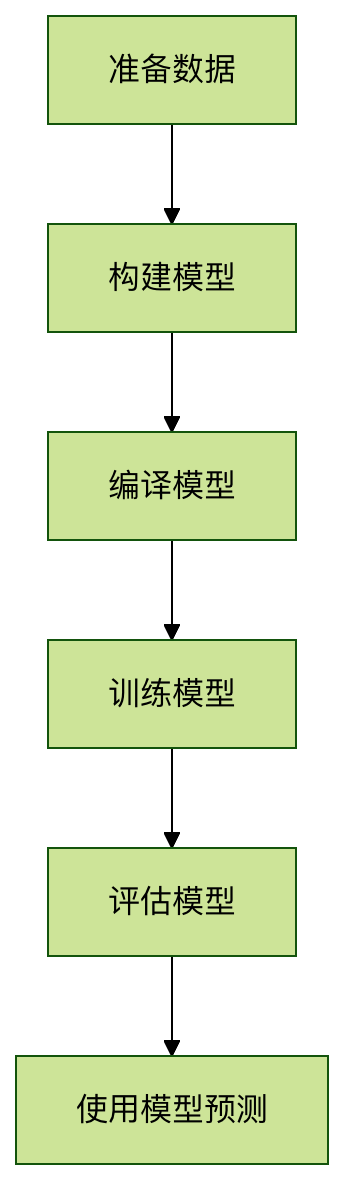
Práctica: Predicción de precios de viviendas en Boston
1. Preparar los datos
Usaremos el clásico conjunto de datos de precios de viviendas de Boston, que contiene 506 muestras, cada una con 13 características:
Ejemplo
from tensorflow.keras.datasets import boston_housing
# Cargar datos
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Estandarización de datos (paso importante)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
# Cargar datos
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Estandarización de datos (paso importante)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
2. Construir el modelo
Ejemplo
from tensorflow.keras import models
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # La capa de salida no necesita función de activación
])
return model
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # La capa de salida no necesita función de activación
])
return model
Descripción de la estructura del modelo
- Capa de entrada: corresponde a 13 características
- Dos capas ocultas: 64 neuronas por capa, usando función de activación ReLU
- Capa de salida: 1 neurona (predicción del precio de la vivienda), sin función de activación
3. Compilar el modelo
Ejemplo
model = build_model()
model.compile(optimizer='rmsprop',
loss='mse', # Error cuadrático medio
metrics=['mae']) # Error absoluto medio
model.compile(optimizer='rmsprop',
loss='mse', # Error cuadrático medio
metrics=['mae']) # Error absoluto medio
Explicación de parámetros clave
- optimizer: optimizador, controla el proceso de aprendizaje
rmsprop: opción predeterminada adecuada para la mayoría de los problemas
- loss: función de pérdida, común en problemas de regresión
mse(Mean Squared Error): Error cuadrático medio
- metrics: métrica de evaluación
mae(Mean Absolute Error): Error absoluto medio
4. Entrenar el modelo
Ejemplo
history = model.fit(train_data, train_targets,
epochs=100,
batch_size=16,
validation_split=0.2)
epochs=100,
batch_size=16,
validation_split=0.2)
Explicación de parámetros
epochs: número de épocas de entrenamientobatch_size: tamaño del lote de datosvalidation_split: proporción del conjunto de validación
5. Evaluar el modelo
Ejemplo
# Evaluar en el conjunto de prueba
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE del conjunto de prueba: {test_mae_score}")
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE del conjunto de prueba: {test_mae_score}")
Interpretación de las métricas de evaluación
- MAE (Error absoluto medio): promedio de la diferencia entre los valores predichos y los valores reales
- Por ejemplo, MAE=2.5 significa que la desviación promedio de la predicción es de 25,000 dólares
- MSE (Error cuadrático medio): otorga un mayor castigo a los errores grandes
6. Usar el modelo para predecir
Ejemplo
# Predecir nuevos datos
sample = test_data[0] # Tomar la primera muestra del conjunto de prueba
prediction = model.predict(sample.reshape(1, -1))
print(f"Precio predicho: {prediction)
sample = test_data[0] # Tomar la primera muestra del conjunto de prueba
prediction = model.predict(sample.reshape(1, -1))
print(f"Precio predicho: {prediction)
Técnicas de optimización del modelo
1. Ajustar la estructura de la red
Ejemplo
# Una red más profunda puede funcionar mejor
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
2. Usar validación cruzada de K pliegues
Ejemplo
from sklearn.model_selection import KFold
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Dividir el conjunto de entrenamiento y el de validación
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Entrenar y evaluar el modelo
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"MAE de validación: {val_mae}")
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Dividir el conjunto de entrenamiento y el de validación
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Entrenar y evaluar el modelo
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"MAE de validación: {val_mae}")
3. Agregar regularización para prevenir el sobreajuste
Ejemplo
from tensorflow.keras import regularizers
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
Preguntas frecuentes y soluciones
Problema 1: El rendimiento del modelo es inestable
- Causa: pequeña cantidad de datos o aleatoriedad en la inicialización
- Solución: aumentar la cantidad de datos o usar validación cruzada de K pliegues
Problema 2: El error de entrenamiento es bajo pero el error de prueba es alto
- Causa: sobreajuste
- Solución: agregar capa Dropout o regularización L2
Problema 3: Los valores predichos se desvían mucho de los valores reales
- Causa: datos no estandarizados o estructura de red irrazonable
- Solución: revisar los pasos de preprocesamiento de datos y ajustar la profundidad y el ancho de la red