NLP-Einführung
Natural Language Processing (NLP)ist ein interdisziplinäres Feld, das Informatik, künstliche Intelligenz und Linguistik kombiniert und sich darauf konzentriert, Computer in die Lage zu versetzen, menschliche natürliche Sprache zu verstehen, zu verarbeiten und zu erzeugen.
Kernziele:
- Verstehen: Computer in die Lage versetzen, die Bedeutung menschlicher Sprache zu verstehen
- Verarbeitung: Analysieren, Transformieren und Manipulieren von Text und Sprache
- Generierung: Computer in die Lage versetzen, natürliche, fließende menschliche Sprache zu erzeugen
Merkmale natürlicher Sprache
Menschliche Sprache weist die folgenden einzigartigen Merkmale auf, die NLP zu einem äußerst anspruchsvollen Bereich machen:
1. Mehrdeutigkeit
- Lexikalische Mehrdeutigkeit: Ein Wort hat mehrere Bedeutungen
- Beispiel: "bank" kann sich auf ein Finanzinstitut oder ein Flussufer beziehen
- Syntaktische Ambiguität: Die grammatische Struktur eines Satzes kann mehrere Interpretationen haben
- Beispiel: "Ich sah die Person mit dem Teleskop" (hält die Person das Teleskop, oder benutzte ich das Teleskop, um die Person zu sehen?)
- Semantische Ambiguität: Die Gesamtbedeutung des Satzes ist unklar
- Beispiel: "Sie kauften Äpfel" (ist es die Frucht oder die Produkte von Apple Inc.?)
2. Kontextabhängigkeit
- Dasselbe Wort oder derselbe Satz hat in unterschiedlichen Kontexten unterschiedliche Bedeutungen
- Beispiel: "cool" in "Diese Idee ist sehr cool" bedeutet großartig, während "Heute ist es kühl" kühl (Temperatur) bedeutet
3. Innovation und Variabilität
- Sprache entwickelt sich ständig weiter, wobei neue Vokabeln und neue Ausdrücke in rascher Folge entstehen
- Schnelle Verbreitung von Internet-Slang und Schlagwörtern
- Beispiel: von "Give力" (geili/awesome) bis "yyds" (永farof神, was "ewiger Gott" bedeutet)
4. Kultureller und sozialer Hintergrund
- Sprache trägt tiefgreifende kulturelle Konnotationen
- Dieselbe Sprache weist in verschiedenen Regionen dialektale Unterschiede auf
- Beispiel: Im Chinesischen ist „eatalready吗?“ (Hast du schon gegessen?) nicht nur eine Frage, sondern auch eine Form der Begrüßung
5. Nichtstandardisierung
- Umgangssprachliche Ausdrücke, Abkürzungen, Tippfehler
- Nicht standardkonforme Grammatik, unvollständige Sätze
- Beispiel: informelle Ausdrücke in Weibo und Chatprotokollen
Kernaufgaben von NLP
1. Grundlegende Aufgaben
- Tokenisierung: Aufteilung von Text in bedeutungstragende Einheiten
- Part-of-Speech-Tagging (POS-Tagging): Bestimmung der grammatischen Kategorie jedes Wortes
- Syntaktisches Parsing (Parsing): Analyse der grammatischen Struktur von Sätzen
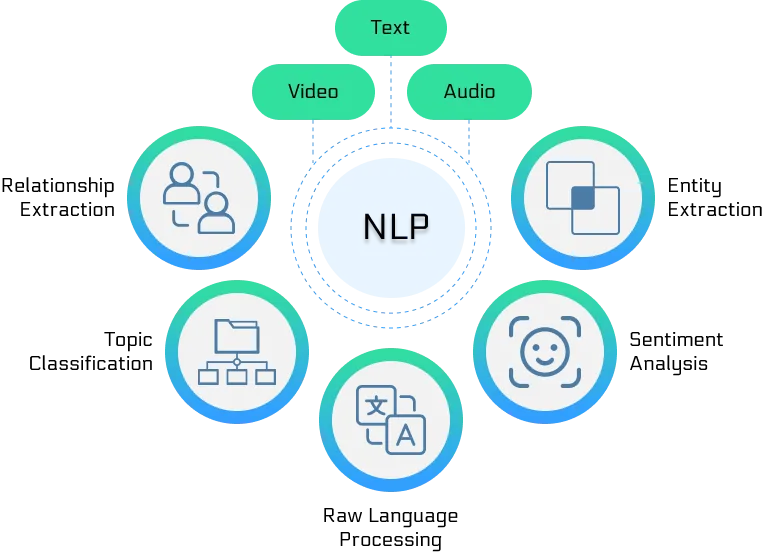
- Named-Entity-Recognition (NER): Erkennung von Personennamen, Ortsnamen, Organisationsnamen usw.
2. Verstehensaufgaben
- Semantische Rollenmarkierung: Identifizierung semantischer Beziehungen in Sätzen
- Koreferenzauflösung: Bestimmung verschiedener Ausdrücke im Text, die sich auf dieselbe Entität beziehen
- Relationsextraktion: Identifizierung semantischer Beziehungen zwischen Entitäten
- Ereignisextraktion: Extraktion von Ereignisinformationen aus Text
3. Anwendungsaufgaben
- Textklassifikation: Kategorisierung von Text in vordefinierte Kategorien
- Sentimentanalyse: Bestimmung der Stimmungstendenz von Text
- Maschinelle Übersetzung: Übersetzung von einer Sprache in eine andere
- Textzusammenfassung: Erzeugung prägnanter Zusammenfassungen von Text
- Frage-Antwort-Systeme: Abrufen oder Generieren von Antworten auf der Grundlage von Fragen
Die Entwicklungsgeschichte des NLP
Phase 1: Die Ära der regelbasierten Methoden (1950er-1980er Jahre)
Merkmale:
- Basierend auf manuell formulierten grammatischen Regeln und Wissensbasen
- Expertensystem-Methoden waren dominierend
- Begrenzte Verarbeitungskapazitäten, aber gute Leistung in spezifischen Domänen
Repräsentative Arbeiten:
- 1950- Der Turing-Test wurde vorgeschlagen und legte den Grundstein für die Bewertung maschineller Intelligenz
- 1954- Das Georgetown-IBM-Experiment, der erste Versuch der maschinellen Übersetzung
- 1960s- Der ELIZA-Chatbot, der Mustererkennungstechnologie verwendet
- 1970s- Die Entwicklung von Parsern wie ATN (Augmented Transition Network)
Typische Systeme:
- SHRDLU(1970): Verstehen und Ausführen natürlicher Sprachbefehle in der Blocks-Welt
- LUNAR(1972): Beantwortung von Fragen zu Mondgestein
Einschränkungen:
- Begrenzte Regelabdeckung, was die Handhabung der Komplexität der Sprache erschwert
- Hohe Wartungskosten und schlechte Skalierbarkeit
- Mehrdeutigkeiten und Ausnahmefälle lassen sich nicht gut behandeln
Phase 2: Die Ära der statistischen Methoden (1980er- bis 2010er-Jahre)
Merkmale:
- Statistische Lernmethoden auf Basis großer Korpora
- Breite Anwendung von Algorithmen des maschinellen Lernens
- Datengetriebene Methodik
Wichtige technologische Entwicklungen:
1980er- bis 1990er-Jahre: Der Aufstieg statistischer Methoden
- Hidden-Markov-Modelle (HMM): verwendet für Part-of-Speech-Tagging und Spracherkennung
- Probabilistische kontextfreie Grammatiken (PCFG): verwendet für syntaktisches Parsing
- Statistische maschinelle Übersetzung: basierend auf Phrasen- und Satzausrichtung
2000er Jahre: Die Reifung der Methoden des maschinellen Lernens
- Support-Vektor-Maschinen (SVM): hervorragende Leistung bei der Textklassifikation
- Conditional Random Fields (CRF): verwendet für Sequenzmarkierungsaufgaben
- Naive Bayes: eine einfache und effektive Klassifikationsmethode
- Maximum-Entropie-Modelle: Umgang mit Multi-Feature-Problemen
Wichtige Meilensteine:
- 1988- Der Brown Corpus wurde veröffentlicht, was die Entwicklung der statistischen NLP vorantrieb
- 1993- Die Penn Treebank wurde veröffentlicht und lieferte Standarddaten für syntaktisches Parsing
- 2000- WordNet wurde veröffentlicht und bot ein groß angelegtes lexikalisch-semantisches Netzwerk
- 2005- Google veröffentlichte ein statistisches maschinelles Übersetzungssystem
Vorteile:
- Kann umfangreiche reale Texte verarbeiten
- Verfügt über ein gewisses Maß an Generalisierungsfähigkeit
- Kann automatisch Muster aus Daten lernen
Einschränkungen:
- Erfordert große Mengen annotierter Daten
- Hoher Aufwand für Feature Engineering
- Tiefe semantische Informationen sind schwer zu erfassen
Phase 3: Die Ära des Deep Learning (2010er-2020er Jahre)
Merkmale:
- Die Wiederbelebung und Entwicklung neuronaler Netzwerkmodelle
- End-to-End-Lernmethoden
- Durchbrüche beim Repräsentationslernen
Wichtige technologische Entwicklungen:
Frühe 2010er Jahre: Die Wiederbelebung neuronaler Netzwerke
- 2010- Die Anwendung rekurrenter neuronaler Netzwerke (RNN) in der Sprachmodellierung
- 2013- Word2Vec wurde veröffentlicht, ein Durchbruch bei Wortvektordarstellungen
- 2014- Sequence-to-Sequence-Modelle, eine Revolution in der maschinellen Übersetzung
Mitte der 2010er-Jahre: Der Attention-Mechanismus
- 2015- Der Vorschlag und die Anwendung des Attention-Mechanismus
- 2016- Neuronale maschinelle Übersetzung erreichte ein praktisches Niveau
- 2017- Die Transformer-Architektur wurde veröffentlicht, "Attention is All You Need"
Ende der 2010er-Jahre: Vortrainierte Modelle
- 2018- BERT veröffentlicht, ein Durchbruch beim bidirektionalen Vortraining
- 2019- GPT-2 veröffentlicht, großskaliges generatives Modell
- 2020- GPT-3 wurde veröffentlicht und demonstrierte erstaunliche Sprachfähigkeiten
Wichtige Durchbrüche:
- Wortvektor-Technologie:Word2Vec, GloVe, FastText
- Sequenzmodelle: LSTM, GRU, bidirektionales RNN
- Aufmerksamkeitsmechanismus: löst Probleme mit langen Sequenzabhängigkeiten
- Transformer-Architektur: parallelisiertes Training, deutlich verbesserte Leistung
- Vortrainierte Modelle: BERT, GPT-Serie, allgemeines Sprachverständnis
Phase 4: Die Ära der großen Sprachmodelle (2020er Jahre bis heute)
Merkmale:
- Rasantes Wachstum der Modellgröße
- Der Beginn der allgemeinen künstlichen Intelligenz
- Fähigkeiten zum Few-Shot- und Zero-Shot-Lernen
Wichtige Entwicklungen:
- 2020- GPT-3 (175 Milliarden Parameter) zeigte starke Few-Shot-Lernfähigkeiten
- 2021- PaLM (540 Milliarden Parameter) erreichte neue Höhen bei mehreren Aufgaben
- 2022- ChatGPT veröffentlicht, was einen KI-Anwendungsboom auslöste
- 2023- GPT-4 veröffentlicht, deutlich verbesserte multimodale Fähigkeiten
- 2024 bis heute- Aufstieg von Konkurrenten wie Claude und Gemini
Technische Merkmale:
- Skalierungseffekte: Anzahl der Modellparameter wuchs von Hunderten Millionen auf Billionen
- Emergente Fähigkeiten: Modelle zeigen unerwartete Fähigkeiten, nachdem sie eine bestimmte Skala erreicht haben
- Multimodale Fusion: einheitliche Verarbeitung von Text, Bildern und Audio
- Instruktionsbefolgung: Verbesserung der Steuerbarkeit von Modellen durch Instruktions-Fine-Tuning
Hauptanwendungsgebiete von NLP

Maschinelle Übersetzung
Entwicklungsgeschichte:
- Statistische maschinelle Übersetzung (SMT): basierend auf Phrasen-Alignment und statistischen Modellen
- Neuronale maschinelle Übersetzung (NMT): End-to-End-Ansätze neuronaler Netze
- Übersetzung durch große Modelle: Übersetzungsfähigkeiten, die von großen Modellen wie GPT-3/4 demonstriert werden
Technische Herausforderungen:
- Unterschiede zwischen Sprachpaaren
- Kontextverständnis und -bewahrung
- Terminologieübersetzung in Fachgebieten
- Sprachstil und kulturelle Anpassung
Anwendungsbeispiele:
- Google Translate, Baidu Translate
- Echtzeit-Sprachübersetzung
- Dokumentenübersetzungsdienste
- Sprachübergreifende Informationssuche
Suchmaschinen und Information Retrieval
Kerntechnologien:
- Query-Verständnis: Verstehen der Suchabsicht des Nutzers
- Dokumenten-Ranking: Ranking der Suchergebnisse nach Relevanz
- Semantisches Matching: Berechnung der semantischen Ähnlichkeit über Schlüsselwörter hinaus
- Personalisierte Empfehlung: basierend auf Nutzerhistorie und -präferenzen
Technologische Entwicklung:
- Vom Keyword-Matching zum semantischen Verständnis
- Vom statischen Ranking zur dynamischen Personalisierung
- Von der Textsuche zur multimodalen Suche
Repräsentative Systeme:
- RankBrain-Algorithmus in der Google-Suche
- Baidus ERNIE in der Suche eingesetzt
- Bing Chats konversationelle Suche
Intelligenter Kundenservice und Dialogsysteme
Systemtypen:
- Aufgabenorientiert: Erledigung spezifischer Aufgaben (Ticketbuchung, Abfragen usw.)
- Small Talk: Führen von Gesprächen in offenen Domänen
- Hybrid: Kombination von Aufgabenerledigung und Small-Talk-Funktionen
Schlüsseltechnologien:
- Absichtserkennung: Verstehen der wahren Absicht des Nutzers
- Slot-Filling: Extrahieren wichtiger aufgabenbezogener Informationen
- Dialogmanagement: Steuerung des Dialogflusses und -zustands
- Antwortgenerierung: Generieren natürlicher und relevanter Antworten
Anwendungsszenarien:
- Intelligenter Kundenservice im Bankwesen und E-Commerce
- Smarte Lautsprecher (Alexa, Siri)
- Chatbots
- Virtuelle Assistenten
Textanalyse und Sentimentanalyse
Aufgaben der Textanalyse:
- Themenklassifikation: Klassifizierung von Dokumenten in Themenkategorien
- Schlüsselwortextraktion: Identifizierung des Kernvokabulars von Dokumenten
- Text-Clustering: Gruppierung ähnlicher Dokumente
- Trendanalyse: Analyse zeitlicher Veränderungen im Textinhalt
Ebenen der Sentimentanalyse:
- Dokumentebene: Gesamtsentiment eines gesamten Dokuments
- Satzebene: Sentimentorientierung jedes Satzes
- Aspektebene: Sentiment gegenüber bestimmten Aspekten
- Feingranular: Intensität und Komplexität der Stimmung
Geschäftliche Anwendungen:
- Social-Media-Monitoring
- Analyse von Produktbewertungen
- Markenreputationsmanagement
- Stimmungsindikatoren des Aktienmarkts
Informationsextraktion
Extraktionsaufgaben:
- Erkennung benannter Entitäten: Personennamen, Ortsnamen, Organisationsnamen usw.
- Relationsextraktion: semantische Beziehungen zwischen Entitäten
- Ereignisextraktion: Teilnehmer, Zeit, Ort usw. von Ereignissen
- Attributsextraktion: charakteristische Attribute von Entitäten
Technische Ansätze:
- Regelbasierter Musterabgleich
- Überwachte Lernmethoden
- Fernüberwachung und schwache Überwachung
- Feinabstimmung vortrainierter Modelle
Anwendungswert:
- Konstruktion von Wissensgraphen
- Intelligente Frage-Antwort-Systeme
- Überwachung von Nachrichtenereignissen
- Finanzrisikoanalyse
Automatische Zusammenfassung
Arten der Zusammenfassung:
- Extraktive Zusammenfassung: Auswahl wichtiger Sätze aus dem Originaltext
- Abstraktive Zusammenfassung: Generierung neuen Zusammenfassungstextes
- Hybride Zusammenfassung: Kombination extraktiver und generativer Methoden
Technische Herausforderungen:
- Identifikation wichtiger Informationen
- Kohärenz und Lesbarkeit von Zusammenfassungen
- Konsistenz bei der Multidokumentzusammenfassung
- Steuerung der Länge der Zusammenfassung
Anwendungsszenarien:
- Nachrichtenzusammenfassung
- Abstracts wissenschaftlicher Arbeiten
- Zusammenfassung juristischer Dokumente
- Erstellung von Besprechungsprotokollen
Zentrale Herausforderungen für NLP
Mehrdeutigkeit der Sprache
Lexikalische Ambiguität
- Polysemie:
- "打" (dǎ): schlagen, kaufen, einschalten, usw.
- "行" (xíng/háng): in Ordnung / Bank / gehen, usw.
- Homophone:
- Chinesisch: Verwendung von "的, 地, 得"
- Englisch: "there, their, they're"
Syntaktische Ambiguität
- Unklare Modifikationsbeziehungen:
- "美丽of花儿of香味" (Ist die Blume schön oder der Duft schön?)
- Mehrere strukturelle Analysen:
- Ich sah das Mädchen, das einen Regenschirm hielt
Semantische Ambiguität
- Unklare Referenz:
- "Li Ming sagte zu Zhang Hua, dass er sehr klug sei" (Wer ist klug?)
- Skopus-Ambiguität:
- Alle Studenten mögen diesen Lehrer nicht
Lösungen:
- Nutzung kontextueller Informationen
- Probabilistische Beurteilung von Sprachmodellen
- Unterstützung durch Wissensbasen
- Multi-Task-Lernen
Kontextverständnis
Lokaler Kontext
- Semantische Abhängigkeiten innerhalb eines Satzes
- Verständnis von Phrasen und Teilsätzen
- Semantische Beziehungen zwischen Wörtern
Globaler Kontext
- Semantische Kohärenz auf Absatz- und Dokumentebene
- Themenkontinuität
- Semantische Fernabhängigkeiten
Dialogkontext
- Historische Informationen in mehrstufigen Dialogen
- Schlussfolgern über implizite Informationen
- Entwicklung der Dialogabsicht
Technische Herausforderungen:
- FernabhängigkeitenHerkömmliche RNNs haben Schwierigkeiten, lange Sequenzen zu verarbeiten
- Semantische KohärenzBeibehaltung der logischen Konsistenz in generiertem Text
- Schlussfolgern mit gesundem MenschenverstandErfordert umfangreiches Hintergrundwissen
Lösungen:
- Aufmerksamkeitsmechanismen und Transformer
- Vortrainierte Sprachmodelle
- Wissenserweiterte Modelle
- Multimodale Informationsfusion
Kulturelle und sprachliche Unterschiede
Sprachübergreifende Herausforderungen
- Unterschiede zwischen Sprachfamilien:
- Sino-Tibetisch vs. Indogermanisch
- Reiche Morphologie vs. Bedeutung der Wortstellung
- Unterschiede bei Schriftsystemen:
- Unterschiedliche Zeichensatzgrößen
- Verschiedene Tokenisierungsmethoden
Kultureller Hintergrund
- Redewendungen und umgangssprachliche Ausdrücke:
- "Eine Schlange mit Beinen malen" vs "Man soll den Tag nicht vor dem Abend loben"
- Kulturspezifische Ausdrücke:
- Das chinesische Konzept von "Gesicht" (mianzi)
- Japanisches Honorativsystem
Soziolinguistische Faktoren
- Dialektale Unterschiede:
- Mandarin vs verschiedene regionale Dialekte
- Standardenglisch vs dialektales Englisch
- Registervariation:
- Formelle vs. informelle Sprachstile
- Gesprochene vs. geschriebene Sprache
Lösungsstrategien:
- Mehrsprachige vortrainierte Modelle
- Sprachübergreifendes Transferlernen
- Kulturelle Anpassung
- Lokalisierte Datenerfassung
Probleme mit Datenknappheit
Ressourcenarme Sprachen
- Weltweit gibt es über 7.000 Sprachen, aber nur wenige verfügen über umfangreiche digitale Ressourcen
- Erhalt und Erforschung bedrohter Sprachen
- Dialekte und Minderheitensprachen
Fachgebiete
- Terminologie in Fachgebieten wie Medizin und Recht
- Branchenspezifische Ausdrücke
- Schwierigkeit, annotierte Daten zu beschaffen
Aufstrebende Fachgebiete
- Neues Vokabular, das durch neue Technologien entsteht
- Neue Ausdrücke in sozialen Medien
- Neue Formen interkultureller Kommunikation
Entwicklung im Laufe der Zeit
- Historische Veränderungen der Sprache
- Schnelles Aufkommen neuer Wörter
- Allmähliche Bedeutungsverschiebungen
Lösungen:
- Transferlernen: Übertragung von ressourcenreichen auf ressourcenarme Sprachen
- Daten-Augmentierung: Erweiterung der Trainingsdaten durch verschiedene Techniken
- Few-Shot-Learning: Schnelle Anpassung mit einer kleinen Anzahl von Beispielen
- Unüberwachtes und selbstüberwachtes Lernen: Verringerung der Abhängigkeit von annotierten Daten
- Crowdsourcing-Annotation: Nutzung kollektiver Intelligenz zum Sammeln von Daten
- Synthetische Daten: Generierung von Trainingsdaten durch Regeln oder Modelle
Rechenkomplexität
Herausforderungen der Modellskalierung
- Explosives Wachstum der Parameteranzahl (GPT-3: 175 Milliarden Parameter)
- Schnell steigende Trainingskosten
- Inferenzlatenz und Ressourcenverbrauch
Echtzeitanforderungen
- Antworten auf Millisekundenebene für Suchmaschinen
- Echtzeit-Interaktion in Dialogsystemen
- Ressourcenbeschränkungen auf mobilen Geräten
Skalierbarkeitsprobleme
- Bewältigung massiver Nutzeranfragen
- Einheitliche Verarbeitung mehrerer Sprachen und Aufgaben
- Rechenanforderungen personalisierter Dienste
Herausforderungen bei Bewertung und Quantifizierung
Subjektivitätsprobleme
- Subjektive Beurteilung der Textqualität
- Kulturelle Unterschiede bei der Übersetzungsqualität
- Bewertungskriterien für kreatives Schreiben
Grenzen von Evaluationsmetriken
- Mängel bei Metriken wie BLEU und ROUGE
- Unterschiede zwischen automatischer Evaluation und menschlicher Evaluation
- Komplexität mehrdimensionaler Evaluation
Benchmark-Datensätze
- Repräsentativität von Datensätzen
- Kluft zwischen Evaluationsaufgaben und realen Anwendungen
- Aktualität und Aktualisierungen von Datensätzen
Zusammenfassung und Ausblick
Die Verarbeitung natürlicher Sprache hat als Kernzweig der künstlichen Intelligenz einen Entwicklungsprozess von regelbasiert über datengetrieben bis hin zu großmodellgetrieben durchlaufen. Jede Phase hat ihre eigenen technischen Merkmale und historischen Beiträge.
Aktueller Stand:
- Große Sprachmodelle zeigen erstaunliche Sprachverständnis- und Generierungsfähigkeiten
- Multimodale Fusion wird zu einer neuen Entwicklungsrichtung
- Anwendungsbereiche weiten sich weiter aus, und der kommerzielle Wert tritt zunehmend hervor
Zukünftige Trends:
- Allgemeine künstliche Intelligenz: Hin zu allgemeineren und intelligenteren KI-Systemen
- Multimodale Fusion: Umfassende Integration von Text, Vision und Audio
- Personalisierte Dienste: Präziseres personalisiertes Sprachverständnis und präzisere Sprachgenerierung
- Erklärbarkeit: Verbesserung der Transparenz von Entscheidungsprozessen der Modelle
- Effizienzoptimierung: Reduzierung der Rechenkosten bei gleichbleibender Leistung
- Ethik und Sicherheit: Gewährleistung von Fairness, Sicherheit und Kontrollierbarkeit von KI-Systemen
Lernempfehlungen:
Für NLP-Lernende wird empfohlen:
- Solide Grundlagen: Die Grundlagen der Linguistik und Informatik eingehend verstehen
- Praxisorientiert: Verständnis durch Projektpraxis vertiefen
- Aktuelle Forschungsfronten verfolgen: Achten Sie auf die neuesten technologischen Entwicklungen und Forschungstrends
- Interdisziplinäres Denken: Wissen aus Linguistik, Psychologie, Soziologie und anderen Disziplinen kombinieren
- Ingenieurstechnische Kompetenz: Die Fähigkeit entwickeln, Forschungsergebnisse in praktische Anwendungen umzusetzen
Die Zukunft der Verarbeitung natürlicher Sprache ist voller Chancen und Herausforderungen. Mit dem kontinuierlichen technologischen Fortschritt gibt es Grund zu der Annahme, dass die Fähigkeit von Maschinen, menschliche Sprache zu verstehen und zu erzeugen, sich weiter verbessern wird, was der menschlichen Gesellschaft mehr Komfort und Wert bringt.
Zusätzliche Erweiterungen