API tf.data de TensorFlow
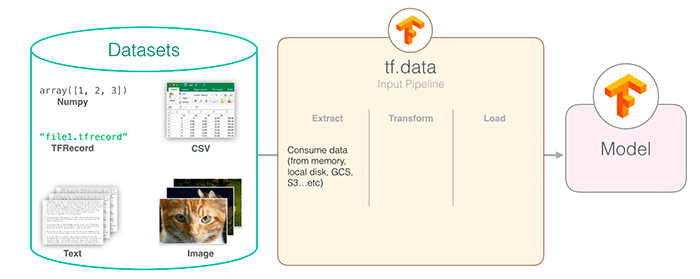
L'API TensorFlow tf.data est un outil efficace de construction de pipelines d'entrée de données fourni par TensorFlow, spécialement conçu pour gérer des jeux de données à grande échelle.
L'API tf.data résout les problèmes de goulot d'étranglement de performance des méthodes traditionnelles de chargement de données, permettant au prétraitement des données et à l'entraînement du modèle de s'exécuter en parallèle.
Pourquoi avons-nous besoin de l'API tf.data
- Avantages en matière de performances: 10-100x plus rapide que les méthodes traditionnelles
- Efficacité mémoire: prend en charge le traitement en flux de jeux de données très volumineux
- Flexibilité: opérations de transformation de données composables
- Facilité d'utilisation: interface API claire et chaînable
Concepts fondamentaux
Objet Dataset
Dataset est l'abstraction centrale de l'API tf.data, représentant une séquence d'éléments, où chaque élément contient un ou plusieurs tenseurs.
Trois principales façons de créer un Dataset
1. Créer à partir de données en mémoire
Exemple
2. Créer à partir de fichiers
Exemple
3. Créer à partir de générateurs
Exemple
for i in range(10):
yield i
dataset = tf.data.Dataset.from_generator(gen, output_types=tf.int32)
Opérations de transformation de données
| Type d'opération | Méthodes courantes | Description |
|---|---|---|
| Transformation à élément unique | map, filter |
Traiter chaque élément individuellement |
| Transformation multi-éléments | batch, window |
Opérations impliquant plusieurs éléments |
| Transformation globale | shuffle, repeat |
Affecte le comportement de l’ensemble du jeu de données |
Explication détaillée des opérations clés
1. Opération map
mapEst l’opération de transformation la plus couramment utilisée, servant à appliquer des fonctions personnalisées à chaque élément.
Exemple
dataset = dataset.map(lambda x: x**2)
# Utilisation typique pour le traitement des données d'image
def process_image(image_path):
img = tf.io.read_file(image_path)
img = tf.image.decode_jpeg(img, channels=3)
img = tf.image.resize(img, [256, 256])
return img
image_dataset = image_dataset.map(process_image)
Bonnes pratiques:
- Utilisez la
num_parallel_callsparamètre pour activer le traitement parallèle - Pour les opérations gourmandes en CPU, définissez
tf.data.experimental.AUTOTUNE
2. Opération batch
Combine plusieurs éléments en un lot.
Exemple
batched_dataset = dataset.batch(32)
# Remplissage par lots pour des séquences de longueurs inégales
padded_batch = dataset.padded_batch(
32,
padded_shapes=([None], []),
padding_values=(0.0, 0)
)
3. Opération de mélange
Mélange l'ordre des données, ce qui est crucial pour l'entraînement.
Exemple
shuffled = dataset.shuffle(buffer_size=10000)
# Bonne pratique : buffer_size doit être >= à la taille du jeu de données
full_shuffle = dataset.shuffle(buffer_size=len(dataset))
Conseils d'optimisation des performances
Préchargement
Faites chevaucher le chargement des données avec l'exécution du modèle :
Exemple
Parallélisation
Exemple
process_func,
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
Mécanisme de mise en cache
Exemple
dataset = dataset.cache()
# Cache de fichier
dataset = dataset.cache(filename='/tmp/cache')
Exemple complet
Pipeline de données de classification d'images
Exemple
dataset = tf.data.Dataset.list_files(file_pattern)
if is_training:
dataset = dataset.shuffle(10000)
dataset = dataset.map(
lambda x: load_and_preprocess_image(x),
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
dataset = dataset.batch(batch_size)
if is_training:
dataset = dataset.repeat()
return dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)
def load_and_preprocess_image(path):
image = tf.io.read_file(path)
image = tf.image.decode_jpeg(image, channels=3)
image = tf.image.resize(image, [224, 224])
image = tf.cast(image, tf.float32) / 255.0 # Normalisation
return image
FAQ
Q1: Comment gérer des jeux de données très volumineux ?
Solution:
- Utiliser
tf.data.Dataset.list_filespour créer un jeu de données de fichiers - Utilisez la lecture entrelacée (
interleave) pour traiter plusieurs fichiers en parallèle - Envisagez d'utiliser le format TFRecord pour stocker les données
Q2 : Pourquoi mon pipeline de données est-il lent ?
Étapes de dépannage:
- Vérifiez si prefetch (
prefetch) - Assurez-vous que l'opération map a défini
num_parallel_calls - Vérifiez que le buffer_size de shuffle est suffisamment grand
- Envisagez d'utiliser
tf.data.experimental.snapshotpour mettre en cache les résultats intermédiaires
Résumé des bonnes pratiques
- Mélangez tôt: Appliquez le shuffle tôt dans le pipeline de données
- Retardez le batching: Appliquez le batching après l'application de map
- Exploitez le parallélisme: Utilisez des opérations parallèles chaque fois que possible
- Chevauchez l'exécution: Utilisez prefetch pour chevaucher le chargement des données et l'exécution du modèle
- Mettez en cache judicieusement: Mettez en cache les données qui ne changent pas
En suivant ces principes, vous pouvez construire des pipelines d'entrée de données efficaces, exploiter pleinement la puissance de calcul du GPU et améliorer considérablement l'efficacité de l'entraînement du modèle.
Autres extensions