Exemples TensorFlow - Problèmes de régression
Qu'est-ce qu'un problème de régression ?
Les problèmes de régression constituent une classe importante de problèmes en apprentissage automatique dont l’objectif est de prédire des sorties à valeurs continues. Contrairement aux problèmes de classification (prédiction de catégories discrètes), les problèmes de régression prédisent des valeurs numériques dans l’intervalle des nombres réels.
Exemples courants de problèmes de régression
- Prédiction du prix des maisons : prédire le prix à partir de caractéristiques telles que la surface et l’emplacement de la maison
- Prédiction boursière : prédire les cours futurs des actions à partir de données historiques
- Prédiction de la température : prédire la température future à partir de données météorologiques
Flux de travail de base pour résoudre des problèmes de régression avec TensorFlow
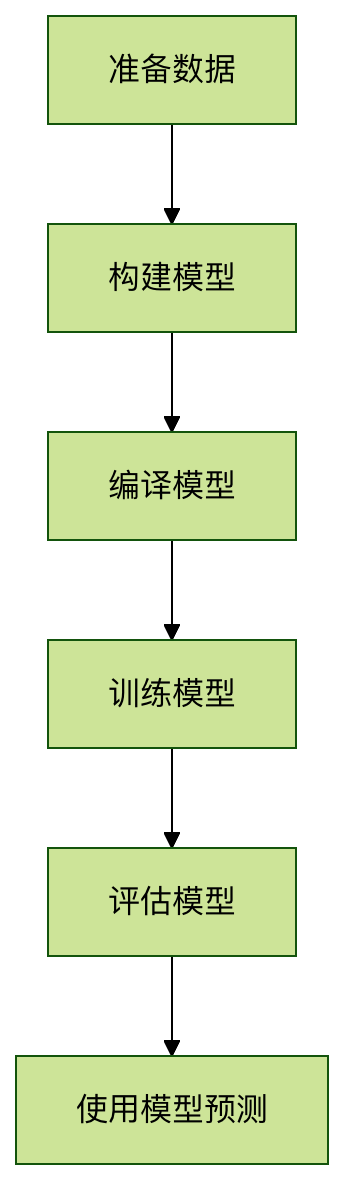
Mise en pratique : prédiction du prix des logements à Boston
1. Préparer les données
Nous utiliserons le jeu de données classique sur les prix des logements à Boston, qui contient 506 échantillons, chacun avec 13 caractéristiques :
Exemple
from tensorflow.keras.datasets import boston_housing
# Charger les données
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Standardisation des données (étape importante)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
# Charger les données
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Standardisation des données (étape importante)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
2. Construire le modèle
Exemple
from tensorflow.keras import models
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # La couche de sortie n'a pas besoin de fonction d'activation
])
return model
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # La couche de sortie n'a pas besoin de fonction d'activation
])
return model
Description de la structure du modèle
- Couche d'entrée : correspond à 13 caractéristiques
- Deux couches cachées : 64 neurones par couche, utilisant la fonction d'activation ReLU
- Couche de sortie : 1 neurone (prédit le prix du logement), sans fonction d'activation
3. Compiler le modèle
Exemple
model = build_model()
model.compile(optimizer='rmsprop',
loss='mse', # Erreur quadratique moyenne
metrics=['mae']) # Erreur absolue moyenne
model.compile(optimizer='rmsprop',
loss='mse', # Erreur quadratique moyenne
metrics=['mae']) # Erreur absolue moyenne
Description des paramètres clés
- optimizer: optimiseur, contrôle le processus d'apprentissage
rmsprop: choix par défaut adapté à la plupart des problèmes
- loss: fonction de perte, couramment utilisée dans les problèmes de régression
mse(Erreur quadratique moyenne): Erreur quadratique moyenne
- metrics: métrique d'évaluation
mae(Erreur absolue moyenne): Erreur absolue moyenne
4. Entraîner le modèle
Exemple
history = model.fit(train_data, train_targets,
époques=100,
batch_size=16,
validation_split=0.2)
époques=100,
batch_size=16,
validation_split=0.2)
Explication des paramètres
epochs: nombre d'époques d'entraînementbatch_size: taille du lotvalidation_split: proportion de validation
5. Évaluer le modèle
Exemple
# Évaluer sur l'ensemble de test
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE sur l'ensemble de test : {test_mae_score}")
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE sur l'ensemble de test : {test_mae_score}")
Comprendre les métriques d'évaluation
- MAE (Mean Absolute Error): la différence moyenne entre les valeurs prédites et réelles
- Par exemple, MAE=2.5 signifie que la prédiction s'écarte en moyenne de $25,000
- MSE (Mean Squared Error): pénalise davantage les erreurs plus importantes
6. Utiliser le modèle pour la prédiction
Exemple
# Faire des prédictions sur de nouvelles données
sample = test_data[0] # Prendre le premier échantillon de l'ensemble de test
prediction = model.predict(sample.reshape(1, -1))
print(f"Prix prédit : {prediction)
sample = test_data[0] # Prendre le premier échantillon de l'ensemble de test
prediction = model.predict(sample.reshape(1, -1))
print(f"Prix prédit : {prediction)
Techniques d'optimisation de modèle
1. Ajuster la structure du réseau
Exemple
# Un réseau plus profond peut être plus performant
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
2. Utiliser la validation croisée K-fold
Exemple
from sklearn.model_selection import KFold
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Diviser en ensembles d'entraînement et de validation
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Entraîner et évaluer le modèle
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"MAE de validation : {val_mae}")
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Diviser en ensembles d'entraînement et de validation
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Entraîner et évaluer le modèle
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"MAE de validation : {val_mae}")
3. Ajouter une régularisation pour éviter le surapprentissage
Exemple
from tensorflow.keras import regularizers
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
Problèmes courants et solutions
Problème 1 : La performance du modèle est instable
- Cause: petite quantité de données ou caractère aléatoire dans l'initialisation
- Solution: augmenter la quantité de données ou utiliser la validation croisée K-fold
Problème 2 : faible erreur d'entraînement mais erreur de test élevée
- Cause: surapprentissage
- Solution: ajouter une couche Dropout ou une régularisation L2
Problème 3 : les valeurs prédites s'écartent fortement des valeurs réelles
- Cause: données non standardisées ou structure de réseau déraisonnable
- Solution: vérifier les étapes de prétraitement des données, ajuster la profondeur et la largeur du réseau