Traitement des données et pipelines TensorFlow
Le pipeline de traitement des données TensorFlow est un élément clé du flux de travail d'apprentissage automatique. Il est chargé de charger, prétraiter et transférer efficacement les données vers le modèle.
Par rapport aux méthodes traditionnelles de chargement direct des données, le pipeline TensorFlow offre trois avantages majeurs :
- Optimisation des performances: Réduire les goulots d'étranglement d'E/S grâce à la parallélisation et au prefetching
- Efficacité mémoire: Éviter de charger toutes les données en mémoire en une seule fois
- Code propre: Découpler la logique de traitement des données du code du modèle
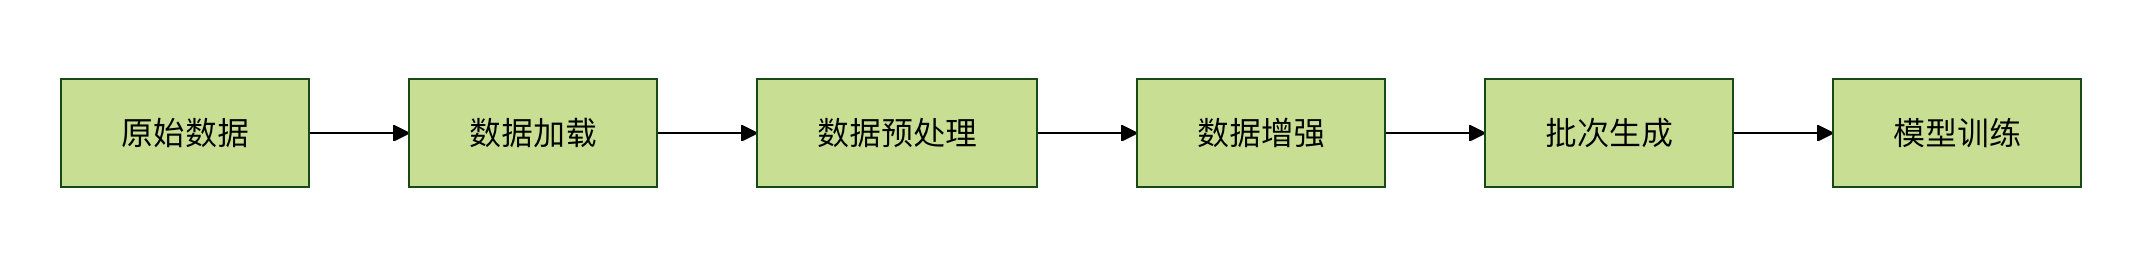
Concepts fondamentaux
API Dataset
L'API Dataset de TensorFlow est l'outil central pour construire des pipelines de données. Elle fournit diverses interfaces de sources de données et opérations de transformation :
Exemple
# Créer un Dataset à partir de la mémoire
data = tf.data.Dataset.from_tensor_slices([1, 2, 3])
# Créer à partir d'un fichier texte
text_data = tf.data.TextLineDataset(["file1.txt", "file2.txt"])
# Créer à partir de TFRecord
tfrecord_data = tf.data.TFRecordDataset("data.tfrecord")
Techniques de prétraitement des données
Les opérations de prétraitement courantes incluent :
- Normalisation:
(x - mean) / std - Normalisation:
(x - min) / (max - min) - Encodage one-hot:
tf.one_hot() - Remplissage/Troncation:
tf.keras.preprocessing.sequence.pad_sequences
Étapes de construction du pipeline
1. Chargement des données
Choisissez la méthode de chargement appropriée en fonction de la source de données :
Exemple
def load_image(path):
img = tf.io.read_file(path)
img = tf.image.decode_jpeg(img, channels=3)
return tf.image.resize(img, [256, 256])
image_dataset = tf.data.Dataset.list_files("images/*.jpg")
image_dataset = image_dataset.map(load_image)
2. Prétraitement des données
Utilisermap()méthode pour appliquer la fonction de prétraitement :
Exemple
return image / 255.0 # Normaliser sur la plage 0-1
normalized_dataset = image_dataset.map(normalize)
3. Augmentation des données
Techniques d'augmentation courantes utilisées pendant l'entraînement :
Exemple
image = tf.image.random_flip_left_right(image)
image = tf.image.random_brightness(image, max_delta=0.2)
return image
augmented_dataset = normalized_dataset.map(augment)
4. Traitement par lots
Configurer la taille du lot et la prélecture :
Exemple
train_dataset = augmented_dataset.batch(BATCH_SIZE)
train_dataset = train_dataset.prefetch(tf.data.AUTOTUNE)
Techniques d'optimisation avancées
Stratégies d'optimisation des performances
| Stratégie | Méthode | Effet |
|---|---|---|
| Parallélisation | num_parallel_calls=tf.data.AUTOTUNE |
Accélérer le chargement des données |
| Préchargement | prefetch(buffer_size=tf.data.AUTOTUNE) |
Réduire le temps d'attente |
| Mise en cache | cache() |
Éviter les calculs répétés |
Exemple
.map(load_image, num_parallel_calls=tf.data.AUTOTUNE)
.cache()
.map(augment, num_parallel_calls=tf.data.AUTOTUNE)
.batch(32)
.prefetch(tf.data.AUTOTUNE))
Gestion de la mémoire
Lors de la gestion de grands ensembles de données :
- Utiliser
TFRecordformat de stockage des données - Traitement fragmenté :
dataset.shard(num_shards, index) - Traitement en flux : éviter
cache()fichiers volumineux
Exemple pratique : pipeline de classification d'images
Flux complet de traitement des données de classification d'images :
Exemple
# 1. Charger les données
dataset = tf.data.Dataset.list_files(f"{image_dir}/*/*.jpg")
# 2. Analyser et prétraiter
def process_path(file_path):
label = tf.strings.split(file_path, os.sep)[-2]
image = load_image(file_path)
return image, label
dataset = dataset.map(process_path, num_parallel_calls=tf.data.AUTOTUNE)
# 3. Augmentation pendant l'entraînement
if is_training:
dataset = dataset.map(
lambda x, y: (augment(x), y),
num_parallel_calls=tf.data.AUTOTUNE
)
# 4. Optimiser la configuration
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.AUTOTUNE)
return dataset
Problèmes courants et solutions
Dépannage des goulots d'étranglement de performance
Faible utilisation du CPU
- Augmentez
num_parallel_calls - Utiliser
interleave()Paralléliser les E/S
- Augmentez
Faible utilisation du GPU
- Augmentez
prefetch_buffer_size - Vérifier si la taille du lot est appropriée
- Augmentez
Gestion du déséquilibre des données
Exemple
dataset = dataset.apply(
tf.data.experimental.sample_from_datasets(
[class1_ds, class2_ds],
weights=[0.7, 0.3]
)
)
Recommandations de bonnes pratiques
1. Principes de conception de pipeline
- Placez les opérations chronophages dans les premières étapes
- Gardez les opérations de prétraitement déterministes
- Désactivez l'augmentation de données pour l'ensemble de validation
2. Outils de surveillance
Exemple
tf.data.experimental.latency_stats()
3. Compatibilité des versions
- Pour TF 2.x, il est recommandé d'utiliser
tf.dataAPI - Éviter de mélanger
feed_dictapproches
En concevant correctement le pipeline de données TensorFlow, vous pouvez augmenter la vitesse d'entraînement de 2 à 5 fois tout en gardant le code propre et maintenable.
Autres extensions