Conseils de réglage des modèles TensorFlow
Le réglage des modèles est une partie cruciale du flux de travail d'apprentissage automatique ; il affecte directement les performances finales du modèle. Dans TensorFlow, nous pouvons utiliser diverses méthodes techniques pour améliorer la précision et la capacité de généralisation du modèle.
Pourquoi le réglage des modèles est nécessaire
- Les modèles initiaux ne sont souvent pas idéaux: Le premier modèle entraîné souffre souvent de sous-apprentissage ou de surapprentissage
- Optimisation de l'utilisation des ressources: Grâce au réglage, de meilleures performances peuvent être obtenues avec les mêmes ressources de calcul
- Adéquation aux exigences métier: Différents scénarios d'application ont des exigences différentes pour les modèles (par exemple, précision vs. vitesse)
1.2 Principales directions de réglage
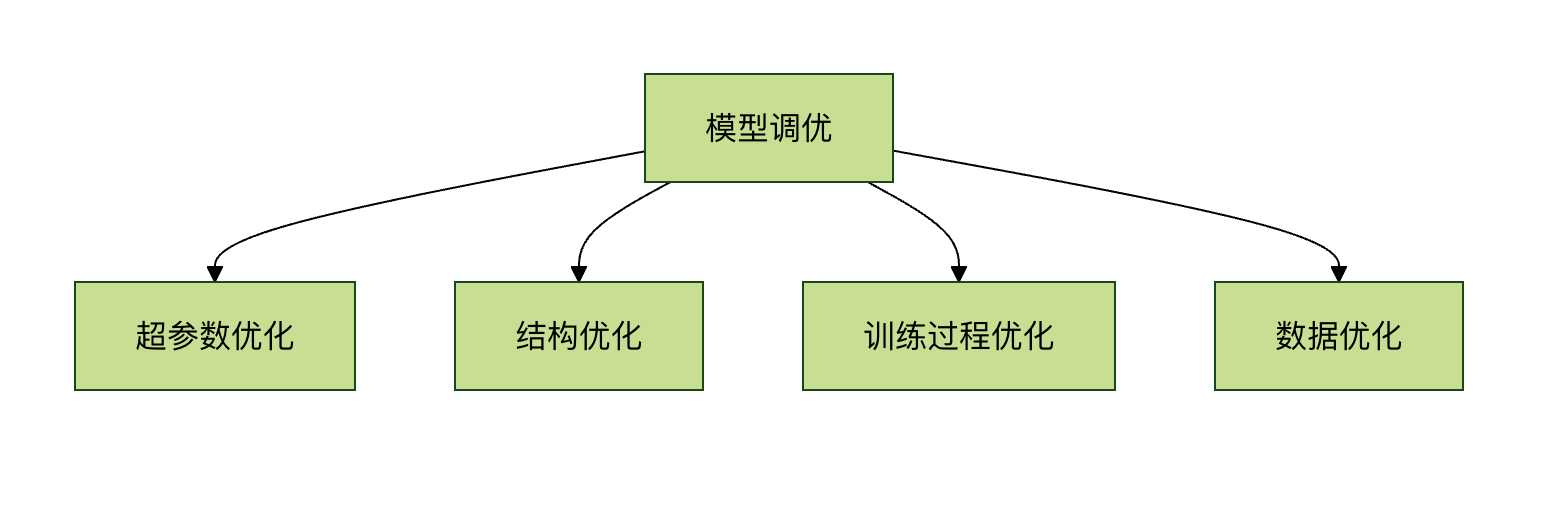
Techniques de réglage des hyperparamètres
Ajustement du taux d'apprentissage
Le taux d'apprentissage est l'un des hyperparamètres les plus critiques, affectant directement la vitesse de convergence du modèle et sa performance finale.
Réglage statique du taux d'apprentissage
Exemple
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
Stratégie de taux d'apprentissage dynamique
Exemple
initial_learning_rate = 0.1
lr_schedule = tf.keras.optimizers.schedules.ExponentialDecay(
initial_learning_rate,
decay_steps=10000,
decay_rate=0.96,
staircase=True)
optimizer = tf.keras.optimizers.SGD(learning_rate=lr_schedule)
Recherche du taux d'apprentissage
Exemple
import keras_tuner as kt
def build_model(hp):
model = tf.keras.Sequential()
model.add(tf.keras.layers.Dense(10))
# Définir la plage de recherche du taux d'apprentissage
hp_learning_rate = hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])
model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=hp_learning_rate),
loss='mse')
return model
tuner = kt.RandomSearch(build_model, objective='val_loss', max_trials=5)
Sélection de la taille du lot
La taille du lot affecte la stabilité de l'entraînement et l'utilisation de la mémoire :
| Taille du lot | Avantages | Inconvénients |
|---|---|---|
| Petit lot (16-64) | Convergence rapide, bonne généralisation | Entraînement instable |
| Lot moyen (64-256) | Choix équilibré | Nécessite plus de mémoire |
| Grand lot (256+) | Entraînement stable | Peut rester bloqué dans des optima locaux |
Optimisation de la structure du modèle
Ajustement de la taille des couches et de la profondeur
Techniques d'ajustement de la largeur
Exemple
def build_model(hp):
model = tf.keras.Sequential()
# Rechercher le nombre optimal de neurones
hp_units = hp.Int('units', min_value=32, max_value=512, Pas=32)
model.add(tf.keras.layers.Dense(units=hp_units, activation='relu'))
model.add(tf.keras.layers.Dense(10))
model.compile(optimizer='adam', loss='mse')
return model
Stratégies d'ajustement de la profondeur
1. Commencez par un réseau peu profond et augmentez progressivement la profondeur.
2. Utilisez des connexions résiduelles (ResNet) pour résoudre le problème de disparition du gradient dans les réseaux profonds.
Exemple
def residual_block(x, filters):
raccourci = x
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Activation('relu')(x)
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Add()([shortcut, x])
return tf.keras.layers.Activation('relu')(x)
Techniques de régularisation
Dropout
Exemple
tf.keras.layers.Dense(128, activation='relu'),
tf.keras.layers.Dropout(0.5), # 50% des neurones seront désactivés aléatoirement
tf.keras.layers.Dense(10)
])
Régularisation L1/L2
Exemple
tf.keras.layers.Dense(64,
activation='relu',
kernel_regularizer=tf.keras.regularizers.l2(0.01))
Arrêt précoce
Exemple
monitor='val_loss',
patience=5, # Arrêter si la perte de validation ne s'améliore pas pendant 5 époques consécutives
restore_best_weights=True) # Restaurer les meilleurs poids
model.fit(x_train, y_train,
validation_data=(x_val, y_val),
époques=100,
callbacks=[early_stopping])
Optimisation du processus d'entraînement
Augmentation de données
Exemple
data_augmentation = tf.keras.Sequential([
tf.keras.layers.RandomFlip("horizontal"),
tf.keras.layers.RandomRotation(0.1),
tf.keras.layers.RandomZoom(0.1),
])
# Entraîner avec des données augmentées
model.fit(data_augmentation(x_train), y_train, epochs=10)
Normalisation par lots
Exemple
tf.keras.layers.Dense(64),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.Dense(10)
])
Écrêtage du gradient
Exemple
optimizer = tf.keras.optimizers.Adam(clipvalue=1.0)
Techniques avancées de réglage
Réglage automatisé des hyperparamètres
Exemple
tuner = kt.Hyperband(
build_model,
objective='val_accuracy',
max_epochs=10,
factor=3,
directory='my_dir',
project_name='intro_to_kt')
tuner.search(x_train, y_train, epochs=10, validation_data=(x_val, y_val))
best_model = tuner.get_best_models(num_models=1)[0]
Distillation de modèle
Exemple
teacher = tf.keras.models.load_model('teacher_model.h5')
# Définition du modèle étudiant
student = tf.keras.Sequential([...])
# Perte de distillation
def distillation_loss(y_true, y_pred, teacher_pred, temp=5.0):
return tf.keras.losses.kl_divergence(
tf.nn.softmax(teacher_pred/temp),
tf.nn.softmax(y_pred/temp))
Suggestions pratiques de réglage
- Établissez une base de référence: Commencez par entraîner un modèle simple comme référence.
- Ajustez un paramètre à la fois: Évitez de modifier plusieurs paramètres en même temps.
- Enregistrez les expériences: Utilisez TensorBoard ou MLflow pour suivre les expériences.
- Utilisation de l'ensemble de validation: Assurez-vous que l'ensemble de validation représente la distribution réelle des données.
- Tenez compte du coût de calcul: Équilibrez l'efficacité du réglage avec la consommation de ressources.
Exemple
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir="./logs")
model.fit(x_train, y_train, epochs=10, callbacks=[tensorboard_callback])
En appliquant systématiquement ces techniques de réglage, vous pouvez améliorer considérablement les performances des modèles TensorFlow. N'oubliez pas que le réglage des modèles est un processus itératif qui nécessite de la patience et une conception expérimentale rigoureuse.
Autres extensions