Environnement de production TensorFlow
En tant que framework d'apprentissage automatique de premier plan dans l'industrie, TensorFlow nécessite de prendre en compte de nombreux facteurs lors du passage d'un environnement expérimental à un environnement de production.
Cet article présentera de manière exhaustive les considérations clés pour TensorFlow dans un environnement de production, aidant les développeurs à construire des systèmes d'apprentissage automatique stables et efficaces.
1. Optimisation du modèle
1.1 Quantification du modèle
Exemple
# Exemple de quantification post-entraînement
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- Quantification en nombres entiers 8 bits: réduit la taille du modèle de 75%, améliore la vitesse d'inférence de 3-4 fois
- Quantification en virgule flottante 16 bits: amélioration des performances sur GPU, perte de précision minimale
- Quantification de plage dynamique: ne quantifie que les poids, les activations restent en virgule flottante pendant l'inférence
1.2 Élagage du modèle
Exemple
# Élagage à l'aide de TensorFlow Model Optimization Toolkit
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- Supprime les connexions neuronales ayant peu d'impact sur la sortie
- Réduit généralement les paramètres de 60% sans affecter significativement la précision
- Nécessite un fine-tuning pour récupérer une partie de la perte de précision
1.3 Distillation de modèle
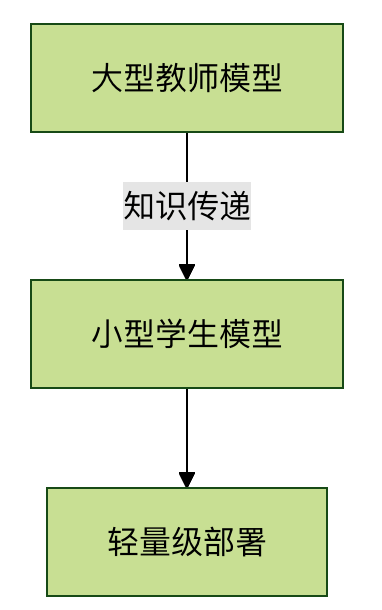
- Utilise un grand modèle pour guider l'entraînement d'un petit modèle
- Maintient plus de 90% de précision tout en réduisant le nombre de paramètres de 90%
- Particulièrement adapté aux scénarios de déploiement sur des appareils en périphérie
2. Architecture de déploiement
2.1 Comparaison des modes de service
| Méthode de déploiement | Latence | Débit | Utilisation des ressources | Scénarios applicables |
|---|---|---|---|---|
| TensorFlow Serving | Moyenne | Élevée | Moyenne | Services cloud, forte concurrence |
| TFLite | Faible | Moyenne | Faible | Appareils mobiles/IoT |
| ONNX Runtime | Moyenne | Élevée | Moyenne | Déploiement unifié sur plusieurs frameworks |
| Service gRPC personnalisé | Réglable | Réglable | Réglable | Scénarios à exigences particulières |
2.2 Architecture de microservices
Exemple
# Service de modèle simple construit avec Flask
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- Conteneurisation: Il est recommandé d'utiliser Docker pour empaqueter le modèle et l'environnement
- Découverte de services: Combinée à Kubernetes pour la mise à l'échelle automatique
- Intégration de la supervision: Système de supervision Prometheus + Grafana
3. Optimisation des performances
3.1 Accélération matérielle
Techniques d'optimisation GPU:
- Utiliser
tf.config.optimizer.set_jit(True)Activer la compilation XLA - Traiter les données d'entrée par lots (taille de lot typique 32-256)
- Utiliser l'entraînement en précision mixte (
tf.keras.mixed_precision)
Configuration TPU:
Exemple
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 Optimisation de graphe
Exemple
# Optimisation de la configuration de session
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- Pliage de constantes
- Fusion d'opérations
- Élimination du code mort
- Optimisation de la mémoire
4. Surveillance et maintenance
4.1 Indicateurs clés de surveillance
Métriques système:
- Utilisation GPU/CPU
- Utilisation de la mémoire
- Latence des requêtes (P50/P90/P99)
Métriques du modèle:
- Distribution de la confiance des prédictions
- Dérive de la distribution des données d'entrée
- Métriques de dégradation du modèle
4.2 Cadre de tests A/B
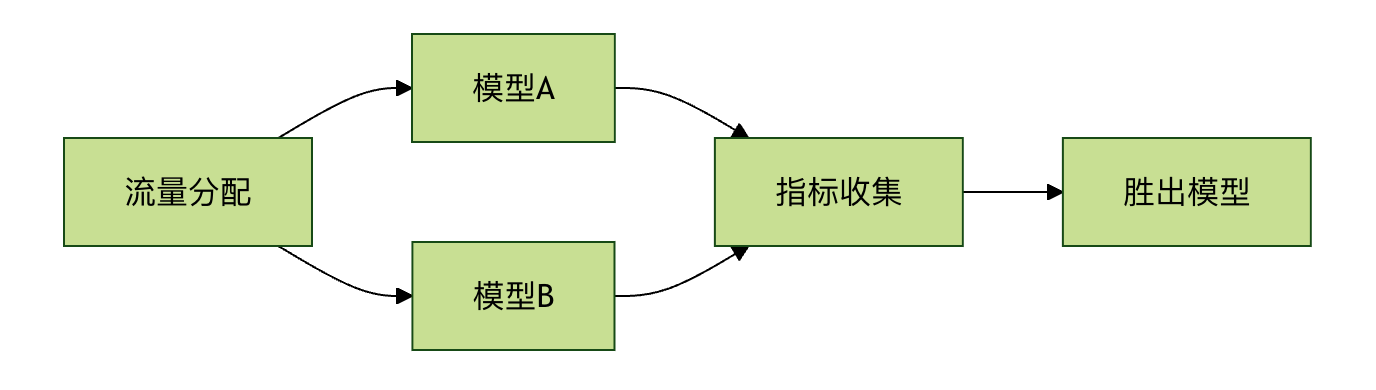
- Basculement progressif du trafic (5% → 50% → 100%)
- Comparaison multidimensionnelle des métriques (métriques métier + métriques techniques)
- Mécanisme de retour arrière automatique
5. Considérations de sécurité
5.1 Protection des modèles
- Utiliser
tf.saved_model.saveModèles chiffrés - Mettre en œuvre une technologie de tatouage des modèles
- Renouveler régulièrement les clés de déploiement
5.2 Validation des entrées
Exemple
# Exemple de validation des données d'entrée
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("L'entrée doit être un tableau numpy")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"La forme doit être {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("L'entrée contient des valeurs NaN")
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("L'entrée doit être un tableau numpy")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"La forme doit être {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("L'entrée contient des valeurs NaN")
- Vérification du type de données
- Validation de la plage numérique
- Filtrage des entrées anormales
6. Intégration et livraison continues
6.1 Conception de pipeline ML
Exemple
# Pipeline simple construit avec TFX
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- Entraînement automatisé du modèle
- Évaluation automatisée du modèle
- Déploiement automatisé du modèle
6.2 Stratégie de gestion de versions
- Version du modèle liée à la version du code
- Préservation des instantanés de données
- Enregistrements complets des expériences