Bibliothèque de modèles et sélection de modèles Ollama
Ce chapitre passera en revue de manière transversale comment lire la bibliothèque de modèles Ollama, le positionnement des principales familles de modèles et les compromis de précision de quantification, pour finalement vous donner une méthode pratique de sélection des modèles selon la tâche.
Si le modèle est choisi correctement, la moitié des problèmes de performance n'existent plus.
Comment lire la bibliothèque de modèles : système d'étiquettes de capacités
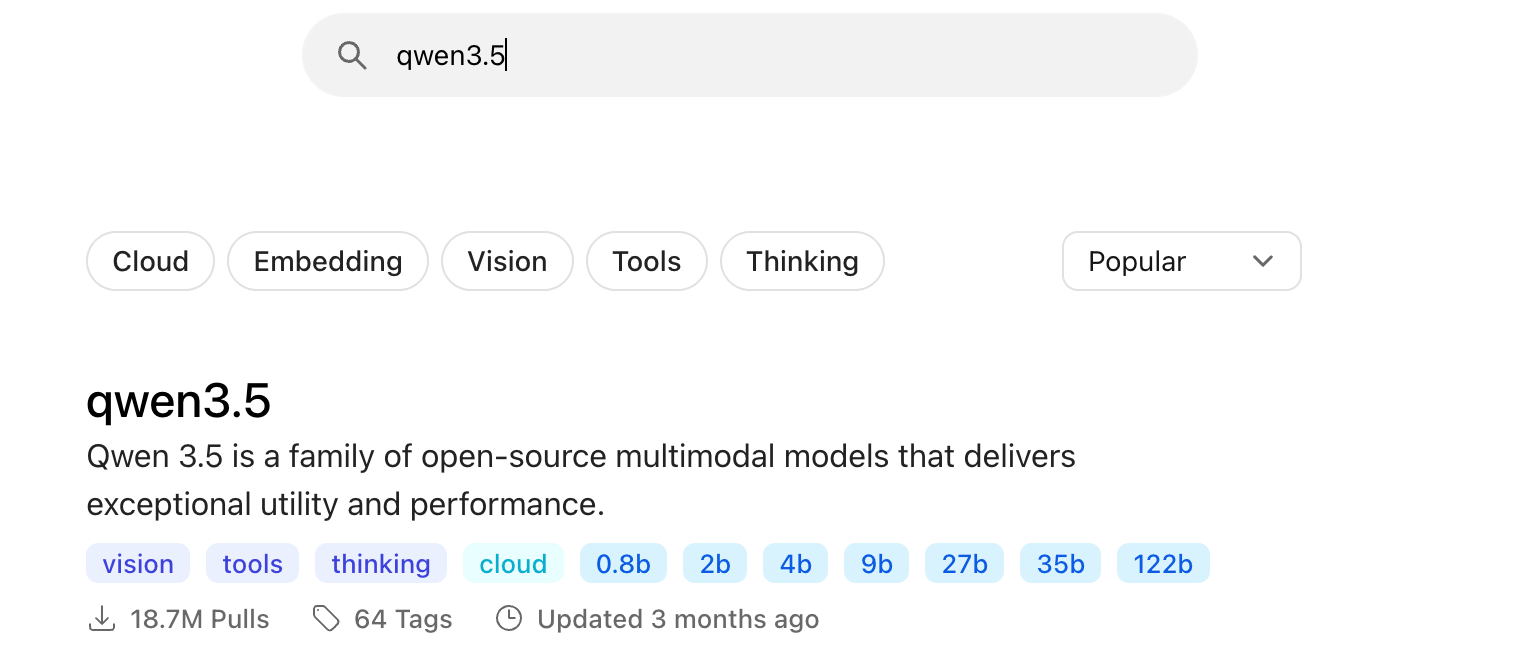
La bibliothèque de modèles Ollama (ollama.com/search) utilise un système d'étiquettes pour qualifier les capacités de chaque modèle. La première étape dans la sélection d'un modèle consiste à filtrer par étiquettes.
| Balise | Signification | Utilisation typique |
|---|---|---|
| vision | Prend en charge les entrées d'images | Questions-réponses sur images, compréhension de captures d'écran, reconnaissance de documents |
| tools | Prend en charge l'appel d'outils | Agent, appel de fonctions, automatisation |
| thinking | Prend en charge le mode réflexion | Mathématiques, logique, raisonnement complexe |
| plongement | Texte en vecteur | RAG, recherche sémantique, base de connaissances |
| nuage | S'exécute dans le cloud, aucun calcul local requis | Appeler des grands modèles lorsque la configuration locale est insuffisante |
En prenant qwen3.5 utilisé dans ce tutoriel comme exemple, il porte simultanément les tags vision, tools et thinking dans la bibliothèque de modèles, ce qui en fait un « généraliste ». C'est aussi pourquoi l'ensemble du livre le choisit comme modèle de test.
Chaque page de modèle liste également tous les tags, la taille de téléchargement, la fenêtre de contexte, les types d'entrée et la date de mise à jour. Passer une minute à les lire avant de télécharger peut permettre d'économiser beaucoup de temps d'essais et d'erreurs.
Aperçu des principales familles de modèles
Ollama n'est pas un modèle, mais une plateforme pour exécuter divers modèles open source. Voici plusieurs des familles les plus courantes actuellement :
| Famille | Producteur | Positionnement et caractéristiques | Scénarios adaptés |
|---|---|---|---|
| Qwen (Tongyi Qianwen) | Alibaba | Gamme complète de tailles, forte capacité en chinois, prise en charge complète du multimodal et de l'appel d'outils | Tâches en chinois, développement général, exemples dans ce tutoriel |
| DeepSeek | DeepSeek | La série de raisonnement (R1) excelle dans la chaîne de pensée | Mathématiques, logique, tâches nécessitant un raisonnement approfondi |
| Gemma | Excellentes performances dans les tailles légères, multimodal | Appareils à spécifications réduites, tâches légères | |
| Llama | Meta | Écosystème le plus large, ressources communautaires abondantes | Tâches générales, scénarios en anglais |
| GPT-OSS | OpenAI | Série open source d'OpenAI, prend en charge les niveaux de réflexion | Tâches générales, expérimentations d'Agent |
| Mistral | Mistral AI | Représentant du camp européen, petits modèles efficaces | Déploiement léger, multilingue |
La vitesse d'itération des modèles se mesure en semaines ; les tailles et capacités disponibles spécifiques dépendent des pages en temps réel de la bibliothèque de modèles. L'état d'esprit de sélection perdure au-delà des conclusions spécifiques : déterminez d'abord la tâche et les étiquettes de capacités, puis examinez la correspondance entre la taille et le matériel.
Précision de quantification : compromis entre taille et qualité
La quantification est une technique qui compresse les poids d'un modèle, de décimales de haute précision vers un stockage à faible largeur de bits. C'est la clé pour « exécuter de grands modèles sur de petits GPU ».
Pour différentes versions quantifiées d'un même modèle, la relation entre taille et qualité est approximativement la suivante :
| Precision | Taille relative | Performance de qualité | Scénarios applicables |
|---|---|---|---|
| fp16 / fp32 | Référence (la plus grande) | Sans perte | Poids d'origine avant entraînement et quantification |
| q8_0 | Environ 1/2 | Quasiment sans perte | À privilégier lorsque la VRAM est abondante |
| q4_K_M | Environ 1/4 | Légère baisse, meilleur rapport coût-performance | Le choix pour la grande majorité des déploiements locaux |
| q4_K_S | Légèrement plus petit que q4_K_M | Un peu inférieur à q4_K_M | Optimisation extrême de la VRAM |
Les modèles de la bibliothèque de modèles sont déjà quantifiés par défaut (généralement q4_K_M), prêts à l'emploi après téléchargement, sans avoir à vous en préoccuper.
Pour confirmer la précision réelle d'un modèle local, vous pouvez interroger le niveau de quantification à l'aide des commandes de la série show ou de l'API ; si vous souhaitez compresser vous-même un modèle fp16 en petite taille, utilisez simplement le paramètre quantize de la commande create. Le prochain chapitre Modelfile contient une démonstration complète.
Sélection des modèles par tâche
Transformez la « sélection de modèle » en un problème de classification : déterminez d'abord la tâche, puis comparez avec les recommandations.

| Tâche | Modèle recommandé | Référence matérielle | Remarques |
|---|---|---|---|
| Conversation quotidienne, écriture | qwen3.5:4b ~ 9b | Fonctionne avec 16GB de RAM | Meilleur choix coût-performance, tags de capacités complets |
| Génération de code | qwen3-coder | 24GB ou plus de VRAM recommandé | Nécessite un contexte de 64K lorsqu'il est utilisé avec des outils de codage |
| Mathématiques, raisonnement logique | mode de réflexion deepseek-r1 / qwen3.5 | Configuration standard selon la taille | Plus stable mais plus lent après activation de think |
| Visionnage d'images, compréhension des captures d'écran | qwen3.5 (vision native) | Identique à la taille de la conversation | Passer le chemin de l'image directement sur la ligne de commande |
| RAG, recherche sémantique | embeddinggemma / qwen3-embedding | Taille réduite, exigences faibles | Les modèles d'embedding ne peuvent pas être utilisés pour le chat |
Les modèles d'embedding et les modèles génératifs sont deux choses différentes : les premiers convertissent uniquement le texte en vecteurs pour la recherche et le calcul de similarité, et ne produisent pas de réponses textuelles. Lors de la construction d'une base de connaissances, vous avez besoin des deux ; ne les confondez pas.
Adapter la taille au matériel
La méthode d'élimination est plus utile que la mémorisation : utilisez d'abord une règle approximative pour déterminer si cela peut s'exécuter, puis affinez.
Règle approximative : la taille de téléchargement du modèle est approximativement égale à la configuration minimale requise en RAM/VRAM. Pour un fonctionnement réel, prévoyez un surcoût supplémentaire de 1-2GB ; plus la fenêtre de contexte est grande, plus vous devez en ajouter.
| Votre RAM / VRAM disponible | Taille maximale exécutable | Recommandation |
|---|---|---|
| 8GB | qwen3.5:0.8b ~ 2b | Orienté expérience, accepter le plafond de capacités |
| 16GB | qwen3.5:4b ~ 9b | Le point idéal pour un usage quotidien |
| 8GB VRAM (GPU dédié) | qwen3.5:9b | Conserver 100% GPU pour la vitesse |
| 24GB de VRAM | qwen3.5:27b / qwen3-coder | Tâches avancées de développement et de codage |
| 48GB VRAM ou plus | 35b+ et combinaisons multi-GPU | Le contexte par défaut augmente aussi automatiquement |
Une fois qu'il est en cours d'exécution, utilisezollama psVérification : si la colonne PROCESSOR indique 100% GPU, cela signifie que tout est en VRAM ; si un ratio mixte CPU/GPU apparaît, cela signifie que la VRAM est insuffisante et que le modèle est fractionné, ce qui provoque une baisse notable de vitesse. Dans ce cas, vous devriez passer à une taille plus petite plutôt que de persévérer.
Modèles cloud et mécanisme de retrait
Lorsque la puissance de calcul locale est insuffisante mais que vous souhaitez tout de même utiliser de très grands modèles, Ollama propose une troisième voie : les modèles cloud avec le tag cloud.
Exemples
ollama signin
# Exécutez des modèles cloud comme des modèles locaux, sans avoir besoin de télécharger les poids
ollama run qwen3.5:cloud
Les modèles cloud s'utilisent exactement de la même manière que les modèles locaux : les mêmes commandes, la même API, les mêmes intégrations d'outils, sauf que l'inférence se produit sur les serveurs d'Ollama.
Notez que les modèles cloud ont un mécanisme de retrait : l'équipe officielle retire périodiquement les anciens modèles et fournit des remplacements recommandés, en informant les utilisateurs par e-mail et via des annonces sur le site officiel. Les workflows automatisés qui dépendent d'un modèle cloud doivent prêter attention à ces notifications.
Autres extensionsLes modèles locaux ne sont pas du tout affectés par le mécanisme de retrait. Les poids téléchargés sur disque peuvent toujours être utilisés, ce qui est aussi la caractéristique qui rend les solutions purement locales les plus rassurantes pour les équipes.