Библиотека моделей Ollama и выбор модели
В этой главе будет представлен горизонтальный обзор того, как читать библиотеку моделей Ollama, позиционирования основных семейств моделей и компромиссов точности квантования, что в итоге даст вам практический метод выбора моделей по задаче.
Если модель выбрана правильно, половина проблем с производительностью исчезает.
Как читать библиотеку моделей: система тегов возможностей
Библиотека моделей Ollama (ollama.com/search) использует систему тегов для обозначения возможностей каждой модели. Первый шаг при выборе модели — фильтрация по тегам.
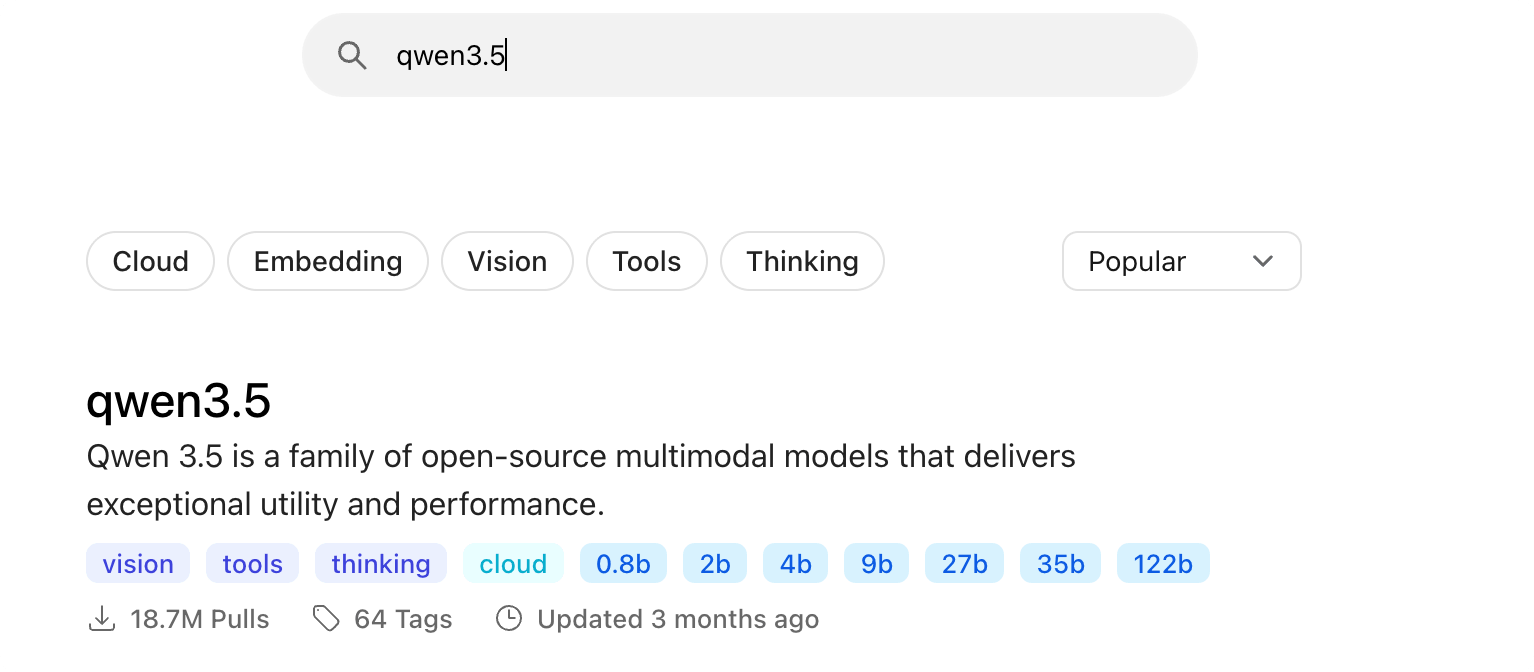
| Тег | Значение | Типичное использование |
|---|---|---|
| vision | Поддерживает ввод изображений | Вопросы и ответы по изображениям, понимание скриншотов, распознавание документов |
| tools | Поддерживает вызов инструментов | Агент, вызов функций, автоматизация |
| thinking | Поддерживает режим мышления | Математика, логика, сложные рассуждения |
| эмбеддинг | Текст в вектор | RAG, семантический поиск, база знаний |
| облако | Работает в облаке, локальные вычисления не требуются | Вызывать большие модели, когда локальной конфигурации недостаточно |
Возьмём в качестве примера qwen3.5, используемую в этом руководстве: в библиотеке моделей она одновременно несёт теги vision, tools и thinking, что делает её «универсалом». Именно поэтому вся книга выбирает её в качестве тестовой модели.
На странице каждой модели также перечислены все теги, размер загрузки, контекстное окно, типы входных данных и время обновления. Если потратить минуту на их чтение перед загрузкой, можно сэкономить много времени на пробах и ошибках.
Обзор основных семейств моделей
Ollama — это не модель, а платформа для запуска различных открытых моделей. Ниже приведены несколько самых распространённых на данный момент семейств:
| Семейство | Производитель | Позиционирование и особенности | Подходящие сценарии |
|---|---|---|---|
| Qwen (Tongyi Qianwen) | Alibaba | Полный диапазон размеров, сильные возможности для китайского языка, полная поддержка мультимодальности и вызова инструментов | Китайские задачи, общая разработка, примеры в этом руководстве |
| DeepSeek | DeepSeek | Серия рассуждений (R1) превосходно справляется с цепочками рассуждений | Математика, логика, задачи, требующие глубоких рассуждений |
| Gemma | Отличная производительность в лёгких размерах, мультимодальность | Устройства с низкими характеристиками, лёгкие задачи | |
| Llama | Meta | Самая широкая экосистема, обилие ресурсов сообщества | Общие задачи, сценарии на английском |
| GPT-OSS | OpenAI | Серия OpenAI с открытым исходным кодом, поддерживает уровни мышления | Общие задачи, эксперименты с агентами |
| Mistral | Mistral AI | Представитель европейского лагеря, эффективные небольшие модели | Легковесное развёртывание, многоязычность |
Скорость итерации моделей измеряется неделями; конкретные доступные размеры и возможности зависят от актуальных страниц библиотеки моделей. Подход к выбору важнее конкретных выводов: сначала определите задачу и теги возможностей, затем посмотрите на соответствие между размером и оборудованием.
Точность квантования: компромисс между размером и качеством
Квантование — это метод, который сжимает веса модели из десятичных чисел высокой точности в низкоразрядное хранилище. Это ключ к "запуску больших моделей на маленьких GPU".
Для разных квантованных версий одной и той же модели соотношение между размером и качеством примерно следующее:
| Precision | Относительный размер | Показатели качества | Применимые сценарии |
|---|---|---|---|
| fp16 / fp32 | Базовый (наибольший) | Без потерь | Исходные веса до обучения и квантования |
| q8_0 | Примерно 1/2 | Почти без потерь | Предпочтительно при большом объёме VRAM |
| q4_K_M | Около 1/4 | Небольшое снижение, лучшее соотношение цены и производительности | Выбор для подавляющего большинства локальных развёртываний |
| q4_K_S | Немного меньше, чем q4_K_M | Немного ниже, чем q4_K_M | Экстремальная оптимизация VRAM |
Модели в библиотеке моделей по умолчанию уже квантованы (обычно q4_K_M), готовы к использованию после загрузки, не нужно беспокоиться об этом самостоятельно.
Чтобы проверить фактическую точность локальной модели, можно узнать уровень квантования с помощью команд серии show или API; если вы хотите самостоятельно сжать модель fp16 до небольшого размера, просто используйте параметр quantize команды create. В следующей главе про Modelfile есть полный пример.
Выбор моделей по задаче
Превратите «выбор модели» в задачу классификации: сначала определите задачу, затем сравните с рекомендациями.

| Задача | Рекомендуемая модель | Справочник по оборудованию | Примечания |
|---|---|---|---|
| Повседневное общение, написание текстов | qwen3.5:4b ~ 9b | Работает с 16GB RAM | Лучший выбор по соотношению цена-качество, полный набор тегов возможностей |
| Генерация кода | qwen3-coder | Рекомендуется 24GB VRAM или больше | Требуется контекст 64K при использовании с инструментами для программирования |
| Математика, логические рассуждения | deepseek-r1 / qwen3.5 в режиме размышления | Стандартная конфигурация в зависимости от размера | Более стабильно, но медленнее после включения размышления |
| Просмотр изображений, понимание скриншотов | qwen3.5 (встроенное зрение) | То же, что размер диалога | Передайте путь к изображению прямо в командной строке |
| RAG, семантический поиск | embeddinggemma / qwen3-embedding | Малый размер, низкие требования | Модели эмбеддингов нельзя использовать для чата |
Модели эмбеддингов и генеративные модели — это две разные вещи: первые только преобразуют текст в векторы для поиска и вычисления сходства и не выводят текстовые ответы. При построении базы знаний нужны обе; не путайте их.
Сопоставление размера с оборудованием
Метод исключения полезнее заучивания: сначала используйте грубое правило, чтобы определить, сможет ли оно запуститься, затем уточните.
Грубое правило: размер загружаемой модели примерно равен минимальному требованию к RAM/VRAM. Для реальной работы зарезервируйте дополнительно 1-2GB на накладные расходы; чем больше окно контекста, тем больше нужно добавить.
| Ваша доступная RAM / VRAM | Максимальный размер, который можно запустить | Рекомендация |
|---|---|---|
| 8GB | qwen3.5:0.8b ~ 2b | Ориентировано на опыт, примите потолок возможностей |
| 16GB | qwen3.5:4b ~ 9b | Золотая середина для повседневного использования |
| 8GB VRAM (выделенная GPU) | qwen3.5:9b | Оставить 100% GPU для скорости |
| 24GB VRAM | qwen3.5:27b / qwen3-coder | Продвинутые задачи разработки и программирования |
| 48GB VRAM или больше | 35b+ и комбинации из нескольких GPU | Контекст по умолчанию также увеличивается автоматически |
После запуска используйтеollama psПроверка: Если в столбце PROCESSOR указано 100% GPU, это означает, что всё находится в VRAM; если отображается смешанное соотношение CPU/GPU, это означает, что VRAM недостаточно и модель разделена, что вызывает заметное падение скорости. В этом случае следует переключиться на модель меньшего размера, а не терпеть.
Облачные модели и механизм вывода из эксплуатации
Когда локальных вычислительных ресурсов недостаточно, но вы всё ещё хотите использовать очень большие модели, Ollama предлагает третий путь: облачные модели с тегом cloud.
Примеры
ollama signin
# Запускайте облачные модели как локальные, без необходимости скачивать веса
ollama run qwen3.5:cloud
Облачные модели используются точно так же, как локальные модели: те же команды, тот же API, те же интеграции с инструментами, за исключением того, что инференс выполняется на серверах Ollama.
Обратите внимание, что для облачных моделей действует механизм вывода из эксплуатации: официальная команда периодически удаляет старые модели и предлагает рекомендуемые замены, уведомляя пользователей по электронной почте и через объявления на официальном сайте. Автоматизированным рабочим процессам, которые зависят от облачной модели, следует обращать внимание на такие уведомления.
Другие расширенияЛокальные модели совершенно не подвержены механизму вывода из эксплуатации. Веса, загруженные на диск, всегда можно использовать, и это также особенность, которая делает чисто локальные решения наиболее надёжными для команд.