Ollama Cloud : local et cloud hybride
Pas assez de VRAM locale mais vous voulez utiliser un modèle gigantesque avec des centaines de milliards de paramètres ? Ollama Cloud offre une troisième option : le modèle s'exécute sur des GPU cloud, tandis que votre code et votre chaîne d'outils ne ressentent aucune différence.
Ce chapitre présente le fonctionnement des modèles Cloud, l'accès direct à l'API, le mode purement local et le mécanisme de retrait, puis fournit une stratégie de sélection pour un usage hybride.
Qu'est-ce qu'un modèle Cloud
Un modèle Cloud est un nouveau type de modèle dans Ollama : les poids sont stockés dans le cloud d'Ollama, l'inférence est effectuée sur le cluster GPU officiel, et le côté local ne gère que la transmission des requêtes.
Il résout un problème très précis : les modèles open source phares avec des centaines de milliards de paramètres nécessitent souvent des centaines de GB de VRAM, ce qui rend le déploiement local impossible pour les particuliers et les petites équipes, alors que le besoin de les utiliser est bien réel.
Les modèles Cloud disponibles portent le tag cloud dans la bibliothèque de modèles. Prenons l'exemple de la famille qwen3.5 : la spécification phare est qwen3.5:cloud.
Quatre façons d'exécuter des modèles Cloud
Effectuez d'abord la préparation unique : inscrivez-vous et connectez-vous à votre compte Ollama, puis récupérez le tag cloud (ce n'est qu'un « pointeur » et cela ne télécharge pas les poids).
Connectez-vous avec votre compte Ollama (requis pour les modèles cloud) :
ollama signin
Saisissez votre e-mail dans la fenêtre de connexion qui s'ouvre dans le navigateur (si une vérification par téléphone est nécessaire plus tard, un numéro de téléphone chinois local fera l'affaire) :
La récupération du tag cloud se termine presque instantanément :
ollama pull qwen3.5:cloud
L'exécuter donne une expérience identique à celle des modèles locaux :
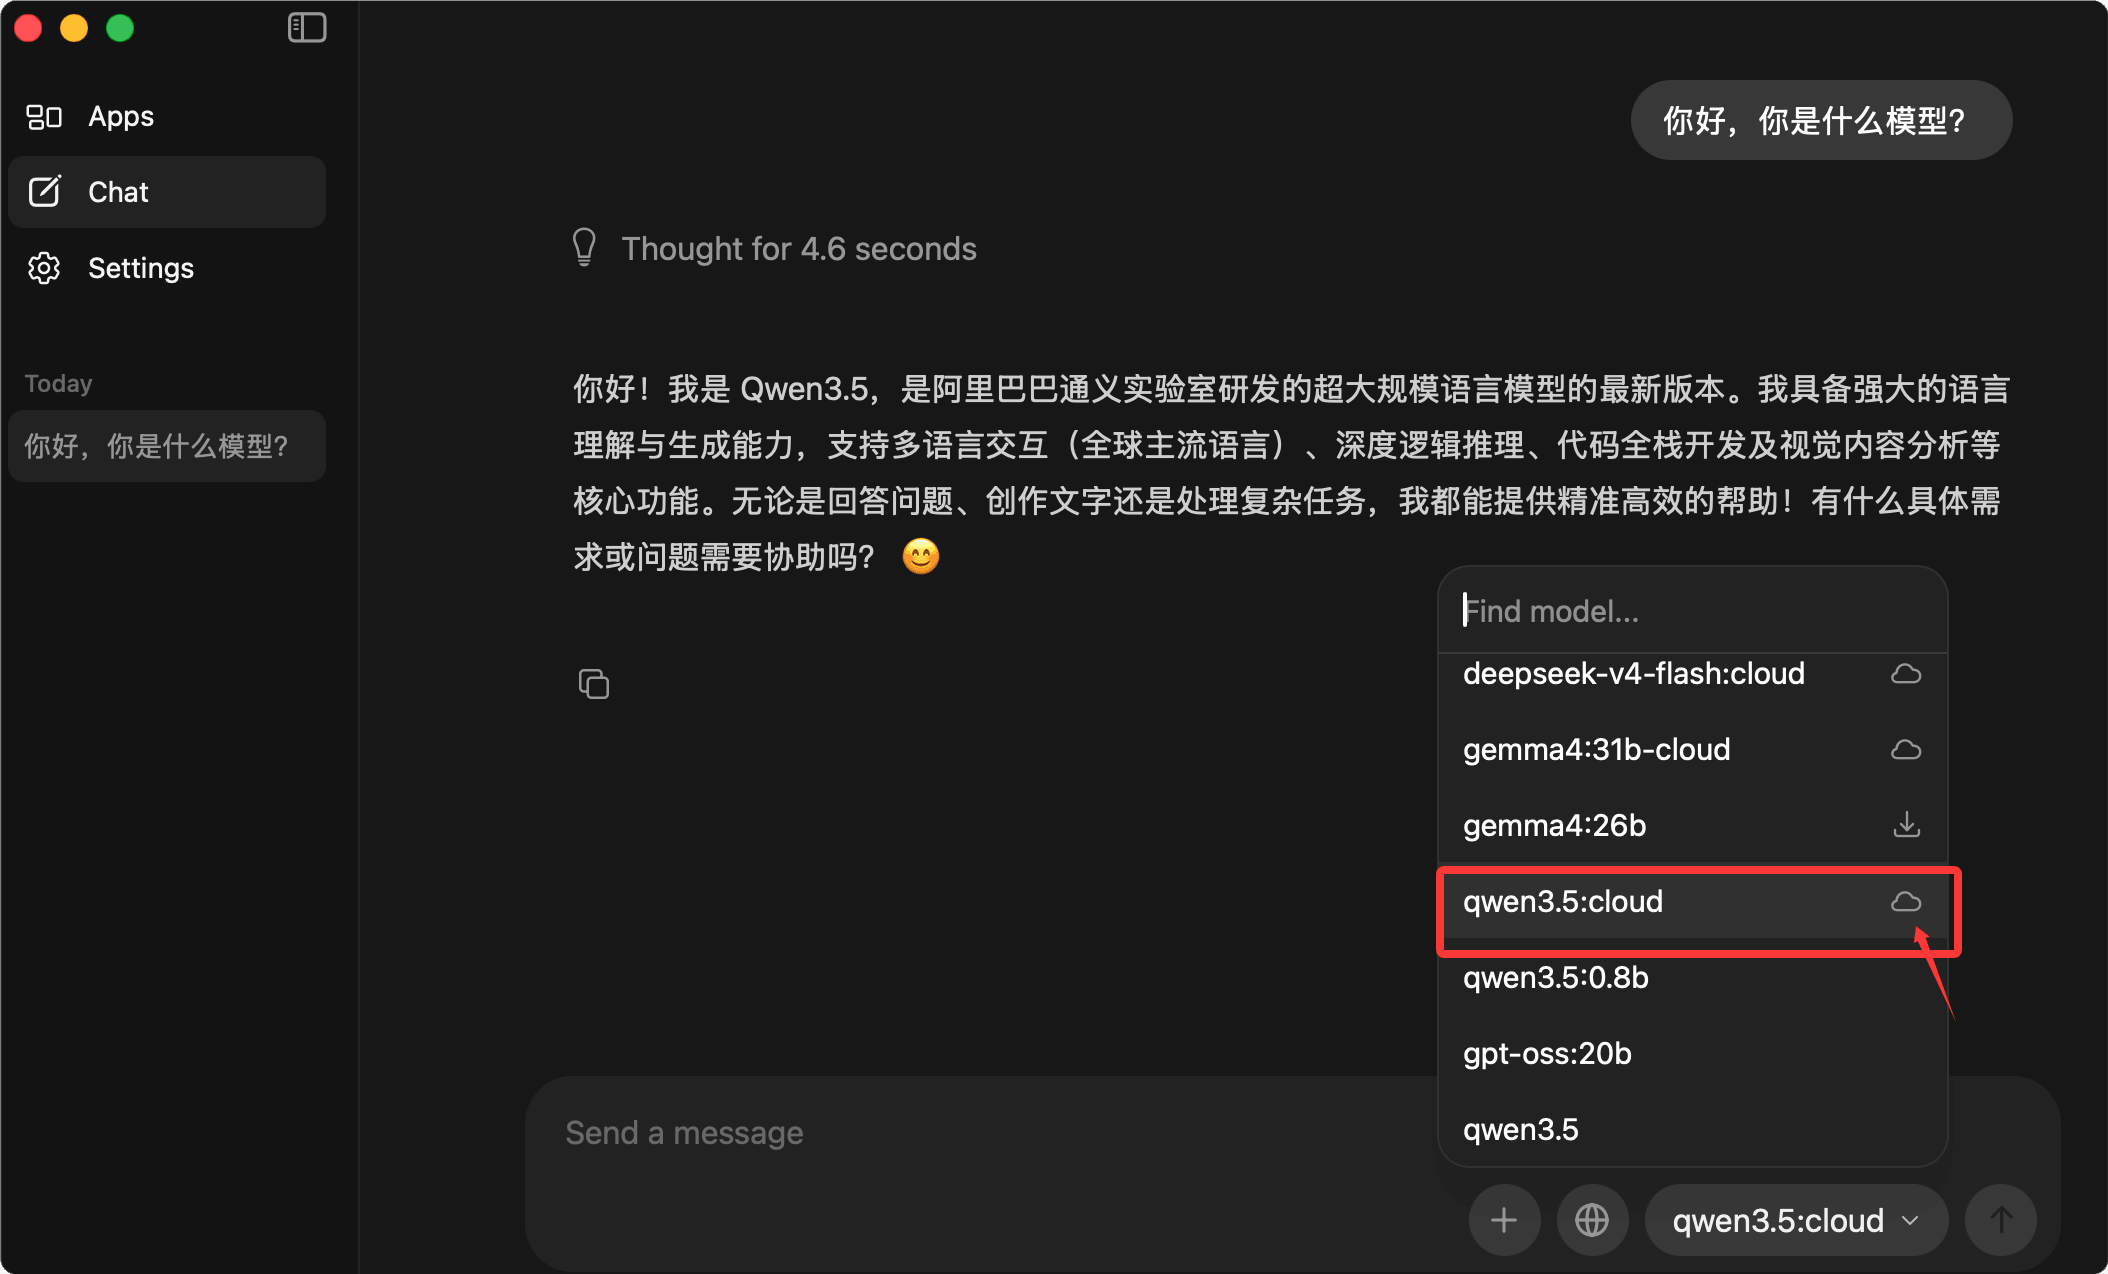
ollama run qwen3.5:cloud
Dans l'interface, vous pouvez voir une icône de nuage :
Appels Python
Exemple
# La seule différence avec les modèles locaux : le nom du modèle contient :cloud
stream = chat(
model='qwen3.5:cloud',
messages=[{'role': 'user', 'content': 'Présentez le tutoriel Python pour débutants en une phrase'}],
stream=True,
)
for chunk in stream:
print(chunk.message.content, end='', flush=True)
Appels JavaScript
Exemple
const response = await ollama.chat({
model: 'qwen3.5:cloud',
messages: [{ role: 'user', content: 'Présentez le tutoriel Python pour débutants en une phrase' }],
stream: true,
})
for await (const chunk of response) {
process.stdout.write(chunk.message.content)
}
appels curl
Exemple
"model": "qwen3.5:cloud",
"messages": [{ "role": "user", "content": "Présentez Python Rookie Tutorial en une phrase" }],
"stream": false
}'
Transfert transparent : l'API locale peut aussi appeler des modèles cloud
La partie élégante de Cloud est que la logique de transfert est entièrement gérée par le service local.

Lorsque vous demandez un modèle :cloud depuis localhost:11434, le service local gère automatiquement l'authentification et le transfert vers le cloud, sans que votre code d'application, vos outils Agent et vos intégrations d'éditeur n'aient besoin de le savoir.
Cela signifie que les intégrations existantes peuvent immédiatement profiter des capacités des grands modèles : changez le nom du modèle de Claude Code en qwen3.5:cloud, et la même chaîne d'outils passe à la spécification phare.
Il existe actuellement une limitation connue : les modèles Cloud ne prennent pas encore en charge la sortie structurée (le paramètre format). Les tâches nécessitant des contraintes JSON Schema doivent encore être confiées aux modèles locaux, ou analysées dans la couche application.
Connexion directe à ollama.com/api
En plus du transfert via le service local, vous pouvez aussi ignorer la partie locale et appeler directement l'API cloud, ce qui convient aux scénarios où le serveur n'a pas Ollama installé.
Créez d'abord une clé API sur la page des paramètres du site officiel, puis transmettez-la au format Bearer :
Exemple
curl https://ollama.com/api/chat \
-H "Authorization: Bearer $OLLAMA_API_KEY" \
-d '{
"model": "qwen3.5",
"messages": [{ "role": "user", "content": "Présentez Python Rookie Tutorial en une phrase" }],
"stream": false
}'
# Le cloud peut aussi lister les modèles disponibles
curl https://ollama.com/api/tags
Le SDK officiel prend également en charge la spécification de l'hôte et de l'en-tête d'authentification. Pour la méthode de connexion, consultez l'exemple Client(host=...) dans le chapitre Accès par programmation ; remplacez simplement l'hôte par https://ollama.com.
Les clés API n'expirent actuellement pas, mais vous pouvez les révoquer à tout moment sur la page de paramètres du site officiel ; elles sont équivalentes à vos identifiants d'utilisation du cloud, donc ne les committez pas dans des dépôts de code.
Mode purement local : désactiver complètement le cloud
Les équipes qui n'acceptent en aucun cas que leurs données quittent leur domaine peuvent désactiver complètement les fonctionnalités cloud d'Ollama, ce qui en fait un logiciel purement local.
Choisissez l'une des deux méthodes de désactivation, puis redémarrez Ollama pour que la modification prenne effet :
Exemple
# { "disable_ollama_cloud": true }
# Méthode 2 : variable d'environnement
OLLAMA_NO_CLOUD=1 ollama serve
# Une fois activé, le journal affichera : Ollama cloud disabled: true
La désactivation des fonctionnalités cloud entraîne également la perte des modèles cloud et des capacités de recherche en ligne, mais toutes les fonctionnalités des modèles locaux restent inchangées. Combinée au blocage sortant du pare-feu, vous pouvez construire un service de modèles totalement isolé physiquement.
Mécanisme de retrait des modèles cloud
Les modèles cloud ont un cycle de vie : à mesure que des modèles open source plus performants sont publiés, l'équipe officielle retire périodiquement les anciens modèles cloud et prévient les utilisateurs à l'avance par e-mail et via des annonces sur le site officiel, tout en proposant des remplacements recommandés.
L'annonce officielle prend la forme d'un tableau de correspondance « date de retrait - modèle - remplacement recommandé », par exemple, un modèle cloud sera mis hors ligne à une certaine date et migré vers une nouvelle version ; il suffit de changer le nom du modèle en conséquence.
Deux suggestions d'ingénierie :
Premièrement, lorsque vous référencez des modèles cloud dans des flux de travail automatisés, faites du nom de modèle un élément de configuration plutôt que de le coder en dur, afin que, lorsqu'un basculement lié au retrait se produit, vous n'ayez qu'à modifier la configuration.
Deuxièmement, préparez des modèles locaux alternatifs aux capacités équivalentes pour les activités critiques, afin de pouvoir basculer immédiatement en secours lorsqu'un modèle cloud est retiré ou que le réseau est anormal.
Le retrait ne concerne que les modèles cloud : les poids de modèle téléchargés localement sont toujours utilisables, c'est pourquoi ce tutoriel met toujours l'accent sur l'approche locale.
Stratégie de sélection : quand utiliser lequel
| Scénario | Solution recommandée | Raison |
|---|---|---|
| Tâches quotidiennes qui tiennent dans la VRAM | Modèle local | Coût nul, latence nulle, les données ne quittent jamais l'appareil |
| Données sensibles en matière de confidentialité | Modèle local (ou mode purement local) | Conforme et contrôlable |
| Besoins en modèles énormes / aucun appareil GPU | Modèle cloud | Aucun investissement matériel nécessaire, chaîne d'outils inchangée |
| Essayer de nouveaux modèles | Essayez d'abord le cloud, puis passez en local après avoir confirmé la valeur | Éviter d'acheter du matériel juste pour l'évaluation |
| Flux de travail automatisés à long terme | Local en principal + cloud en secours | Le cloud a un mécanisme de retrait ; le local n'a pas ce risque |
La bonne pratique pour une architecture hybride en une phrase : le trafic quotidien passe par le local, les tâches lourdes utilisent :cloud à la demande, et tous les noms de modèles vont dans les fichiers de configuration.
Autres extensions