Ollama-Modellbibliothek und Modellauswahl
Dieses Kapitel betrachtet vergleichend, wie man die Ollama-Modellbibliothek liest, die Positionierung der gängigen Modellfamilien und die Abwägungen bei der Quantisierungsgenauigkeit, und gibt Ihnen letztlich eine praktische Methode zur Auswahl von Modellen nach Aufgabe an die Hand.
Wenn das Modell richtig gewählt wird, gibt es die Hälfte der Leistungsprobleme nicht mehr.
So liest man die Modellbibliothek: Fähigkeits-Tag-System
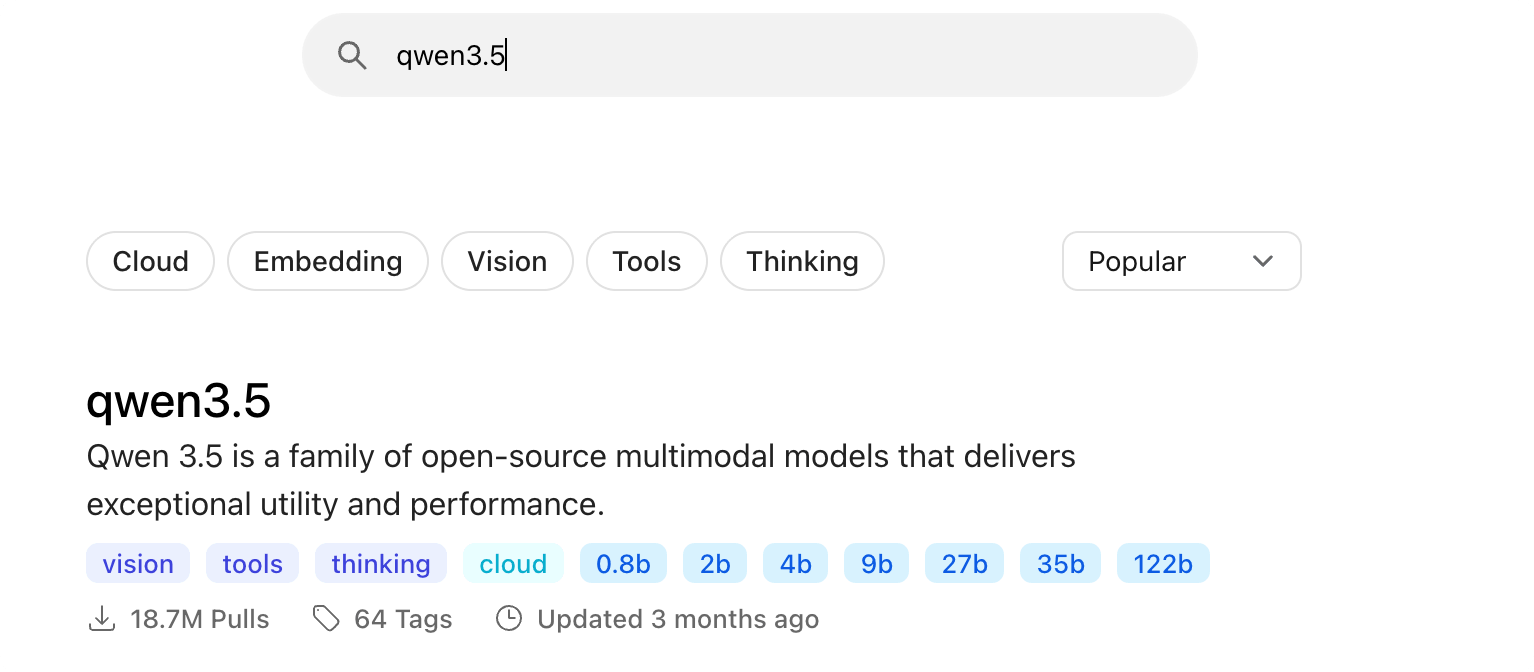
Die Ollama-Modellbibliothek (ollama.com/search) verwendet ein Tag-System, um die Fähigkeiten jedes Modells zu kennzeichnen. Der erste Schritt bei der Modellauswahl ist das Filtern nach Tags.
| Tag | Bedeutung | Typische Verwendung |
|---|---|---|
| vision | Unterstützt Bildeingabe | Fragen und Antworten zu Bildern, Verständnis von Screenshots, Dokumentenerkennung |
| tools | Unterstützt Tool-Aufrufe | Agent, Funktionsaufrufe, Automatisierung |
| thinking | Unterstützt Denkmodus | Mathematik, Logik, komplexes Schlussfolgern |
| Embedding | Text zu Vektor | RAG, semantische Suche, Wissensdatenbank |
| Wolke | Läuft in der Cloud, keine lokale Rechenleistung erforderlich | Große Modelle aufrufen, wenn die lokale Konfiguration nicht ausreicht |
Am Beispiel von qwen3.5, das in diesem Tutorial verwendet wird: Es trägt die Tags Vision, Tools und Thinking gleichzeitig in der Modellbibliothek und ist damit ein "Allrounder". Das ist auch der Grund, warum das gesamte Buch es als Testmodell wählt.
Jede Modellseite listet außerdem alle Tags, die Download-Größe, das Kontextfenster, die Eingabetypen und die Aktualisierungszeit auf. Eine Minute, die man vor dem Download mit dem Lesen verbringt, kann viel Trial-and-Error-Zeit ersparen.
Überblick über gängige Modellfamilien
Ollama ist kein Modell, sondern eine Plattform zum Ausführen verschiedener Open-Source-Modelle. Nachfolgend sind einige der derzeit gebräuchlichsten Familien aufgeführt:
| Familie | Hersteller | Positionierung & Merkmale | Geeignete Szenarien |
|---|---|---|---|
| Qwen (Tongyi Qianwen) | Alibaba | Vollständige Größenauswahl, starke chinesische Fähigkeiten, vollständige multimodale und Tool-Calling-Unterstützung | Chinesische Aufgaben, allgemeine Entwicklung, Beispiele in diesem Tutorial |
| DeepSeek | DeepSeek | Die Reasoning-Serie (R1) zeichnet sich durch Chain-of-Thought aus | Mathematik, Logik, Aufgaben, die tiefes Reasoning erfordern |
| Gemma | Hervorragende Leistung bei leichten Größen, multimodal | Geräte mit niedriger Spezifikation, leichte Aufgaben | |
| Llama | Meta | Breitestes Ökosystem, reichhaltige Community-Ressourcen | Allgemeine Aufgaben, englische Szenarien |
| GPT-OSS | OpenAI | OpenAIs Open-Source-Serie, unterstützt Thinking-Level | Allgemeine Aufgaben, Agent-Experimente |
| Mistral | Mistral AI | Vertreter des europäischen Lagers, effiziente kleine Modelle | Leichtgewichtige Bereitstellung, mehrsprachig |
Die Iterationsgeschwindigkeit von Modellen wird in Wochen gemessen; konkrete verfügbare Größen und Fähigkeiten richten sich nach den Echtzeitseiten der Modellbibliothek. Die Auswahl-Denkweise überdauert konkrete Schlussfolgerungen: Bestimmen Sie zuerst die Aufgabe und die Fähigkeits-Tags, und prüfen Sie dann die Übereinstimmung zwischen Größe und Hardware.
Quantisierungspräzision: Abwägung zwischen Größe und Qualität
Quantisierung ist eine Technik, die Modellgewichte von hochpräzisen Dezimalzahlen in Speicher mit geringer Bitbreite komprimiert. Sie ist der Schlüssel dazu, "große Modelle auf kleinen GPUs laufen zu lassen".
Für verschiedene quantisierte Versionen desselben Modells sieht die Beziehung zwischen Größe und Qualität ungefähr wie folgt aus:
| Precision | Relative Größe | Qualitätsleistung | Geeignete Szenarien |
|---|---|---|---|
| fp16 / fp32 | Baseline (größte) | Verlustfrei | Originalgewichte vor Training und Quantisierung |
| q8_0 | Etwa 1/2 | Nahezu verlustfrei | Bevorzugt, wenn VRAM reichlich vorhanden ist |
| q4_K_M | Etwa 1/4 | Leichte Verringerung, bestes Preis-Leistungs-Verhältnis | Wahl für die überwiegende Mehrheit lokaler Bereitstellungen |
| q4_K_S | Etwas kleiner als q4_K_M | Etwas niedriger als q4_K_M | Extreme VRAM-Optimierung |
Modelle in der Modellbibliothek sind standardmäßig bereits quantisiert (üblicherweise q4_K_M) und nach dem Download sofort einsatzbereit; Sie müssen sich nicht selbst darum kümmern.
Um die tatsächliche Präzision eines lokalen Modells zu bestätigen, können Sie die Quantisierungsstufe mithilfe der show-Befehlsserien oder der API abfragen; wenn Sie ein fp16-Modell selbst auf eine kleine Größe komprimieren möchten, verwenden Sie einfach den Parameter quantize des create-Befehls. Das nächste Modelfile-Kapitel enthält eine vollständige Demonstration.
Modelle nach Aufgabe auswählen
Verwandeln Sie die "Modellauswahl" in ein Klassifikationsproblem: Bestimmen Sie zuerst die Aufgabe, vergleichen Sie dann mit den Empfehlungen.

| Aufgabe | Empfohlenes Modell | Hardware-Referenz | Hinweise |
|---|---|---|---|
| Alltägliche Konversation, Schreiben | qwen3.5:4b ~ 9b | Läuft mit 16GB RAM | Bestes Preis-Leistungs-Verhältnis, vollständige Fähigkeits-Tags |
| Codegenerierung | qwen3-coder | 24GB oder mehr VRAM empfohlen | Erfordert 64K-Kontext bei Verwendung mit Coding-Tools |
| Mathematik, logisches Denken | deepseek-r1 / qwen3.5 Denkmodus | Reguläre Konfiguration je nach Größe | Stabiler, aber langsamer nach Aktivierung von Think |
| Bilder ansehen, Screenshots verstehen | qwen3.5 (native Vision) | Entspricht der Konversationsgröße | Bildpfad direkt auf der Kommandozeile übergeben |
| RAG, semantische Suche | embeddinggemma / qwen3-embedding | Kleine Größe, geringe Anforderungen | Embedding-Modelle können nicht zum Chatten verwendet werden |
Embedding-Modelle und generative Modelle sind zwei verschiedene Dinge: Erstere wandeln Text nur in Vektoren für Retrieval und Ähnlichkeitsberechnung um und geben keine Textantworten aus. Beim Aufbau einer Wissensdatenbank brauchen Sie beide; verwechseln Sie sie nicht.
Größe auf Hardware abstimmen
Das Ausschlussverfahren ist nützlicher als Auswendiglernen: Bestimmen Sie zuerst mit einer groben Regel, ob es ausgeführt werden kann, und nehmen Sie dann Feinjustierungen vor.
Grobe Regel: Die Downloadgröße des Modells entspricht ungefähr dem minimalen RAM/VRAM-Bedarf. Reservieren Sie für den tatsächlichen Betrieb zusätzlich 1-2GB Overhead; je größer das Kontextfenster, desto mehr müssen Sie hinzufügen.
| Ihr verfügbarer RAM / VRAM | Maximale Größe, die ausgeführt werden kann | Empfehlung |
|---|---|---|
| 8GB | qwen3.5:0.8b ~ 2b | Erfahrungsorientiert, akzeptiere die Leistungsobergrenze |
| 16GB | qwen3.5:4b ~ 9b | Optimale Wahl für den täglichen Gebrauch |
| 8GB VRAM (dedizierte GPU) | qwen3.5:9b | 100% GPU für Geschwindigkeit beibehalten |
| 24GB VRAM | qwen3.5:27b / qwen3-coder | Fortgeschrittene Entwicklungs- und Programmieraufgaben |
| 48GB VRAM oder mehr | 35b+ und Multi-GPU-Kombinationen | Der Standardkontext erhöht sich ebenfalls automatisch |
Sobald es läuft, verwenden Sieollama psÜberprüfung: Wenn die Spalte PROCESSOR 100% GPU anzeigt, bedeutet das, dass alles im VRAM liegt; erscheint ein gemischtes CPU/GPU-Verhältnis, reicht der VRAM nicht aus und das Modell wird aufgeteilt, was zu einem spürbaren Geschwindigkeitsverlust führt. In diesem Fall sollten Sie auf eine kleinere Größe umsteigen, statt es auszusitzen.
Cloud-Modelle und Außerbetriebnahme-Mechanismus
Wenn die lokale Rechenleistung nicht ausreicht, Sie aber dennoch sehr große Modelle verwenden möchten, bietet Ollama einen dritten Weg: Cloud-Modelle mit dem Tag cloud.
Beispiele
ollama signin
# Cloud-Modelle wie lokale Modelle ausführen, ohne Gewichte herunterladen zu müssen
ollama run qwen3.5:cloud
Cloud-Modelle werden genau wie lokale Modelle verwendet: dieselben Befehle, dieselbe API, dieselben Tool-Integrationen – nur dass die Inferenz auf den Servern von Ollama stattfindet.
Beachten Sie, dass Cloud-Modelle einem Außerbetriebnahme-Mechanismus unterliegen: Das offizielle Team nimmt regelmäßig alte Modelle außer Betrieb und stellt empfohlene Alternativen bereit; Benutzer werden per E-Mail und Ankündigungen auf der offiziellen Website informiert. Automatisierte Workflows, die von einem Cloud-Modell abhängen, sollten solche Mitteilungen beachten.
Andere ErweiterungenLokale Modelle sind vom Außerbetriebnahme-Mechanismus völlig unberührt. Auf die Festplatte heruntergeladene Gewichte können jederzeit verwendet werden – genau das macht reine lokale Lösungen für Teams besonders beruhigend.